高性能缓存架构
尽管我们可以采取多种方法来增强存储系统的表现,但在一些特定而复杂的业务场景中,仅仅依赖于提升存储系统的性能是不足以应对需求的。这样的场景主要包括:
当数据的产生需要复杂计算时,仅靠存储系统解决问题往往力不从心。以一个论坛为例,它可能需要在首页显示当前的在线用户数。假设论坛利用MySQL数据库来追踪用户状态,那么要实时计算在线用户总数,每次都需执行大量的“count(*)”操作。这种操作对MySQL的优化有限,尤其是在需要实时更新在线用户数时,MySQL的性能可能难以满足需求。
对于那些读操作远多于写操作的数据场景,存储系统很难发挥出最佳性能。多数在线服务,如微博、淘宝、微信等,都属于此类,其中读操作可能占到了业务量的90%以上。以微博为例,一个名人发布的微博可能吸引几千万人浏览。尽管对微博的写操作仅需一条insert语句,但每位浏览用户的访问都需要执行一次select操作。即便设置了索引,面对几千万的select请求,MySQL的压力仍旧巨大。
为了解决这些业务场景下的问题,缓存技术应运而生。缓存的核心思想是将那些可能会被重复读取的数据存储在内存中,这样数据只需被创建一次,便可以被多次使用,避免了每次都直接访问存储系统的必要。这种做法不仅提升了数据访问速度,也减轻了存储系统的负担。
缓存能够带来性能的大幅提升,以 Memcache 为例,单台 Memcache 服务器简单的 key-value 查询能够达到 TPS 50000 以上,其基本的架构是:
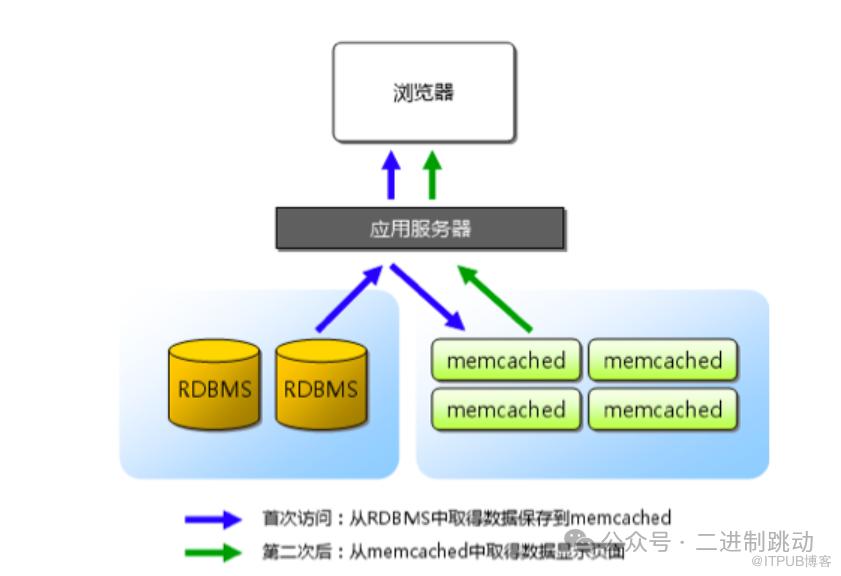
缓存虽然能够大大减轻存储系统的压力,但同时也给架构引入了更多复杂性。架构设计时如果没有针对缓存的复杂性进行处理,某些场景下甚至会导致整个系统崩溃。今天,我来逐一分析缓存的架构设计要点。
缓存穿透
缓存穿透是指缓存没有发挥作用,业务系统虽然去缓存查询数据,但缓存中没有数据,业务系统需要再次去存储系统查询数据。通常情况下有两种情况:
当存储系统中缺少所需数据时,缓存无法提供支持。在这种情况下,用户查询缓存时找不到对应的数据,每次都需要向存储系统发送查询请求,导致缓存未能减轻存储系统的访问压力。虽然通常情况下,业务中对不存在数据的查询请求并不会很频繁,但如果出现异常情况,比如黑客攻击,故意大量访问不存在的数据,可能会对存储系统造成过大的压力。
解决这种情况的方法相对简单,即如果查询存储系统未找到数据,则直接在缓存中设置一个默认值(可以是空值或具体值),以便在第二次查询时返回默认值,而无需再次访问存储系统。
存储系统中存在数据,但生成缓存数据所需的时间或资源较多。在这种情况下,即使缓存数据存在,但由于生成缓存数据需要大量时间或资源,当缓存失效时,访问压力仍然会全部转移到存储系统上。
典型的例子是电商平台的商品分页。由于商品数据庞大,不可能将所有数据都缓存起来,只能按照分页进行缓存。但由于难以预测用户会访问哪些分页,通常的做法是用户每次点击分页时,根据分页计算和生成缓存数据。然而,当竞争对手使用爬虫遍历数据时,系统可能会遇到性能问题。
具体场景包括:
分页缓存的有效期设置为1天,因为设置太长时间的话,缓存可能无法反映实际数据。
用户通常不会查看所有分页,访问集中在前10页,因此第10页之后的缓存可能会失效。
竞争对手每周爬取数据,爬虫会遍历所有分类的所有数据,导致大量缓存失效。
由于缓存中很多分页数据不存在,系统需要从数据库中生成缓存数据,这可能会消耗大量性能,导致数据库性能下降。
这种情况下并没有完美的解决方案,因为爬虫可能会遍历所有数据,而且其访问时间也是不确定的。一种应对策略是识别爬虫并禁止其访问,但这可能会影响SEO和推广。另一种方法是定期监控系统,发现问题后及时处理,因为爬虫通常不会对系统造成立即严重的影响,而是逐步增加访问量。
缓存雪崩
缓存雪崩描述的是一种情景,其中缓存同时失效导致系统性能急剧下降。在缓存过期并被清除后,所有的业务系统请求都需要重新生成缓存,这意味着必须重新访问存储系统并执行计算,这可能耗时较长。对于高并发的业务系统,这段时间内可能收到成百上千的请求。由于所有旧缓存都被清理,而新缓存尚未生成,处理这些请求的线程并不知道有其他线程正在生成缓存,因此所有请求都会尝试重新生成缓存,并重新访问存储系统,给存储系统带来巨大的压力。这不仅会减缓整个系统,还可能导致数据库宕机,引发连锁反应,最终导致系统崩溃。
解决缓存雪崩的方法主要包括更新锁和后台更新。
更新锁:通过对缓存更新操作加锁,确保只有一个线程能够更新缓存。未能获得更新锁的线程要么等待锁释放后重新读取缓存,要么返回空值或默认值。在分布式集群环境中,需要使用分布式锁(例如,通过ZooKeeper实现)以避免多台服务器上的多个线程同时更新缓存。
后台更新:通过后台线程更新缓存,而非业务线程,将缓存有效期设为永久,并定时更新。特殊情况下,如缓存系统内存不足时,需要频繁读取缓存以确保即时更新被“踢出”的数据,或通过业务线程在发现缓存失效时通知后台线程更新,保持缓存的及时性和准确性。
此外,对于缓存热点问题,可以通过复制多份缓存副本并分散请求到多个服务器上来减轻单个服务器的压力。对于极为热门的内容(如某明星微博),可以生成多份相同的缓存副本,通过在缓存键中添加编号来区分,随机选择副本进行读取。同时,为避免所有副本同时过期而引发雪崩,各副本的过期时间应随机分布在一个指定范围内。
这些缓存策略通常作为存储访问方案的一部分,可以通过程序代码中的中间层或独立的中间件来实现。
实现方式
由于缓存的各种访问策略和存储的访问策略是相关的,因此上面的各种缓存设计方案通常情况下都是集成在存储访问方案中,可以采用“程序代码实现”的中间层方式,也可以采用独立的中间件来实现。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

