高性能负载均衡:算法
负载均衡算法种类繁多,尽管具体实现细节各异,可以根据特定的业务需求进行自定义开发。但是,从算法的目标角度来看,它们大体上可以分类如下:
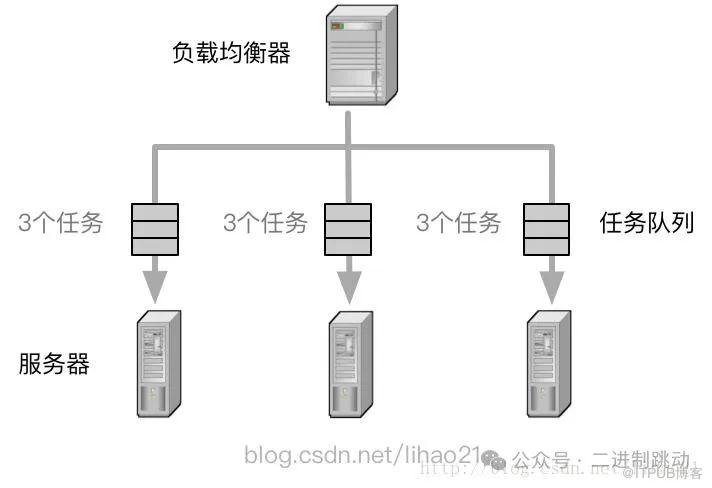
任务平均分配类:此类算法旨在将接收到的任务均匀地分配给各个服务器处理。这种“平均”可以基于任务的绝对数量,也可以基于比例或权重。
依据负载调整类:这类负载均衡算法基于服务器当前的工作负荷来分配任务。所指的“负载”不仅限于CPU负荷,也可以包括连接数、I/O使用率、网络吞吐量等指标,以评估服务器的当前压力。
性能优化类:该类负载均衡算法侧重于服务器的响应速度,优先将任务分配给响应时间最短的服务器,以达到性能最优。
基于Hash的类别:这类算法通过对任务中的关键信息进行Hash计算,确保具有相同Hash值的请求被发送到同一台服务器。常见的Hash策略包括源地址Hash、目标地址Hash、会话ID Hash、用户ID Hash等。
接下来我介绍一下负载均衡算法以及它们的优缺点。
轮询
在负载均衡系统中,轮询算法是一种基本的分配策略,它将接收到的请求依次分配给服务器列表中的每一台服务器。
轮询策略的核心特点是其简洁性,不需要考虑服务器的当前状态。例如:
如果某台服务器由于程序错误进入死循环,导致CPU负载异常升高,负载均衡系统将无法感知这一变化,并继续向该服务器分配请求。
同样,如果集群中引入了更高性能的32核服务器,与旧的16核服务器并存,负载均衡系统不会区分这些硬件的差异,仍然均等地分配任务。
需要指出的是,虽然负载均衡系统不会关注“服务器的具体运行状态”,关键是服务器是否“在运行”。服务器如果宕机或与负载均衡系统失去连接,系统会感知到这些变化并需要采取措施,如从分配列表中移除该服务器,避免继续向其发送任务,防止出现不合理的任务分配。
简而言之,轮询算法的“简单性”既是它的优点也是其局限性。

加权轮询
在负载均衡系统中,加权轮询是轮询策略的一个变种,旨在通过为服务器设置权重来解决处理能力不均的问题。权重通常根据服务器的硬件配置静态设定,尽管采用动态计算权重的方法可以更贴近实际业务需求,但这会增加系统的复杂度。
例如,在一个包含新旧服务器的集群中,如果新服务器配备了32核处理器,而老服务器只有16核,那么新服务器的处理能力可以认为是老服务器的两倍。基于这一假设,负载均衡系统可以按照2:1的比例向新服务器分配更多任务,以充分利用其更高的处理能力。
加权轮询通过考虑服务器的硬件差异来优化任务分配,但它仍然无法根据服务器的实时状态来调整任务分配。这意味着即使服务器的当前性能由于某些原因下降,这种方法也无法对此做出响应。
负载最低优先
在负载均衡系统中,一种常用的策略是将任务分配给当前负载最低的服务器。根据任务类型和业务场景的不同,服务器的负载可以通过多种指标来衡量。例如:
在四层网络负载均衡设备如LVS中,可以使用“连接数”来评估服务器的负载情况,连接数越多,服务器的压力越大。
对于七层网络负载均衡系统如Nginx,虽然其内置负载均衡算法不支持,但可以扩展以使用“HTTP请求数”来判断服务器状态。
如果是自行开发的负载均衡系统,可以根据业务的特性选择合适的压力指标。例如,对于CPU密集型的业务,可以使用“CPU负载”作为衡量标准;对于I/O密集型的业务,则可以使用“I/O负载”。
使用负载最低优先的算法可以解决轮询算法无法感知服务器实时状态的问题,但这种算法的复杂度也相应更高。例如:
最少连接数优先算法要求负载均衡系统跟踪每台服务器当前的连接数,适用于每个连接请求都由负载均衡系统转发给服务器处理的情况。然而,如果负载均衡与服务器之间使用固定的连接池,则不适宜使用这种算法。LVS可以采用此算法,但用于连接MySQL集群的负载均衡就不适合。
CPU负载最低优先的算法需要负载均衡系统收集各服务器的CPU负载数据,并决定是采用1分钟还是15分钟的负载数据作为判断标准,因为不同业务的最佳时间间隔不同。过短的间隔可能导致频繁波动,而过长的间隔可能在峰值时响应不够及时。
尽管负载最低优先算法在理论上能够有效解决轮询算法的局限,实现这种算法的复杂度却大幅增加。简单的轮询算法可能只需几行代码即可完成,而实现负载最低优先算法可能需要上千行代码,并且可能要求负载均衡系统和服务器都进行代码开发。如果算法设计不当或不适合业务需求,它本身可能成为性能的瓶颈或引起其他问题。因此,尽管负载最低优先算法看似理想,但在实际应用中的使用场景可能不如轮询(包括加权轮询)广泛。
性能最优类
性能最优优先类算法从客户端的视角出发,优先将任务分配给响应速度最快的服务器,以实现对客户端的最快响应。这种算法实质上同样是对服务器状态的感知,只不过是通过衡量服务器的响应时间这一外在标准来实现的。
与负载最低优先类算法相似,性能最优优先类算法的复杂度也很高,主要表现在以下方面:
负载均衡系统需要对每个服务器处理每个任务的响应时间进行收集和分析。在处理大量任务的场景下,这种数据的收集和统计本身可能会消耗大量性能。
为了降低统计的性能开销,可以采用抽样统计方法,即不对所有任务的响应时间进行统计,而是选择部分任务进行抽样。这种方法虽然可以减少性能消耗,但会增加操作的复杂性,因为需要确定一个适当的抽样率。抽样率设置过低可能导致统计结果不准确,抽样率过高则可能会引起较大的性能消耗,找到一个合适的抽样率是一个复杂的任务。
不论是进行全量统计还是采样统计,均需确定一个适合的统计周期,例如是在10秒、1分钟或5分钟内性能最优。这个周期没有一刀切的标准,需根据具体的业务需求来设定,这同样是一个复杂的过程,有时甚至需要系统上线后通过不断调整才能实现最佳性能配置。
Hash 类
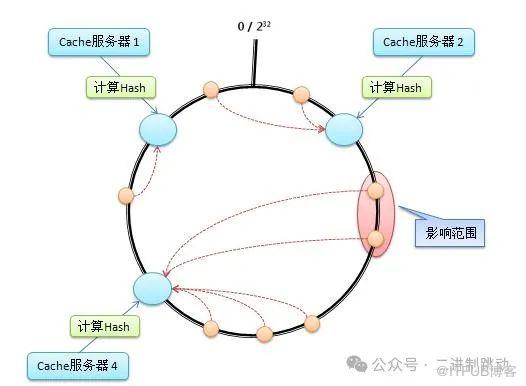
负载均衡系统通过对任务中某些关键信息进行哈希计算,把具有相同哈希值的请求分配给同一台服务器处理。这种做法主要用于满足一些特定的业务需求。例如:
源地址哈希:此方法将来自相同源IP地址的请求分配给同一台服务器,适用于需要处理事务或会话的业务场景。例如,在网上银行登录过程中,生成的会话信息是临时的,只需在单个服务器上临时保存,而不需要持久化。为确保用户在会话有效期内的每次请求都能被同一台服务器处理,可以采用源地址哈希的方法。
ID 哈希:将与特定ID关联的业务请求分配给相同的服务器,这里的ID通常指的是与临时数据相关的标识,如会话ID(session id)。例如,网上银行的登录场景,通过对会话ID进行哈希计算,可以确保在会话有效期内用户的所有请求都被路由到同一台服务器。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

