从0开始学架构:如何应对接口级的故障?
异地多活方案主要旨在防范系统级故障,比如机器宕机、数据中心故障或网络问题,这些尽管影响范围广,但其发生频率相对较低。然而,在日常业务运行中,存在另一类更频繁发生但影响相对较小的故障,即接口级故障,这是我们今天讨论的重点。
接口级故障通常表现为系统未完全宕机且网络连接正常,但业务运行出现问题。这包括响应速度慢、频繁的访问超时或多次出现异常错误,如用户面对的“无法连接数据库”的错误提示。这些问题通常由系统过载或负载过高引起,系统因此无法迅速响应业务请求,进而触发一系列连锁反应。一个典型的例子是数据库慢查询,这不仅耗尽服务器资源,还可能导致读写操作超时。从用户角度看,这些问题表现为网页加载缓慢,时而出现错误提示,时而又能正常访问,造成不一致的用户体验。
接口级故障通常由以下几种原因引起:
内部原因:
程序中的bug可能导致无限循环,或是某个特定的接口触发数据库的慢查询,以及程序逻辑设计不完善导致内存资源耗尽等问题。
外部原因:
遭受黑客攻击、大规模促销活动或抢购事件导致用户访问量暴增,超出正常水平数倍甚至数十倍;或是依赖的第三方系统突然增加请求量,或其响应速度变慢等。
处理接口级故障的核心策略与实施异地多活策略相似:首要任务是确保核心业务的连续性,并尽可能保障绝大多数用户的服务不受影响。
常见的实现降级的方式有:
系统后门降级基本上是在系统中预设一个特殊的入口,允许通过访问一个特定的URL来实施降级操作。这个URL通过其参数接收具体的降级命令。为了安全起见,此URL通常会包含某种形式的密码或安全验证。
虽然这种方法实现起来成本不高,它的主要劣势在于效率问题。在多服务器环境中,需要分别对每台服务器进行操作,这一过程可能既繁琐又耗时,特别是在需要迅速响应的故障处理情况下,这种方法可能效率不高。
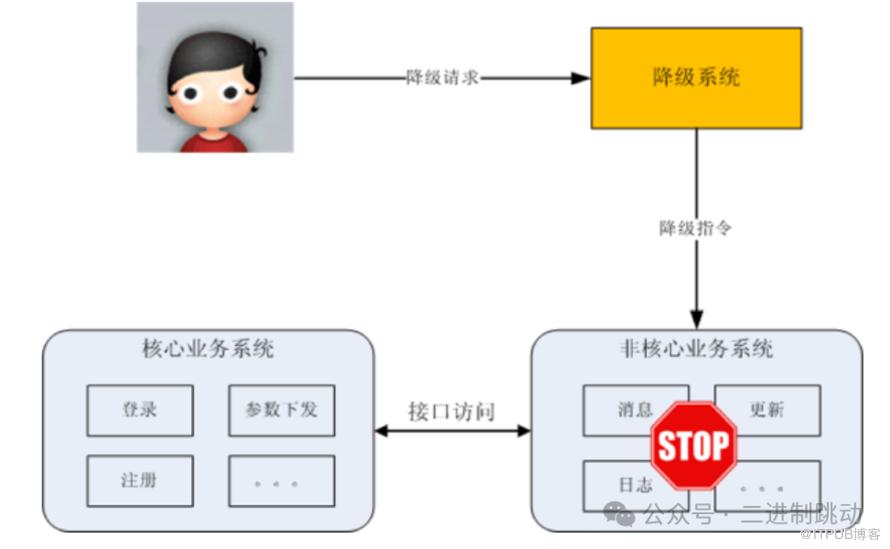
为了解决系统后门降级方式的缺点,将降级操作独立到一个单独的系统中,可以实现复杂的权限管理、批量操作等功能。其基本架构如下:
熔断
熔断和降级虽然从表面上看似乎都涉及到限制某些功能,但它们的目的和应用场景有明显区别。降级主要是为了处理系统内部的问题,而熔断则是用来应对外部依赖系统的故障。
设想这样一个情形:A服务的某个功能X依赖于B服务的接口。当B服务的接口响应变慢时,A服务的功能X也会相应变慢,这可能导致A服务的其他功能因为等待X功能的响应而变得缓慢或响应不及时。在这种情况下,就需要使用熔断机制,即A服务在发现调用B服务的特定接口变慢时,会主动停止调用该接口并快速返回错误,这样可以防止A服务的整体性能被拖垮。
实现熔断机制的关键之一是设置一个统一的API调用层。这个层负责对API调用进行监控和统计,如果API调用散布在代码的各个部分,就难以有效地实施熔断策略。
另一个关键点是熔断的阈值设计,比如设定在1分钟内如果有30%的请求响应时间超过1秒,则触发熔断。这些参数包括“1分钟”、“30%”和“1秒”,都会影响熔断的敏感度和效果。通常这些阈值需要基于业务分析进行初步设定,然后在实际运行中进行观察和调整以优化熔断机制的表现。
限流
降级和限流是两种常用的容错机制,用于应对系统故障,虽然它们似乎都涉及到限制某些功能,但实际上它们的目的和应用场景不同。降级是针对系统内部故障的一种应对策略,而限流则主要应对由于用户访问压力过大引起的系统故障。限流的基本思想是只让系统处理它能够承受的请求量,超过这个限度的请求则被拒绝。
虽然“拒绝”听起来可能有些负面,确保部分请求正常响应总比让所有请求都失败要好。
限流通常在系统内部实现,并大体可以分为两种类型:基于请求的限流和基于资源的限流。
基于请求的限流: 这种方法从外部请求的角度进行限流,常见的有两种实施方式:限制总量和限制时间内的请求数。
限制总量例如限制某直播间的总用户数或某秒杀活动的参与人数。
限制时间量则如每分钟允许的用户访问数或每秒的请求峰值。
这两种方式虽然实现简单,但挑战在于设定合适的阈值,这通常需要基于业务需求和系统性能进行仔细调整。实际操作中,找到合适的阈值需要通过性能压测确定,或者采用逐步调整法,即先设定一个初步的阈值,然后在实际运行中观察并根据需要进行调整。
基于资源的限流: 这种方法从系统内部的关键资源出发,设定资源使用的上限。常见的资源包括连接数、文件句柄、线程数和请求队列等。
例如,使用Netty服务器时,可以设置请求队列的最大长度,超过这个长度则拒绝新的请求。
-
另外,可以根据CPU的使用率来限流,如当CPU使用率超过某一阈值(如80%)时,开始拒绝新请求。
与基于请求的限流相比,基于资源的限流可以更直接地反映系统的当前负载情况,但同样面临如何确定关键资源及其阈值的挑战。这通常也是通过试验和持续优化的过程来完成的。
排队
排队实际上是限流的一个变种,限流是直接拒绝用户,排队是让用户等待一段时间,全世界最有名的排队当属 12306 网站排队了。排队虽然没有直接拒绝用户,但用户等了很长时间后进入系统,体验并不一定比限流好。
由于排队需要临时缓存大量的业务请求,单个系统内部无法缓存这么多数据,一般情况下,排队需要用独立的系统去实现,例如使用 Kafka 这类消息队列来缓存用户请求。
下面是 1 号店的“双 11”秒杀排队系统架构

其基本实现摘录如下:
在一个典型的抢购系统架构中,我们可以划分为以下三个主要模块:
排队模块:此模块负责接收来自用户的抢购请求,并将这些请求按照到达的顺序存入对应商品的队列中。每个参与秒杀的商品都拥有一个专属队列,其队列的长度可以基于预期的参与人数进行设定,并适当增加一些余量以处理额外的请求。
调度模块:该模块作为排队模块与服务模块之间的桥梁,负责监控服务模块的状态,并根据其处理能力动态地从队列中调度请求到服务模块。调度模块不仅仅是简单地转发请求,它还需要根据服务模块的当前负载调整抽取请求的频率和数量,从而确保系统的平稳运行。
服务模块:此模块是系统的核心,负责处理具体的业务逻辑并生成结果。它还需要与排队模块交互,将处理结果反馈回去。服务模块的设计需要高效且稳定,以便快速处理大量的并发请求。
通过这样的模块划分,系统能够更有效地管理大流量、高并发的抢购事件,确保每个环节都能够承担相应的压力,同时保持整体性能和响应速度。
如果你来设计一个整点限量秒杀系统,包括登录、抢购、支付(依赖支付宝)等功能,你会如何设计接口级的故障应对手段?
功能需求
先入先出(FIFO):确保请求按照到达顺序处理。
性能优化:快速处理入队和出队操作,以应对高并发情况。
-
扩展性:支持水平扩展,以便在流量激增时能够增加更多节点处理请求。
技术实现
消息队列:使用如Kafka、RabbitMQ或AWS SQS这样的消息队列服务作为排队机制的基础。
-
内存存储:利用如Redis这类内存数据库来实现轻量级的队列管理,确保高速访问和数据的暂时存储。
高并发处理
负载均衡:在排队模块前使用负载均衡器,将请求分发到不同的排队服务器,防止单点过载。
-
限流:在入队前进行限流,超出限制的请求可以直接返回抢购失败,避免过多请求压垮系统。
弹性设计
动态扩缩容:根据实时的流量监控,自动增加或减少处理请求的资源。
-
状态监控:实时监控队列长度和处理时间,以便及时发现潜在问题。
容错机制
重试逻辑:确保在处理请求时,如遇到失败可以重试,而不是直接丢弃请求。
-
数据持久化:将排队的请求持久化存储,即使系统重启也能恢复队列状态。
安全性
请求验证:确保进入队列的请求是经过身份验证的,防止恶意请求。
-
加密通讯:确保队列中的数据传输是安全的,避免被窃取。
用户体验
实时反馈:为用户提供排队进度的实时反馈,比如“您当前排在第xx位”。
超时处理:设置合理的等待时间上限,超时的请求可以选择自动退出排队或者给予用户选择的机会。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

