互联网架构模板的“存储层”技术
许多人对于BAT(百度、阿里巴巴、腾讯)的技术持有一种近乎崇拜的态度,认为这些系统的开发仅限于天才。然而,经过对架构本质、设计原则、设计模式和演进的深入讨论,我们可以看到,技术的神秘感实际上并不存在。事实上,是业务需求的持续推动使得技术得以发展,通过多年甚至十几年的逐步迭代,技术才达到了今天的复杂度和先进水平。
从技术视角来看,尽管BAT的业务各有不同,他们的技术架构在本质上却大同小异。进一步扩大视野,可以发现整个互联网行业的技术发展路径最终趋向于一致。
对于那些处于创业阶段或正努力打造下一个“BAT”级别企业的人来说,深入理解这种技术模式——或称为技术结构、技术架构——对个人和公司的发展都极为重要。
互联网标准技术架构如下所示,这一结构图基本覆盖了互联网公司的大多数技术要点。虽然不同公司在具体技术实施上有所差异,但他们的技术框架大致相同,不会超出这一基本结构的范畴。
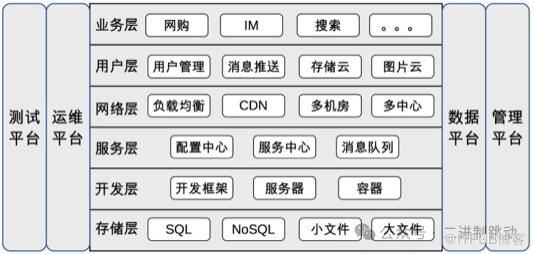
我将逐层介绍每个技术点的产生背景、应用场景、关键技术,有的技术点可能已经在前面的架构模式部分有所涉及,因此就不再详细展开技术细节了,而是将关键技术点分门别类,进而形成一张架构大图,让架构师对一个公司的整体技术架构有一个完整的全貌认知。
今天我们首先来聊聊互联网架构模板的“存储层”技术。
SQL
SQL,通常指的是关系数据库。过去几年中,NoSQL一度成为热议的话题,许多人误以为NoSQL意味着完全舍弃关系数据库,全面转向非关系型数据库。然而,随着时间的推移,经过实际应用的检验,业界逐渐认识到关系数据库不可能被完全淘汰。事实上,NoSQL并不代表“No SQL”,而是“Not Only SQL”,表明NoSQL是对传统SQL的一种补充。
因此,互联网行业仍然依赖于关系数据库。考虑到Oracle数据库昂贵且需要专人维护,互联网企业通常选择MySQL、PostgreSQL等开源数据库。这些数据库的优点是开源且免费,易于获取和使用;然而,它们的性能相较于商业数据库略有不足。随着互联网业务的不断扩展和性能需求的提升,企业不得不面临一个常见问题:为了满足性能需求,需要将数据分散至多个数据库实例中,这一需求同样适用于Oracle,只是出现的时间问题而已。
数据库分库分表虽然解决了性能问题,但也引入了新的复杂性:如何有效地分配和组织数据?这一问题的解决并不简单,如果每个业务单独处理,将导致资源重复使用和效率低下。
因此,互联网公司常见的做法是在业务发展到一定阶段后,将数据库分库分表等功能独立出来,形成中间件,如百度的DBProxy和淘宝的TDDL。这些技术虽然难度较高,但对于大型企业而言,能够实现自动化和平台化管理。对于中小企业,则建议采用开源解决方案,比如MySQL官方推荐的MySQL Router或360开源的数据库中间件Atlas。
随着公司业务的持续增长和规模的扩大,如果各业务部门都基于统一的数据库中间件独立部署自己的SQL集群,将引发资源利用率低下和维护成本高昂等问题。
大型公司在这种情况下通常会建立一个SQL存储平台,这个平台能够在不影响业务透明性的前提下,提供资源分配、数据备份、迁移、灾难恢复、读写分离、分库分表等服务,如淘宝的UMP(Unified MySQL Platform)系统。
NoSQL
首先,NoSQL与传统SQL在数据结构上存在显著差异,如Memcache的简单键值对结构、Redis的多样化数据结构以及MongoDB的文档型数据结构。此外,NoSQL系统通常将性能作为其主要优势之一。这些特点使得NoSQL能有效补充关系数据库的缺陷,因此在互联网行业,采用NoSQL技术已成为基本需求。
NoSQL解决方案一般内置了集群功能,如Memcache的一致性哈希集群、Redis 3.0的集群功能,使得初期应用NoSQL相对简单,不需像SQL数据库那样进行复杂的分库分表操作。通常情况下,公司在初始阶段不会把NoSQL封装成一个存储平台。但是,随着公司的快速发展,当例如Memcache的节点数达到成千上万时,构建NoSQL存储平台就显得尤为重要了。主要原因包括:存储平台可以通过集中管理显著提高运维效率;同时,优化资源利用率可以大幅度节省成本,例如,如果2000台机器的利用率提高了10%,则可以节省200台机器的需求,从而每年节省数十万元的开支。
因此,当NoSQL技术达到一定规模后,通常会基于NoSQL集群进一步发展成统一的存储平台。这样的平台主要提供以下功能:
资源动态按需分配:例如,同一台Memcache服务器可以根据不同业务的内存使用率动态分配。
资源自动化管理:新业务可以直接申请所需的Memcache缓存空间,而不必关心哪些具体的Memcache服务器正在服务。
故障自动化处理:如果某台Memcache服务器出现故障,另一台备份服务器可以立即接管,避免缓存数据大量丢失。
小文件存储
在互联网行业,除了关系型数据库管理的业务数据之外,还有大量用于展示的数据,如淘宝的商品图片和描述、Facebook的用户照片、新浪微博的微博内容等。这类数据通常具有三个特点:文件大小较小,通常不超过1MB;数量极为庞大,例如Facebook在2013年每天的照片上传量就达到了3.5亿张;以及访问频率非常高,Facebook的日访问量超过10亿次。
鉴于每个互联网业务都可能涉及到处理大量的小型数据,如果每个业务单独处理海量存储和访问需求,不仅效率低下,还会导致资源浪费和重复劳动。因此,创建一个与业务无关、统一的小文件存储平台成为自然而然的选择。
与SQL和NoSQL数据库不同,小文件存储的需求并不依赖于公司或业务的规模,即使是在业务的初期阶段就可以考虑实施。得益于开源运动的推进和近年来大数据技术的流行,基于开源解决方案封装一个小文件存储平台并不复杂。例如,可以使用HBase、Hadoop、Hypertable、FastDFS等作为小文件存储的基础技术,通过进一步封装这些开源平台,就能够创建适用的存储系统。
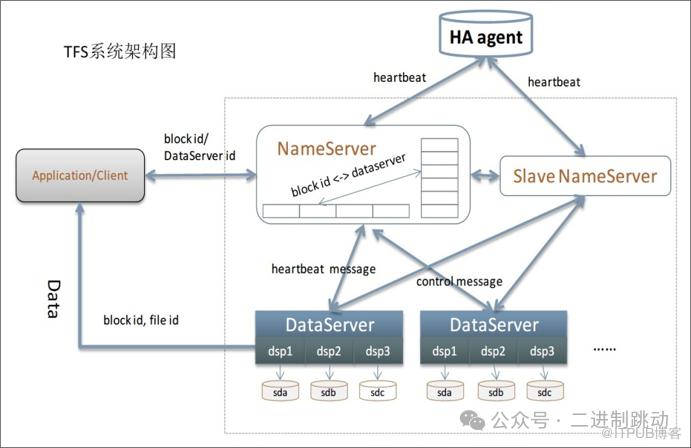
一些典型的小文件存储解决方案包括淘宝的TFS、京东的JFS、Facebook的Haystack等。这些系统显示了小文件存储平台在实际应用中的重要性和效率。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

