智能搜索引擎系统设计和实践
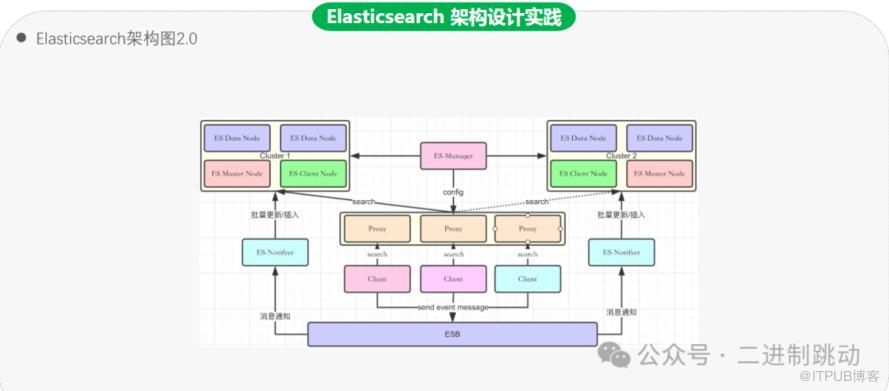
集群(Cluster)
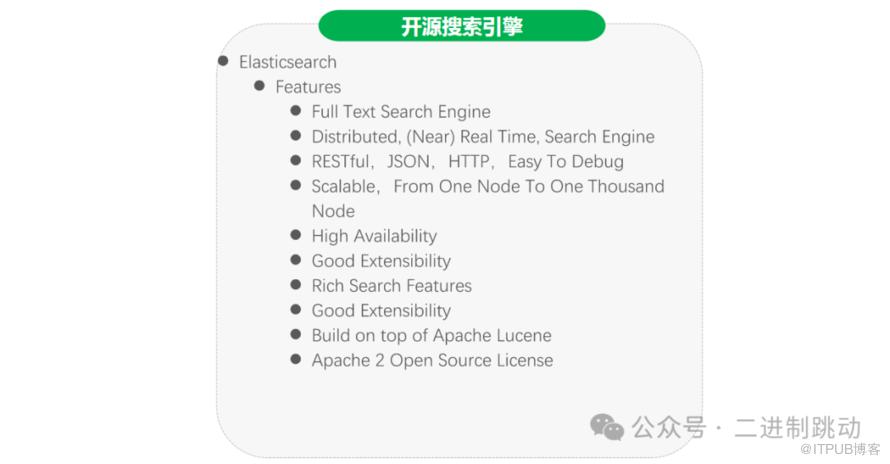
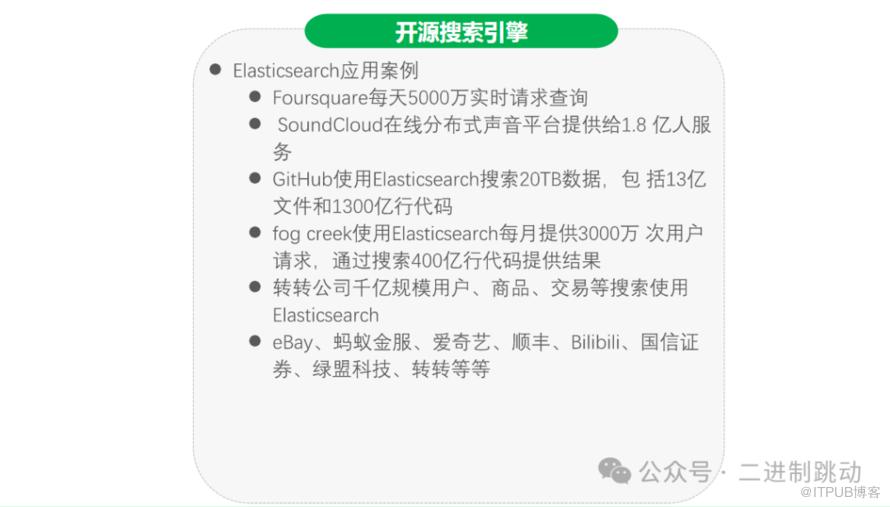
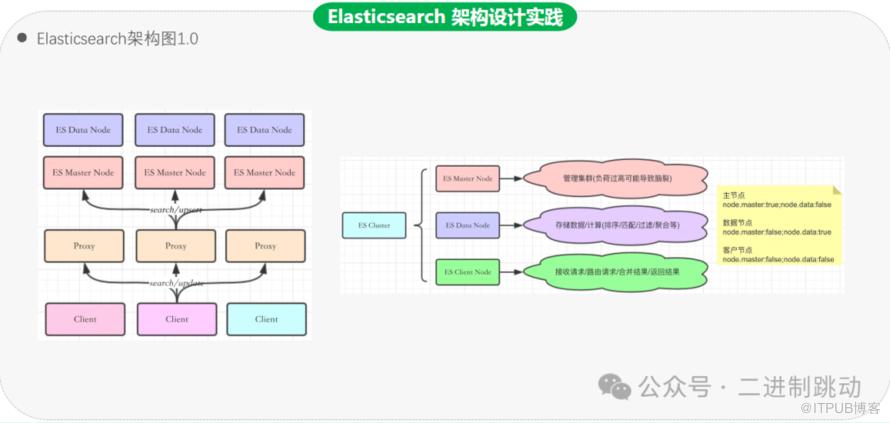
一个ElasticSearch集群由一个或多个节点(Node)组成,能够共同工作来提供分布式搜索和索引功能。
每个集群有一个唯一的名字,这个名字对于集群中的所有节点都必须相同。
节点(Node)
每个ElasticSearch实例(JVM实例)称为一个节点。
节点加入一个集群,通过配置文件或者动态加入。
节点可以有不同的角色(如主节点、数据节点、协调节点等),执行不同的功能。
索引(Index)
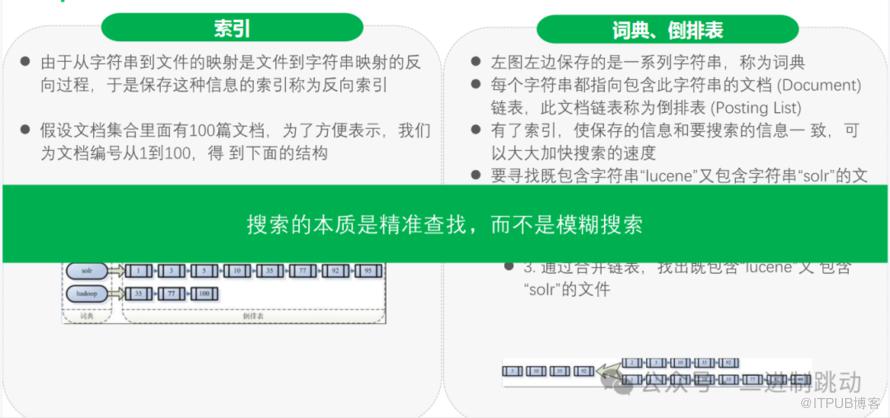
索引是具有相似特征的文档集合(类似于关系数据库中的数据库)。
每个索引有一个唯一的名字,用来引用这个索引进行文档的索引、搜索、更新和删除操作。
类型(Type)
在ElasticSearch 7.x及更高版本中,类型(Type)已经被移除,每个索引只能有一个类型。
在早期版本中,一个索引可以包含多个类型(Type),类似于关系数据库中的表。
文档(Document)
文档是ElasticSearch中可以被索引的最小数据单元,存储为JSON格式。
-
每个文档都有一个唯一的ID,并存储在一个索引中。
分片(Shard)
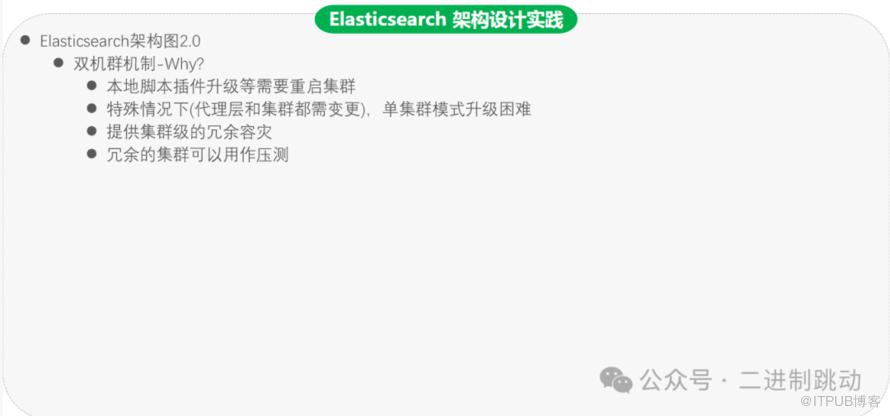
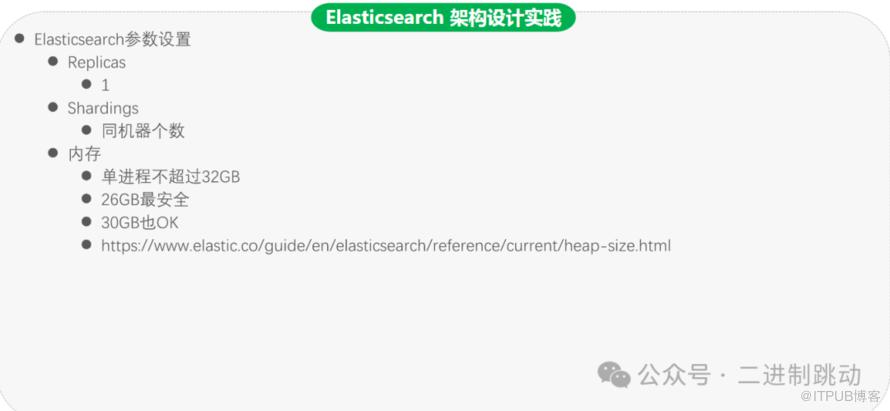
每个索引可以被划分成多个分片(Shard),每个分片是一个独立的Lucene实例。
分片可以是主分片(Primary Shard)或副本分片(Replica Shard)。
主分片负责处理索引和搜索请求,副本分片是主分片的备份,用于故障转移和负载均衡。
副本(Replica)
每个主分片可以有多个副本(Replica),用来提高系统的高可用性和扩展性。
副本分片和主分片一样,可以处理搜索请求,从而提高搜索性能。

数据分布和负载均衡
当一个文档被索引时,ElasticSearch会根据文档ID和分片数量,通过哈希算法将文档分配到某个主分片。
通过分片和副本,ElasticSearch实现了数据的分布式存储和负载均衡。
搜索和查询
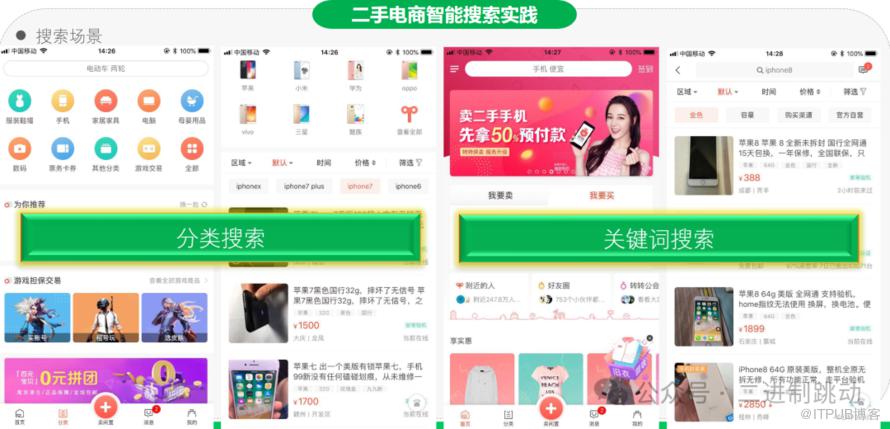
搜索请求可以发送到集群中的任何节点,节点会将请求转发到相应的分片上处理。
搜索结果从多个分片汇总后,返回给请求节点,再由请求节点返回给客户端。
索引和文档管理
新文档的索引请求会被路由到相应的主分片,主分片处理完索引操作后会将文档同步到副本分片。
-
当一个节点宕机或新节点加入时,ElasticSearch会自动进行数据的重新分配和均衡。


客户端层
iOS App / Android App:移动端应用,用户通过这些应用发起搜索请求。
网关层
网关层:接收来自移动端应用的搜索请求,并将请求传递给搜索透传层。
搜索透传层
请求解析:解析客户端发来的搜索请求。
ABTest:用于A/B测试,不同的请求可能被分配到不同的实验组,以测试不同的搜索策略。
实验策略管理:管理和应用各种实验策略,影响搜索结果的排序和展示。
业务干预:根据业务需求对搜索结果进行干预。
Query改写:对原始查询进行改写,以优化搜索效果。
结果封装:将搜索结果进行封装,以便返回给客户端。
统一Query改写服务
Query改写:集中处理查询改写。
分类预测:对查询进行分类预测,以选择合适的搜索策略。
统一召回服务
执行计划:制定并执行召回计划,选择最相关的搜索结果。
召回节点:从不同的数据节点中召回搜索结果。
统一预测服务
特征管理:管理用于预测的各种特征数据。
模型管理:管理用于预测的机器学习模型。
搜索访问代理层(排序)
排序:根据特定的排序算法对搜索结果进行排序。
搜索集群
ElasticSearch:实际存储和索引数据的搜索引擎,用于处理搜索查询并返回结果。
特征访问代理层(正排)
正排:处理特征访问和管理,将特征数据与查询匹配。
特征存储
ZZRedis:用于存储特征数据的Redis数据库。
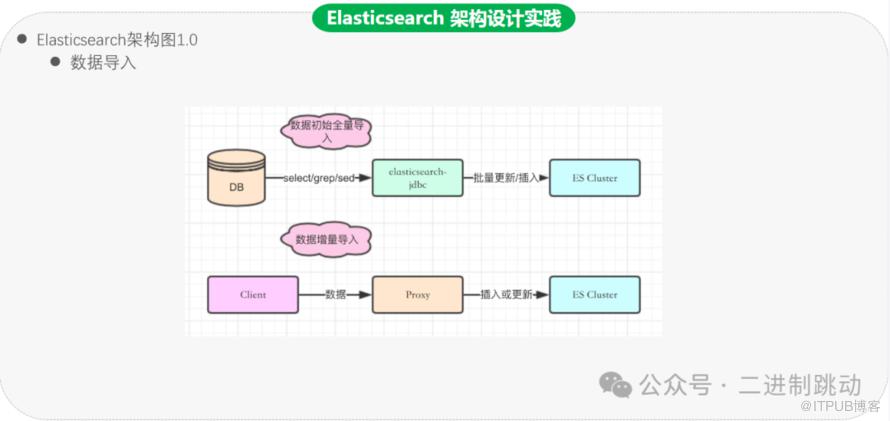
搜索数据实时导入
MQ监听消息解析:通过消息队列监听和解析数据变化。
信息丰富(FromDB):从数据库中提取丰富的信息。
批量导入:批量导入数据到搜索集群。
模型训练特征生产
周期日志:定期日志,用于模型训练。
实时日志:实时日志,用于实时模型更新。
ETL:提取、转换和加载,用于将日志数据转换为特征数据。
机器学习训练特征:生成用于机器学习模型训练的特征数据。
统一ABTest平台
ETCD:分布式键值存储,用于配置管理。
SDK:软件开发工具包,提供与ABTest平台的接口。
Dashboard:仪表盘,提供可视化的ABTest结果和系统监控。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

