缓存数据一致性实践

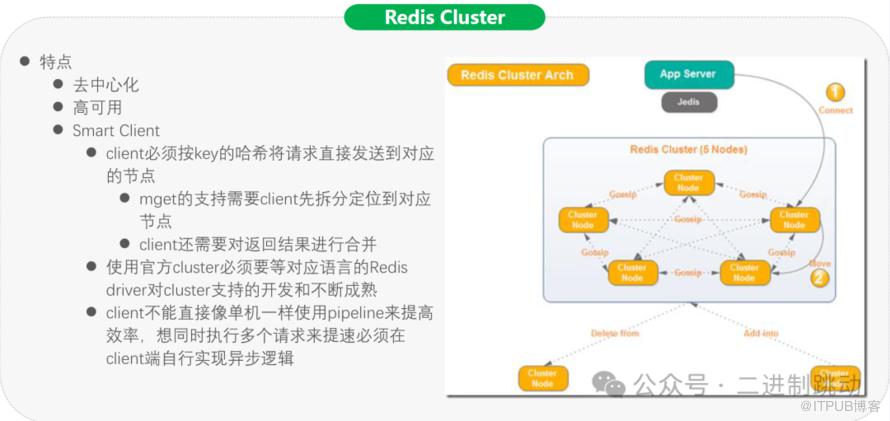
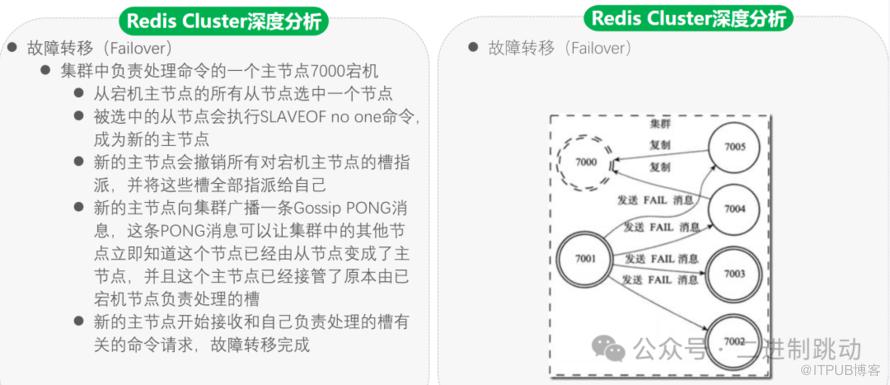
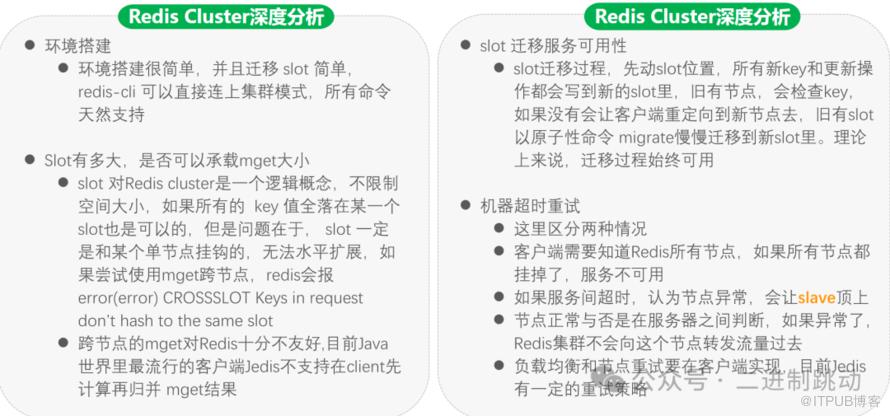
多主多从,去中心化:拥有多个主节点和从节点,从节点作为备用,复制主节点的数据,但不做读写操作,不对外提供服务。主节点之间相互“监督”,保证及时故障转移。
支持动态扩容节点:可以在不影响集群正常运行的情况下,增加或减少节点,实现集群的横向扩展或收缩。
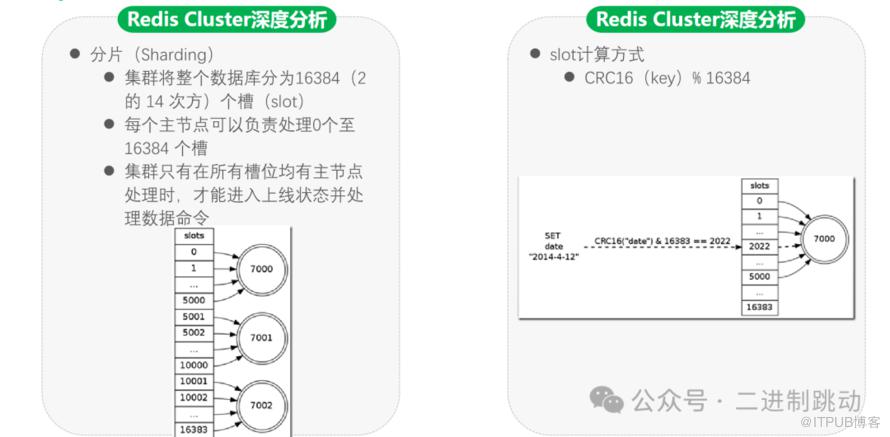
数据分片存储:采用哈希槽(hash slot)机制将数据分散存储在不同的节点上。Redis 集群中总共有16384个哈希槽,通过计算键的 CRC16哈希值并对16384取模,确定键值所属的哈希槽位置,从而将数据分布到不同的节点上。
不支持处理多个 key 的命令:例如 mget、mset 等批量操作,因为多个键可能不在同一个节点上,在高并发情况下处理可能会有问题。
节点间相互通信:节点之间通过二进制协议进行通信,相互交换哈希槽映射等信息。
客户端定位数据:客户端和实例建立连接后,实例会将自身的哈希槽映射发送给客户端并进行缓存,同时实例之间也会交换哈希槽映射关系,使得客户端能够知道键值对应的哈希槽在哪个实例上。
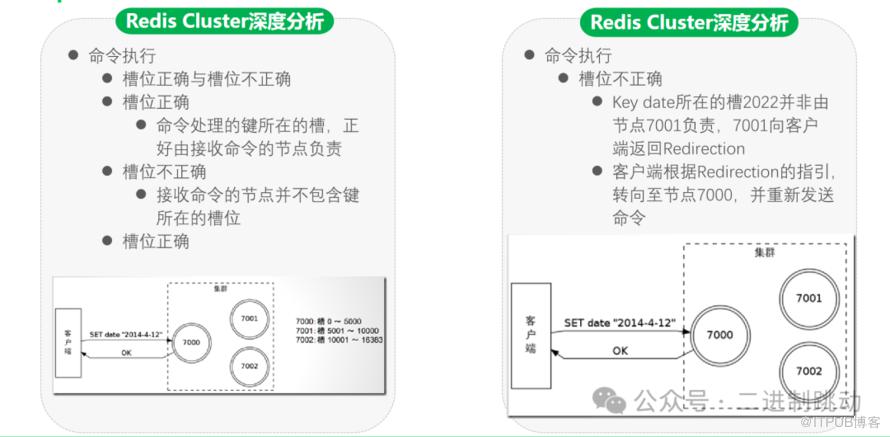
重定向机制:当客户端发送的命令请求对应的哈希槽不在当前连接的实例上时,Redis 会返回重定向信息,指引客户端转向正确的节点。包括 move 重定向和 ask 重定向。move 重定向表示哈希槽的负责权已转移到其他节点;ask 重定向则是在重新分片过程中,当部分键值对还在源节点而部分已在目标节点时,引导客户端转向正在导入槽的目标节点。ask 重定向不会更新客户端缓存的哈希槽映射关系。


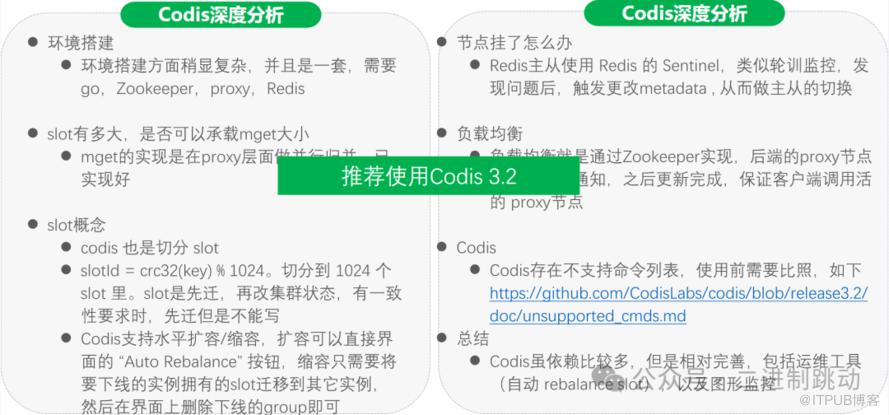

数据复制:
主从复制:设置一个主节点负责写操作,多个从节点复制主节点的数据,用于读操作。当主节点出现故障时,可以提升一个从节点为主节点。
多副本复制:在多个节点上存储相同的数据副本,提高数据的可用性。
数据分片:
按照一定的规则(如哈希、范围等)将数据分布到不同的节点上,避免单个节点成为性能瓶颈。同时,通过冗余备份分片数据来保证可用性。
故障检测与自动切换:
定期检测节点的健康状态,如心跳机制。
当检测到节点故障时,自动将服务切换到其他正常的节点。
负载均衡:
确保请求均匀地分布到各个缓存节点,避免某些节点负载过高而某些节点闲置。
常见的负载均衡算法有轮询、随机、加权等。
数据持久化:
将缓存中的数据定期或在关键操作时保存到持久存储(如磁盘)中,以便在节点故障后能够恢复数据。
集群管理:
监控集群的状态,包括节点的资源使用、性能指标等。
动态调整集群配置,如增加或减少节点。
缓存预热:
在系统启动或节点恢复时,提前将热点数据加载到缓存中,减少首次访问的延迟。
数据过期策略:
合理设置数据的过期时间,避免无用数据占用缓存空间。

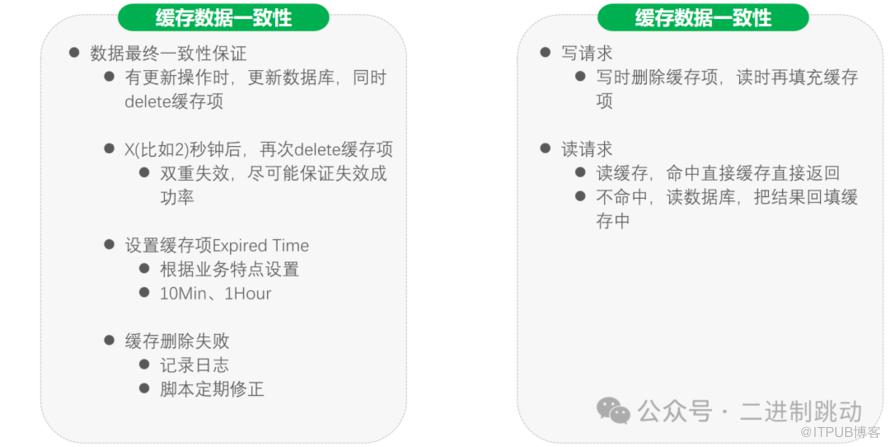
先更新数据库,再删除缓存:
这是一种常见的策略。先在数据库中完成数据的更新操作,然后删除对应的缓存数据。下一次请求时,缓存未命中会重新从数据库加载最新数据到缓存中。
例如,在一个在线购物网站中,当商品的库存数量发生变化时,先更新数据库中的库存值,然后删除缓存中的库存数据。
先删除缓存,再更新数据库:
先删除缓存,然后进行数据库更新。这种方式可能会在短时间内出现数据不一致,但通常影响较小。
比如,在用户信息修改场景中,先删除缓存中的用户信息,然后更新数据库中的用户数据。
设置缓存过期时间:
为缓存数据设置合理的过期时间,即使数据库更新后缓存未及时删除或更新,也能通过过期自动重新加载最新数据。
以新闻网站为例,热门新闻的缓存可以设置较短的过期时间,以保证及时获取最新内容。
读写锁或分布式锁:
在更新数据时获取锁,确保在更新数据库和处理缓存时的操作是串行的,避免并发导致的不一致。
比如在金融交易系统中,处理账户余额更新时使用锁来保证一致性。
消息队列:
数据库更新操作发送消息到消息队列,消费端处理消息来更新缓存。
例如在库存管理系统中,库存变动时发送消息,消费端根据消息更新缓存。
缓存更新机制:
采用专门的后台线程或定时任务来周期性地检查数据库和缓存数据的一致性,并进行更新。
比如在论坛系统中,每隔一段时间检查帖子的点赞数在数据库和缓存中的一致性。
双写一致性:
同时更新数据库和缓存,通过一定的机制(如事务)保证两者的更新都成功或都失败。
但这种方式可能会带来性能开销和复杂性。
原文作者:二进制跳动;如有侵权,请联系管理员删除。

