本系列相关文章:
基本概念:Elasticsearch(一)
Mapping:Elasticsearch(二)
在 ES 中,全文搜索与 Analysis 部分密不可分。我们为什么能够通过一个简单的词条就搜索到整个文本?因为 Analyzer 分析器的存在,其作用简而言之就是把整个文本按照某个规则拆分成一个一个独立的字或词,然后基于此建立倒排索引。
01
—
Analyzer
Analyzer(分析器)的作用前文已经说过了:拆分文本。
每一个 Analyzer 都由三个基础等级的构建块组成:
Character filters
Tokenizer
Token filters
1、Character filters :接受原始输入文本,将其转换为字符流并按照指定规则基于字符进行增删改操作,最后输出字符流。
2、Tokenizer :接受字符流作为输入,将其按照指定规则拆分为单独的 tokens( 这里的 token 就是我们通常理解的字或者词 ),最后输出 tokens 流。
3、Token filters :接受 tokens 流作为输入,按照指定规则基于 token 进行增删改操作,最后的输出也是 tokens 流。
一个完整的包含以上三个部分的分析流程如下图所示:
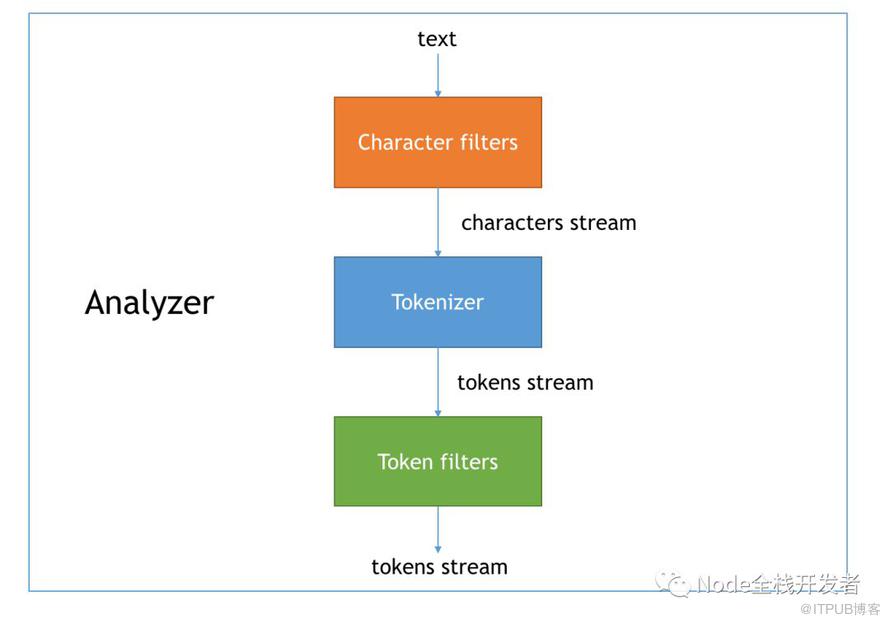
注意:并不是每一个 Analyzer 分析器都需要同时具备以上三种基础构建块。
一个 Analyzer 分析器的组成有:
零个或多个 Character filters
必须且只能有一个 Tokenizer
零个或多个 Token filters
02
—
Character filter
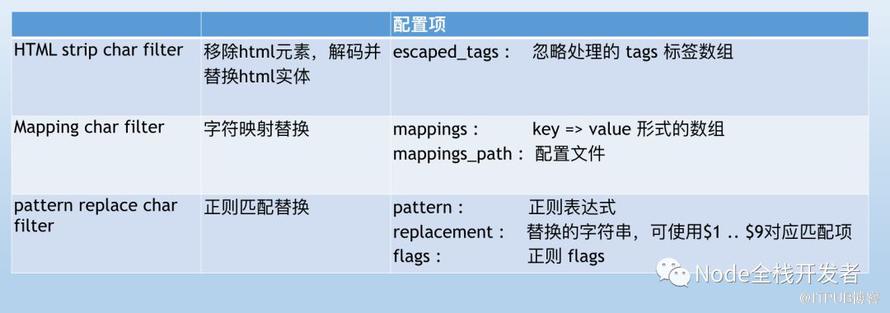
Character filter 的作用就是对字符进行处理,比如移除 HTML 中的元素如 <b> ,指定某个具体的字符进行替换 abc => 123 ,或者使用正则的方式替换掉匹配的部分。
ES 内置了以下三种 Character filters :
03
—
Tokenizer
Tokenizer 的作用就是按照某个规则将文本字符流拆分成独立的 token(字词)。
word、letter、character 的区别:
word:我们通常理解的字或者词。
letter:指英语里的那 26 个字母。
character:指 letter 加上其它各种标点符号。
token 和 term 的区别(参考Lucene):
token:在文本分词的过程中产生的对象,其不仅包含了分词对象的词语内容,还包含了其在文本中的开始和结束位置,以及这个词语的类型(是关键词还是停用词之类的)。
term:指文本中的某一个词语内容,以及其所在的 field 域。
然而,在某些语境下,其实 token 和 term 更关注的仅仅只是词语内容本身。
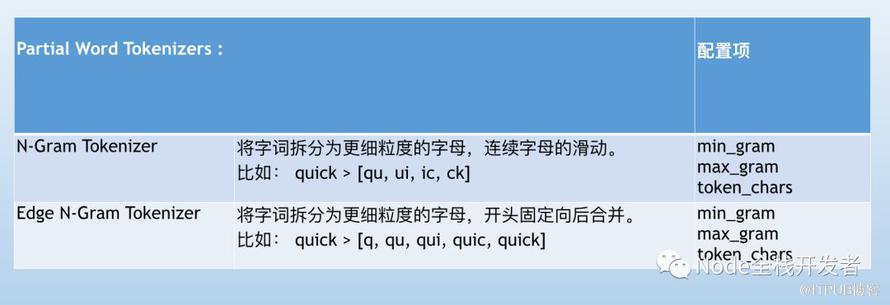
ES 内置了十五种 Tokenizer ,并划分为三类:
1、面向字词:

2、以字词的某部分为粒度:
3、结构化文本:

04
—
Token Filter
Token Filter 的作用就是把 Tokenizer 处理完生成的 token 流进行增删改再处理。
ES 内置的 token filter 数量多达四五十种:
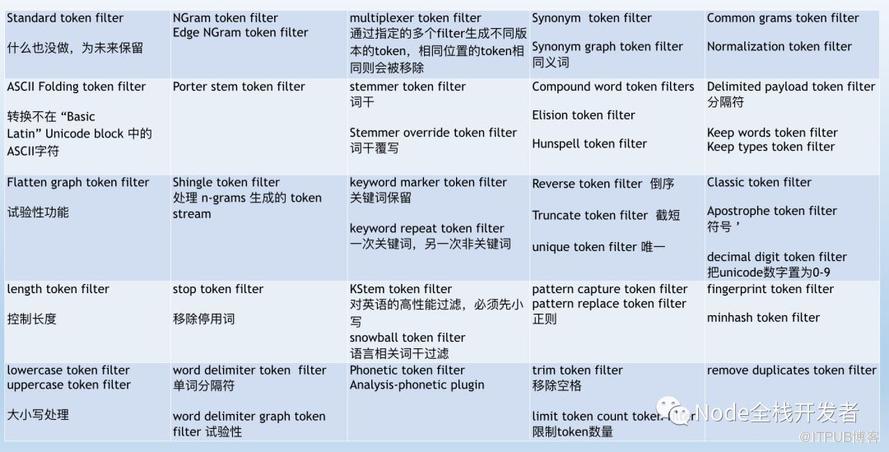
上图只是简单罗列说明,此处不进行展开说明,更多细节还是查阅官方文档好了。
05
—
Analyzer
ES 内置了以下 Analyzer :
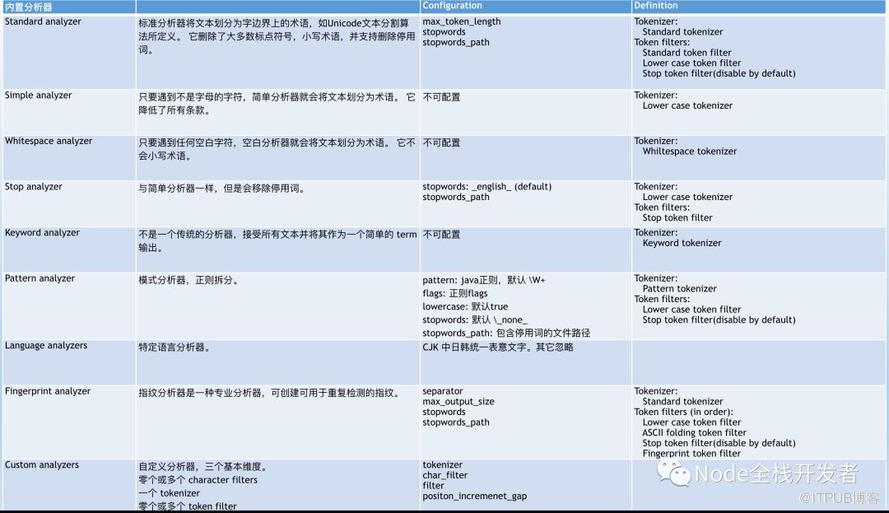
可以看到每一个 Analyzer 都紧紧围绕 Character filters 、Tokenizer、Token filters 三个部分。
同样,只要选择并组合自己需要的以上这三个基本部分就可以简单的进行自定义 Analyzer 分析器了。
06
—
End
本文简单介绍了与全文搜索密切相关的【分析】这一重要部分,而如何进行实际的分析器设置则与上一篇文章 Mapping 相关联,另外除了 ES 内置的之外,还有很多开源的分析器同样值得使用,比如中文分词,使用较多的就是 IK 分词。
本篇完。
原文作者:系统架构师Go;如有侵权,请联系管理员删除。

最新文章
- Kubernetes Node 节点的生命周期简述
- Kubernetes Node 节点上的镜像管理
- 如果自建 ChatGPT,我会如何从 Model、Inference runtime 构建整个系统
- 以翻译 Kubernetes 文档为例,探索 AI 模型 Fine-Tuning 微调
- Kubernetes GPU 调度和 Device Plugin、CDI、NFD、GPU Operator 概述
- 只想简单跑个 AI 大模型,却发现并不简单
- AI LLM 利器 Ollama 架构和对话处理流程解析
- Kubernetes:Seccomp、AppArmor、SELinux & Pod 安全性标准和准入
- Kubernetes: kube-proxy 和 CNI 是如何协作的?
- Kubernetes CSI 简介:工作流程和原理
