时间是不可或缺的绝对主角(就像 MySQL 中的主键一样),数据按照时间顺序组织管理 高并发高吞吐量的数据写入 数据的更新很少发生 过期的数据可以批量删除
DURATION:数据的保留时长。
REPLICATION:集群模式下数据的副本数,单节点无效。
SHARD DURATION:可选项,shard group 划分的时间范围。

<measurement>[,<tag-key>=<tag-value>...] <field-key>=<field-value>[,<field2-key>=<field2-value>...] [unix-nano-timestamp]
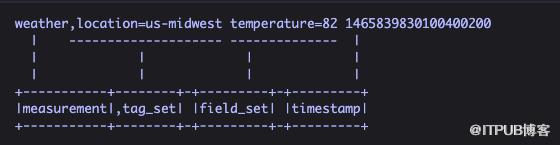
怎么去理解 series 和 point ?先看下图:
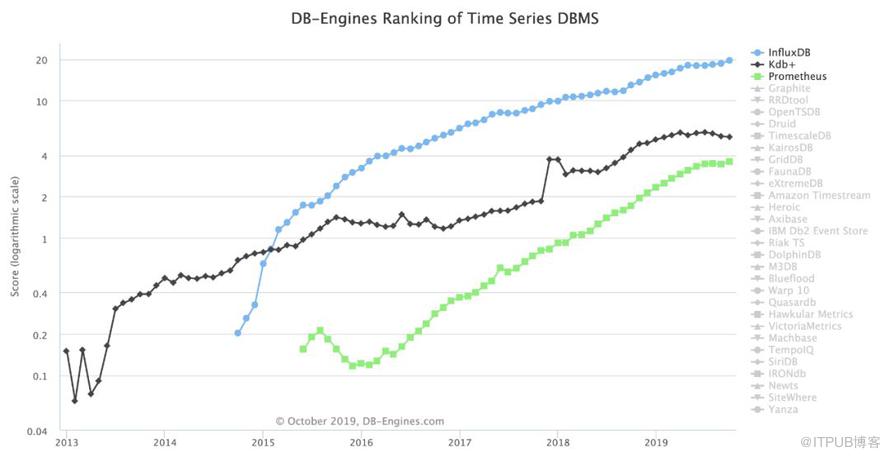
这张图选取了三种时序数据库的历年排名得分情况。首先,整个图表可以看成是一个 measurement ,它包含了许多数据;然后我们根据 db 名称构建 tag ,把 score 排名得分作为 field ,那么所有数据行就类似于:
measurement,db=InfluxDB score=5 timestampmeasurement,db=Kdb+ score=1 timestampmeasurement,db=Prometheus score=0.2 timestamp...
上文说过 tag set 就是 tag key = tag value 的不同组合,因此这里的 tag set 有以下三种:
db=InfluxDBdb=Kdb+db=Prometheus
三个 tag set 构成了三个 series ,每个 series 就可以看成是图中的一条线(一个维度),而每个 point 点就是 series 上具体某个 timestamp 对应的点。
更新某个 point 数据,只需向原来的 measurement,tag set,timestamp 重写数据即可。 你可以删除 series ,但是不能基于 field 值去删除独立的 points ,解决方法是,你需要先查询 field 值的时间戳,然后根据时间戳去删除。 无法更新或重命名 tags ,因为 tags 会构建索引,你只能创建新的 tags 并导入数据然后删除老的。 无法通过 tag key 或者 tag value 去删除 tags 。
优点:简化了冲突,提高了写入性能。 缺点:不能存储重复数据,可能会在极少数情况下覆盖数据。
优点:提高了读写性能。 缺点:删除功能受到了很大限制。
优点:提高了读写性能。 缺点:更新功能受到了很大限制。
优点:按时间递增的顺序写入数据更高效。 缺点:随机时间写入的性能要低很多。
优点:数据库可以处理大批量数据的读写。 缺点:被迫做出的一些权衡去提高性能。
优点:多个客户端可以在高负载的情况下完成查询和写入操作。 缺点:如果负载过高,查询结果可能不包含最近的点。
优点:InfluxDB 善于管理不连续的数据。 缺点:无模式设计意味着不支持某些数据库功能,例如没有 join 交叉表连接。
优点:InfluxDB 具有非常强大的工具去处理聚合数据和大数据集。 缺点:Points 数据点没有传统意义上的 ID ,它们被时间戳和 series 区分。
原文作者:系统架构师Go;如有侵权,请联系管理员删除。
上一篇:
时序数据库 InfluxDB(二)
下一篇:
Go 十秒钟了解 PMG 模型

请登录后发表评论
登录
全部评论
最新文章
- Kubernetes Node 节点的生命周期简述
- Kubernetes Node 节点上的镜像管理
- 如果自建 ChatGPT,我会如何从 Model、Inference runtime 构建整个系统
- 以翻译 Kubernetes 文档为例,探索 AI 模型 Fine-Tuning 微调
- Kubernetes GPU 调度和 Device Plugin、CDI、NFD、GPU Operator 概述
- 只想简单跑个 AI 大模型,却发现并不简单
- AI LLM 利器 Ollama 架构和对话处理流程解析
- Kubernetes:Seccomp、AppArmor、SELinux & Pod 安全性标准和准入
- Kubernetes: kube-proxy 和 CNI 是如何协作的?
- Kubernetes CSI 简介:工作流程和原理
