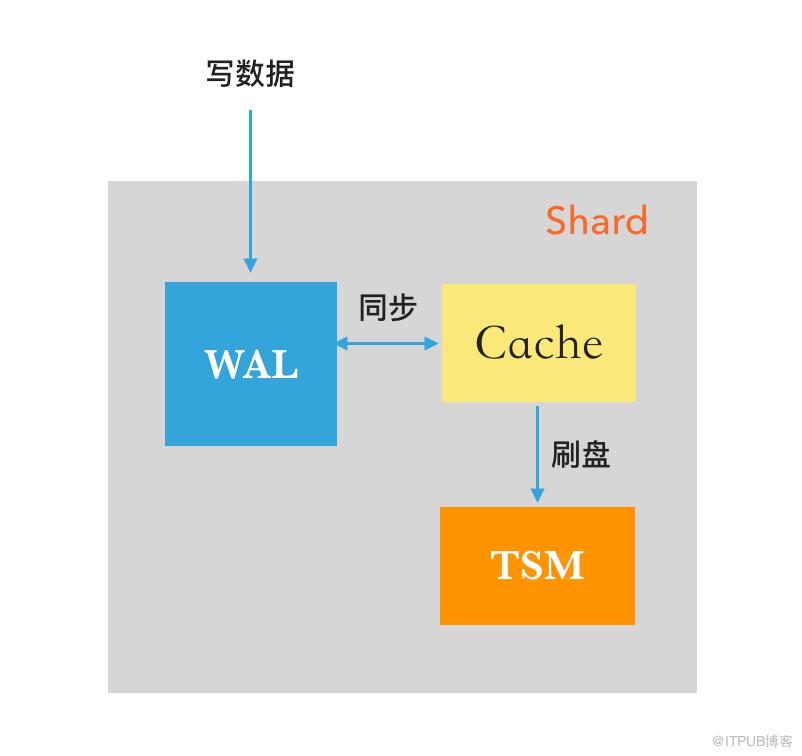
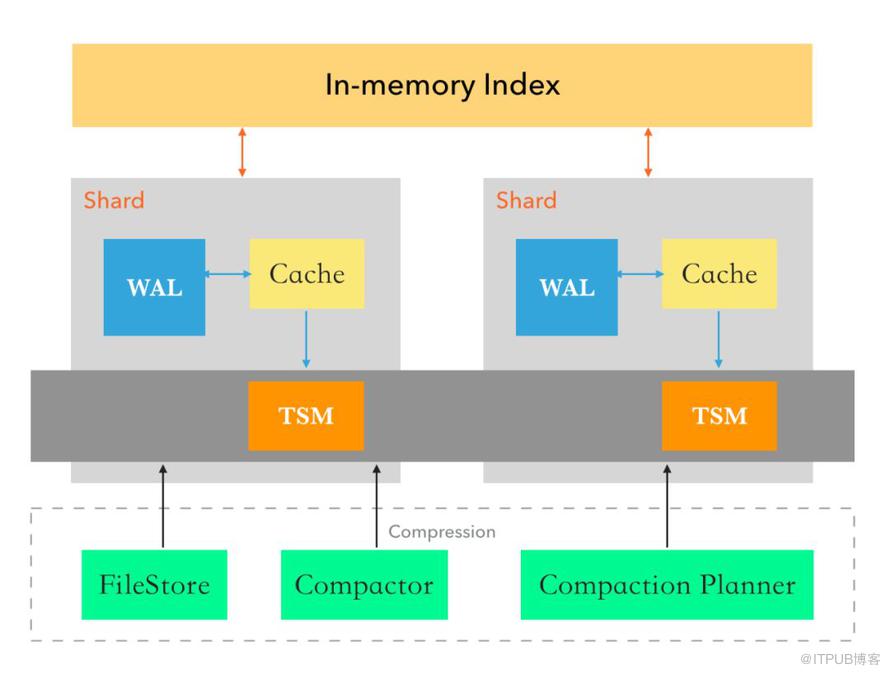
In-Memory Index :跨分片的共享内存索引,并不是存储引擎本身特有的,存储引擎只是用到了它。 WAL :预写日志。 Cache :同步缓存 WAL 的内容,并最终刷写到 TSM 文件中去。 TSM Files :特定格式存储最终数据的磁盘文件。 FileStore :调节对磁盘上所有TSM文件的访问。 Compactor :压缩器。 Compaction Planner :压缩计划。 Compression :编码解码压缩。 Writers/Readers :读写文件。
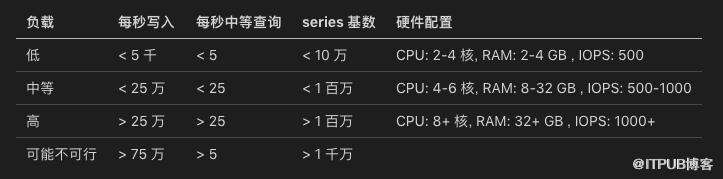
每秒写入 每秒查询 series 基数
简单查询:
几乎没用函数和正则表达式 时间范围在几分钟,几小时,或者一天之内 执行时间通常在几毫秒到几十毫秒
中等复杂度查询: 使用了多个函数和一两个正则表达式 可能使用了复杂的 GROUP BY 语句,或者时间范围是几个星期 执行时间通常在几百毫秒到几千毫秒 复杂查询: 使用了多个聚合、转换函数,或者多个正则表达式 时间跨度很大,有几个月或几年 执行时间达到秒级
[]dir = "/var/lib/influxdb/data"wal-dir = "/var/lib/influxdb/wal"
原文作者:系统架构师Go;如有侵权,请联系管理员删除。
上一篇:
时序数据库 InfluxDB(五)
下一篇:
时序数据库 InfluxDB(三)

请登录后发表评论
登录
全部评论
最新文章
- Kubernetes Node 节点的生命周期简述
- Kubernetes Node 节点上的镜像管理
- 如果自建 ChatGPT,我会如何从 Model、Inference runtime 构建整个系统
- 以翻译 Kubernetes 文档为例,探索 AI 模型 Fine-Tuning 微调
- Kubernetes GPU 调度和 Device Plugin、CDI、NFD、GPU Operator 概述
- 只想简单跑个 AI 大模型,却发现并不简单
- AI LLM 利器 Ollama 架构和对话处理流程解析
- Kubernetes:Seccomp、AppArmor、SELinux & Pod 安全性标准和准入
- Kubernetes: kube-proxy 和 CNI 是如何协作的?
- Kubernetes CSI 简介:工作流程和原理
