很早以前,只是感觉使用UUID作为数据库主键是一种很随意的做法。简单,但是不“美”。
现在越来越觉得它的缺点越来越明显,优点也不再那么重要了。
一个标准的uuid大概是36个字符,抠年中间的4个'-', 仍然高达32个字符。也就是说32个字节。字符串型的。索引所耗空间, 也比8字节的bigint也要大得多。另外,字符串的比较与bigint的大小比较,性能上,可想而知。当数据量一大(cloud环境下,想不大都难). 并且插入的时候是无序的 (think: UUID的比较)
https://blog.csdn.net/bjweimengshu/article/details/80162731 里边的图片也简单的解释了为何CUD性能差。
有一段时间,我曾经琢磨过使得snowflakeId,那个确实不错。是在客户端主动生成唯一的bigint值的一种算法。参看知乎:https://zhuanlan.zhihu.com/p/245779116
https://blog.csdn.net/bjweimengshu/article/details/80162731
这个算法最早由Twitter提出, Twitter 所采用的一种算法,目的是在分布式系统中生成全局唯一且趋势递增的ID。一 组成 SnowFlake所生成的ID一共分成四部分。SnowFlake算法在同一毫秒内最多可以生成多少个全局唯一ID呢?只需要做一个简单的乘法:
同一毫秒的ID数量 = 1024 X 4096 = 4194304
这个数字在绝大多数并发场景下都是够用的。
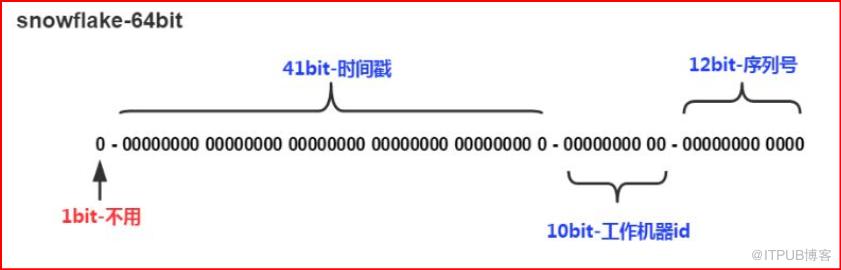
我发现,在CF上,确实可以搞搞。而NEO上好像不不太行了(有些技术上的限制)
折中的做法,就还是使用数据库自身提供的sequence, identity技术了。因为是直接使用数据库。无论是性能还是存储,都能满足需求。
头痛的是, 已经使用了UUID的各个microservice, 想转回到sequence (bigint), 一下就变得复杂了。
试想,如果各个microservice都依赖一个中心的service, 使用UUID而不是sequence作为tenant id. 并且已经有大量的数据存储到表里头,现在要把这个tenantid全部转换成sequence值, 而且需要同时。。。。。。
可能略觉痛苦的做法是,借用原来的varchar(36),把sequence值转成String, 这样在存储时会好一些。唯一的缺点是数据库端比较id大小时使用的是string大小比较,而不是big int比较。但是存储空间会小了很多。大概18个字节就够了。但是这样,需要实现一个customized seq generator.
原文作者:数据库杂记;如有侵权,请联系管理员删除。

最新文章
- PostgreSQL Internals之路 Part-II 第10章 WAL日志
- 从Oracle过渡到PostgreSQL: 理解模式的概念
- PostgreSQL是Oracle的一个可行的替代方案——原因如下
- PostgreSQL Internals之路Part II: Buffer Cache和WAL第9章 Buffer Cache
- 天纵奇才 - "林诗栋"
- 没有PostgreSQL样例数据库,不用担心, 帮你搞定!
- 推荐几本数据库技术图书
- 由浅入深高可用:HAProxy + PostgreSQL配置逐步详解(二)
- PostgreSQL Internals之路 Part-I 第7,8章 冻结、重建表和索引
- 乒坛最新消息引发巨震 - 世界第一王楚钦惨败林诗栋,王曼昱0-4遭横扫,还有孙颖莎4-2稳胜张本美和
