前些日子,在某个Region的HANA数据库居然出现了OOM的问题,而且基本上是不断的频发。这可了不得了,一些依赖于该HANA数据库的服务就不能正常工作了。引起了一系列连琐反应。
找到HANA的相关的支持人员,也只是简要的从HANA数据库的基本监控来找原因。他们建议立即扩大内存。从原来的128G扩大至至少256G,扩内存的操作,是需要DOWN机时间的。另外,他们也建议我们找找数据库当是不是有一些表有异常现象,比如表过大之类的。
熟悉表的使用情况的,还是相关的开发人员。于是我们对怀疑的表进行一些基本的统计。发现有一张表:SMP_STATISTICS,记录行数大的恐怖:
SELECT COUNT(*) FROM FOO_STATISTICS;
2,005,272,167
居然有20亿行。而且还在不断地往上涨。
我们还查到:
<= 2022-11-06 在这之前的记录就有659,089,651 (6亿5千多万行)没有被清理掉。导致大量的数据遗留在数据库当中。
这是我们怀疑的最主要的地方。
找到最主要的点,就好办了。于手动purge数据。不能直接按条件删除6亿多条记录。我们选择了按周一周周的删除记录。这样平均6000万条记录花1分钟时间删除。慢慢地就清掉了。可惜DevOps犯了一个错误,居然在delete完之后,忘了COMMIT。这是后来又一次OOM才发现的。而且是在内存扩容之后再次发生。
借用刚好是MUW的时间窗,做了一次扩容,内存至256G,而相应的Disk好像到了720GB, CPU数也上到了17vCPUs。
同时发也现只要列表的行数达到了极限2^^31,再大内存也无济于事。必须对目标表进行有效处理。
89天前,一天的数据量:
SELECT count(*) FROM "XXXXXXX"."FOO_STATISTICS" where metric_timestamp <= ADD_DAYS(CURRENT_UTCDATE, -89)
-- 89天以前的一天的量
4177186
这看起来并不多,只有400来万。
目标表FOO_STATISTICS行数爆增,也是有原因的。它的来源主要是一些实时统计数据。而且统计的门类不断的增加,随着客户量的增加,统计数据的增加会更加厉害。
再进一步分析,可以去掉一些冗余的统计数据。去掉之前,每天差不多要产生2400万条数据。这样的话,90天的数据,已经超过20亿条上限了。所以,必须进行处理。去掉冗余之后,可以一天只产生1300万条。90的量,那还是撑得住的。
但这不是治本的办法。
HANA针对列类型的表,有一种partition的方案,针对那种没有主键的表,可以使用Round Robin partition。
CREATE COLUMN TABLE T123(id int);
ALTER TABLE t123 ADD (col2 varchar(32));
ALTER TABLE t123 PARTITION BY ROUNDROBIN PARTITIONS 8;
每个分区可以多达20亿条,那么总容量可以支撑到160亿条。
但是因为环境相当复杂,在cloud环境实施起来有些难度。后续再行介绍最终如何解决这个分区问题。
目前,去掉冗余统计并清理掉了过期的6亿多条。最后余下14亿条左右。至少能给后边的分区操作赢得时间。
HANA数据库针列型的表的记录数,其实是有预警的。
By default, HANA system will report below alert for each one hour.
Interval 1 hour
High: 1,900,000,000
Medium: 1,800,000,000
Low: 1,500,000,000
就是说,当超过15亿条时就会有Low级别是的警告,18亿条时,有Medium级别的警告。如果到了19亿条时,就是High了。这个预警还是很重要的。试想我们每天涨2400万条,那么从19亿到20亿,可以有近4天时间的缓冲。看来是哪个环节疏忽了。
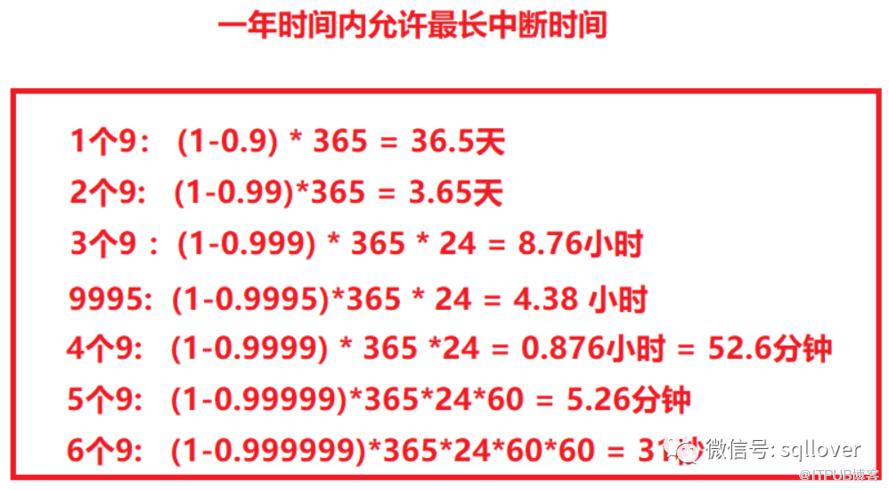
有一种SLA的服务时间图,是最能反映CLOUD环境下的服务水平的,而广大DevOps以及DBA们也是朝那个方向不断的努力。

各位朋友,不知道你们的目标是上边的几个9,我们还一直在为9995这个目标而努力。
原文作者:数据库杂记;如有侵权,请联系管理员删除。