前言
本文只作一些梳理,入门性的介绍,里边收集的内容可以分开来慢慢看。
1、空闲空间映射(FSM)
1.1、概念及原理
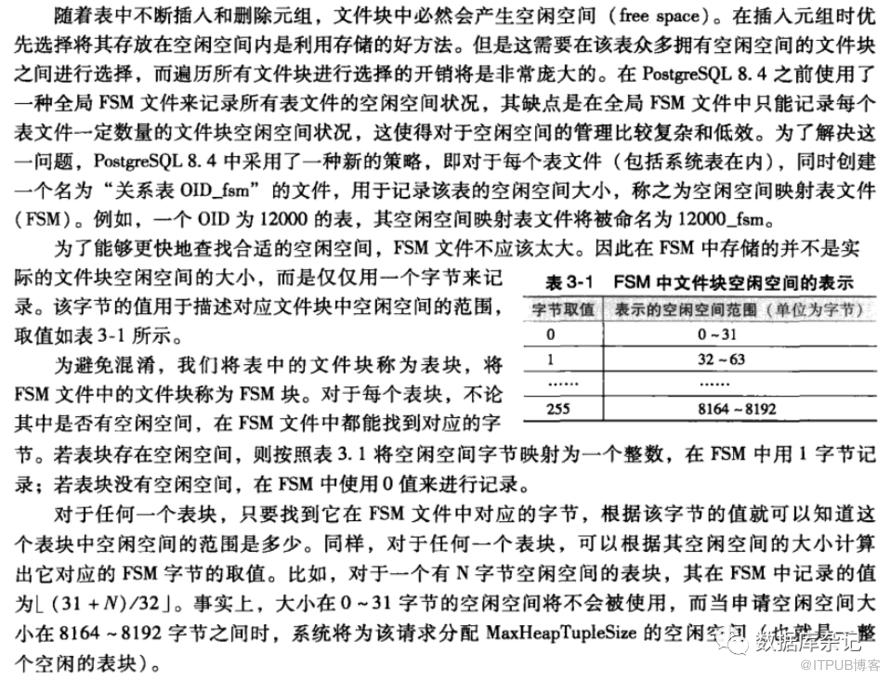
每一个表和索引(除了哈希索引)都有一个空闲空间映射(FSM)来保持对关系中可用空间的跟踪;以关系的文件节点号加上一个_fsm后缀命名;FSM文件是执行VACUUM操作时,或者是为了插入行而第一次查询FSM文件时才会创建;
FSM 使用 1 个字节存储一个堆表页面内的空闲空间,1 个字节可以表示 0~255 共 256 种状态,将一个 page 的大小除以 256,就能得到 256 个档位,称之为 cat 值,使用 1 个字节来表示这 256 个档位(category),其对应关系如下:
1.1.1、逻辑页号
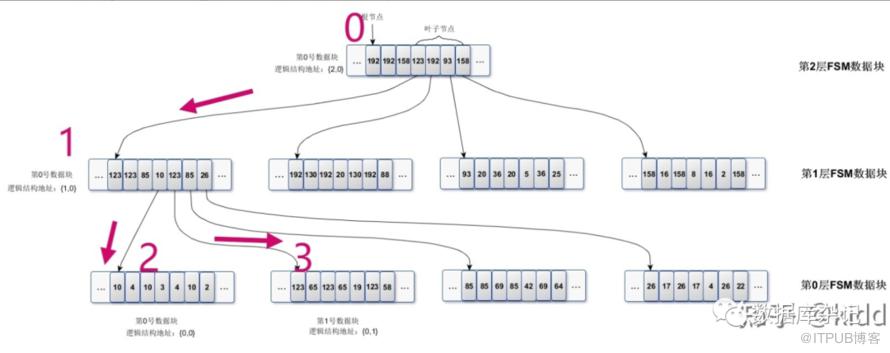
FSM high level是一个多叉树型结构。每个页面最多4000个左右的页子节点。一个表最大容量是32T,4000^3 > 2^32,因此,只需要3层页面就可管理多有页面的空闲空间,从上到下分别为第2层,第1层和第0层。第2层只有一个页面,逻辑页号0,可以表示为<2,0>,最多可以有4000个孩子节点。第1层最多可以有4000个页面节点,逻辑页号可以表示为<1,0>…<1, 3999>。第0层最多有40004000个页面节点,逻辑页号<0,0>…<0,4000*4000>。0层页面中满二叉树叶子节点一次排列对应表的blockNum,0,1,2,4 …… 2^32

1.1.2、物理页号
High level结构中也就是说FSM文件中页面的物理页号是怎么组织的呢?它采用了一个非常巧妙的方式,也就是从2层根节点,采用深度遍历的方式,即逻辑页号<2, 0>: 0, <1, 0>: 1, <0, 0>: 2, <0, 1>:3 … <0, 3999>: 4001, <1, 1>: 4002 ……以此类推。
1.1.3、 Low Level
FSM树的页面节点,采用完全二叉树最大值堆的方式组织FSM树0层节点对应的表的物理页面的空闲空间。
堆表的页从0开始一直到最大,对应的空闲档次也为元素大小为1字节的、个数与页数相同的数组。要加速搜索,就要使用分组+局部排序+分层排序的方法。
1、首先, 对这个数组进行按固定大小进行分组;例如页的近一半大小,近乎4000.这样,可以分出M=(2^32/4000)个组来。
2、对一个组内的空闲档次使用大顶堆排序;相对于整个集合来讲,这就是一个局部排序。大顶堆的个数为M,即分组个数。这仍然是一个很大的数值,需要再次分层;
3、所有堆的堆顶元素又组成了一个集合,大小为M。再次对这个集合进行分组,每个组的大小仍然为4000,这样可以分出M1=M/4000的小组来;同样,继续对组内的4000个元素使用大顶堆排序;
4、M1小组的堆顶元素又可以组成一个集合,如果集合仍然很大的话,可以继续上面的方式进行分组+排序。
每一次的分组+排序就会形成一个层次,直到找到一个适当的层次。对于uint32个页来讲,这个层次高度为3,即恰好等于图中的树高度。
1.2、内核一书中FSM相关资料
1.3 相关插件(pg_freespacemap and pgstattuple)
mydb=# create extension pg_freespacemap;
CREATE EXTENSION

mydb=# \dx+ pg_freespacemap
 Objects in extension "pg_freespacemap"
           Object description
----------------------------------------
 function pg_freespace(regclass)
 function pg_freespace(regclass,bigint)
(2 rows)

mydb=# select * from pg_freespace('t') where avail > 0;
 blkno | avail
-------+-------
     0 |  8160
     1 |  8160
     2 |  8160
     3 |  8160
     4 |  8160
     5 |  8160
.......

mydb=# SELECT *, round(100 * avail/8192 ,2) as "freespace ratio"
                FROM pg_freespace('t') where avail > 5000;
 blkno | avail | freespace ratio
-------+-------+-----------------
    15 |  5376 |           65.00
    16 |  5376 |           65.00
    17 |  5376 |           65.00
    18 |  5376 |           65.00
    19 |  5376 |           65.00
mydb=# create extension pgstattuple;
CREATE EXTENSION

mydb=# \dx+ pgstattuple;
  Objects in extension "pgstattuple"
          Object description
---------------------------------------
 function pg_relpages(regclass)
 function pg_relpages(text)
 function pgstatginindex(regclass)
 function pgstathashindex(regclass)
 function pgstatindex(regclass)
 function pgstatindex(text)
 function pgstattuple_approx(regclass)
 function pgstattuple(regclass)
 function pgstattuple(text)
(9 rows)
mydb=# select * from pg_relpages('t');
 pg_relpages
-------------
         150
(1 row)
mydb=# select * from pgstattuple('t') \gx
-[ RECORD 1 ]------+--------
table_len          | 1228800
tuple_count        | 8000
tuple_len          | 464000
tuple_percent      | 37.76
dead_tuple_count   | 0
dead_tuple_len     | 0
dead_tuple_percent | 0
free_space         | 680268
free_percent       | 55.36
2、可见性映射(VM)
2.1、概念
VM从PG8.4开始引入,每一个表都有一个可见性映射(VM)用来跟踪哪些页面只包含对所有活动事务可见的元组,它也跟踪哪些页面只包含未被冻结的元组;(有关未被冻结的信息的跟踪是在PG9.6加入的增强)。
它伴随着主关系数据被存储在一个独立的关系分支中,以该关系的文件节点号加上一个_vm后缀来命名。如表t对应的的节点id为:32900。它对应的生成的fsm以及vm就是32900_fsm和32900_vm。每个VM由一个或多个8 KB页面组成。
mydb=# select * from t order by t desc limit 5;
  id   |             col2
-------+------------------------------
 10000 | 2022-12-22 06:25:20.95621+08
  9999 | 2022-12-22 06:25:20.95621+08
  9998 | 2022-12-22 06:25:20.95621+08
  9997 | 2022-12-22 06:25:20.95621+08
  9996 | 2022-12-22 06:25:20.95621+08
(5 rows)

mydb=# vacuum t;
VACUUM

mydb=# select pg_relation_filepath('t');
 pg_relation_filepath
----------------------
 base/16384/32900
(1 row)

mydb=# \! ls base/16384/32900
base/16384/32900
mydb=# \! ls base/16384/32900*
base/16384/32900  base/16384/32900_fsm  base/16384/32900_vm

mydb=# select * from pg_stat_file('base/16384/32900_vm');
 size |         access         |      modification      |         change         | creation | isdir
------+------------------------+------------------------+------------------------+----------+-------
 8192 | 2022-12-22 06:25:48+08 | 2022-12-22 06:25:48+08 | 2022-12-22 06:25:48+08 |          | f
(1 row)
2.2、基本原理
VM的基本概念很简单。每个表都拥有各自的可见性映射,用于保存表文件中每个页面的可见性。页面的可见性确定了每个页面是否包含死元组。清理过程可以跳过没有死元组的页面。VM文件中为每个数据块设置了一个标志位,用来标记数据块中是否存在需要清理的行。
有了这个文件后,通过VACUUM命令扫描这个 文件时,如果发现VM文件中这个数据块上的位表示该数据块没有需要清理的行,则会跳过对这个数据块的扫描,从而加快VACUUM清理的速度。

上图展示的就是如何使用VM文件。假设该表包含三个页面,第0页和第2页包含死元组,而第1页不包含死元组。表的可见性映射中保存着哪些页面包含死元组的信息。在这种情况下,清理过程可以参考VM中的信息,跳过第一个页面。
2.3、PG内核一书中相关解释
2.4、相关插件:(pg_visibility)
文档参数:https://www.postgresql.org/docs/14/pgvisibility.html
mydb=# create extension pg_visibility;
CREATE EXTENSION

mydb=# \dx+ pg_visibility
     Objects in extension "pg_visibility"
              Object description
-----------------------------------------------
 function pg_check_frozen(regclass)
 function pg_check_visible(regclass)
 function pg_truncate_visibility_map(regclass)
 function pg_visibility_map(regclass)
 function pg_visibility_map(regclass,bigint)
 function pg_visibility_map_summary(regclass)
 function pg_visibility(regclass)
 function pg_visibility(regclass,bigint)
(8 rows)
2.4.1、实例参考
mydb=# select * from pg_visibility('t');
 blkno | all_visible | all_frozen | pd_all_visible
-------+-------------+------------+----------------
     0 | t           | f          | t
     1 | t           | f          | t
     2 | t           | f          | t
     3 | t           | f          | t
     4 | t           | f          | t

mydb=# select * from pg_visibility('t', 83);
 all_visible | all_frozen | pd_all_visible
-------------+------------+----------------
 t           | f          | t
(1 row)

mydb=# select * from pg_visibility_map('t');
 blkno | all_visible | all_frozen
-------+-------------+------------
     0 | t           | f
     1 | t           | f
     2 | t           | f
     3 | t           | f
     4 | t           | f
     5 | t           | f
     6 | t           | f
     7 | t           | f
     8 | t           | f

mydb=# select * from pg_visibility_map_summary('t');
 all_visible | all_frozen
-------------+------------
          84 |          0
(1 row)

mydb=# delete from t where id > 8000;
DELETE 1000
mydb=# select * from pg_visibility('t');
.......
   136 | t           | f          | t
   139 | t           | f          | t
   140 | t           | f          | t
   141 | f           | f          | f
   142 | f           | f          | f
   143 | f           | f          | f
   144 | f           | f          | f
   145 | f           | f          | f
   146 | f           | f          | f
   147 | f           | f          | f
   148 | f           | f          | f
   149 | f           | f          | f
参考阅读:
1、postgreSQL空闲页面管理:FSM
(https://zhuanlan.zhihu.com/p/507475086)
2、PostgreSQL之FSM与VM
( https://www.cnblogs.com/mingfan/p/14771267.html)
3、PostgreSQL的并发控制
(https://www.jianshu.com/p/b08d7a7ad993)
4、PgSQL · 原理介绍 · PostgreSQL中的空闲空间管理
(http://mysql.taobao.org/monthly/2019/03/06/)
5、[Postgresql Free Space Map 文件解析](Postgresql Free Space Map 文件解析 | 学习笔记 (zhmin.github.io))
(https://zhmin.github.io/posts/postgresql-fsm-file/)
6、PG数据库内核分析: Page 65-69
原文作者:数据库杂记;如有侵权,请联系管理员删除。

最新文章
- PostgreSQL Internals之路 Part-II 第10章 WAL日志
- 从Oracle过渡到PostgreSQL: 理解模式的概念
- PostgreSQL是Oracle的一个可行的替代方案——原因如下
- PostgreSQL Internals之路Part II: Buffer Cache和WAL第9章 Buffer Cache
- 天纵奇才 - "林诗栋"
- 没有PostgreSQL样例数据库,不用担心, 帮你搞定!
- 推荐几本数据库技术图书
- 由浅入深高可用:HAProxy + PostgreSQL配置逐步详解(二)
- PostgreSQL Internals之路 Part-I 第7,8章 冻结、重建表和索引
- 乒坛最新消息引发巨震 - 世界第一王楚钦惨败林诗栋,王曼昱0-4遭横扫,还有孙颖莎4-2稳胜张本美和
