1.1 数据组织
数据库
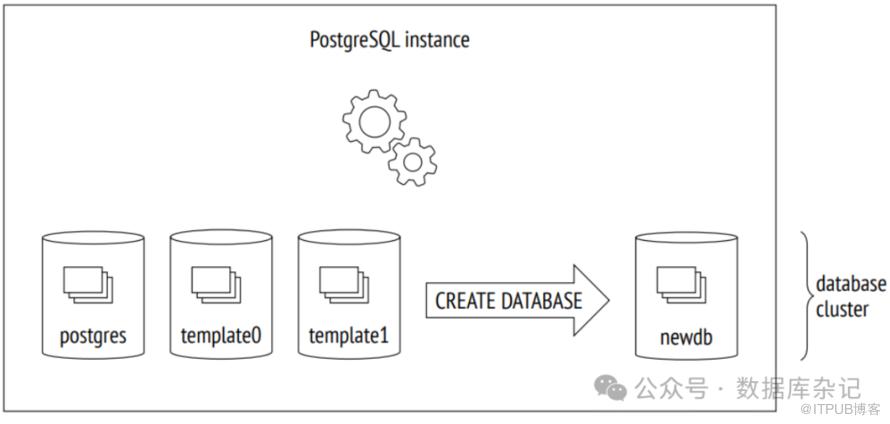
PostgreSQL是类似于数据库管理系统的一个程序。当程序在运行的时候,我们称之为PG服务器,或者一个实例。
由PostgreSQL管理的数据存储在数据库当中。单个PostgreSQL实例可以同时为多个数据库服务;它们统称为一个数据库实例(集簇)。
要能使用这个实例,你必须先要对它进行初始化。包含这个实例相关的所有文件的目录,称之为PGDATA,它是指向这个目录的环境变量名。
预先编译好的安装包,可以在普通PG机制上显式地设置所有参数,添加他们自己的抽象层。这种情况下,数据库服务器可以以操作系统服务的方式运行,您也许从没有直接跨过环境变量PGDATA。但是这个术语已经确定,我打算直接使用它。
在实例初始化以后,PGDATA包含了三个相同的数据库:
template0 用于从逻辑备份恢复数据,或者创建一个不同编码的数据库;它不允许修改。
template1 用作其它数据库的模板,用户可以在实例中创建数据库。
postgres 一个普通的数据库,您可以随意使用。
System Catalog
所有的实例对象(如表、索引、数据类型或函数)的元数据存储在属于系统目录[1]的表中。每个数据库都有自己的一套表(和视图),用来描述该数据库中的对象。一些系统目录表在整个实例范围内是共享的;它们不属于任何一个特定的数据库(技术上来看,使用的数据库ID值为0,哑元数据库),但是可以被所有的数据库访问。
系统目录可以使用普通的SQL进行查询,而更改操作会被DDL命令执行。psql客户端也提供了一套命令用于显示系统目录中的内容。
系统目录中的表名以pg_打头,像pg_database。列名通常3个字母打头,与表名相对应,像datname。
在所有的系统目录表里,定义为主键的列,称为oid(对象标识符);它的类型,也叫oid,是一个32位整数。
oid对象标识符的实现实际上与序列的实现相同,但是它在PG中出现的更早。它的特殊的地方是,产生的唯一ID是由共享的计数器发出,但是被系统目录中不同的表使用。当生成的ID超过了最大值,计数器就被重置。为了确保指定表中所有的值是唯一的,下一次生成的oid会做唯一索引检查;如果它已经用在该表中,计数器[2]会递增,否则那个检查会重复进行。
Schemas (命名空间,模式)
Schema是用于存储数据库中所有对象的命名空间。与用户命名空间不同,PG提供了几个预定义的命名空间:
public 是用户对象的默认的schema,除非指定了其它设置。
pg_catalog 用于系统目录表
information_schema 为SQL标准中定义的系统目录提供备选视图
pg_toast 用于与TOAST有关的对象
pg_temp 包括临时表。尽管不同用户创建临时表使用了不同的命名空间,如pg_temp_N,每个用户引用他们的对象,仍然使用的是pg_temp别名。
每个命名空间受限于特定的数据库,所有数据库对象要么属于这个schema,要么属于另一个schema。
如果对象被访问时,没有明确指定schema,PG会从搜索路径中挑选第1个适合的schema。搜索路径基于参数search_path的值,它隐含的对pg_catalog和pg_temp两个schema进行扩展。意味着不同的schema可能包含完全相同的名字。
表空间
不像数据库和schema,它们决定了对象的逻辑分布,表空间定义了数据的物理布局。表空间实际上是文件系统中的一个目录。你可以将你的数据分布在不同的表空间,归档数据存储到慢的磁盘里,经常更新的数据放到快盘里。
同一个表空间可以被不同的数据库使用,每个数据库存储数据时又可以放到不同的表空间。这意味着逻辑结构和物理上的数据布局并不相互依赖。
每个数据库有所谓的默认表空间。所有数据库对象都在这个表宽间里头创建,除非另一个位置被指定。与之相关的系统目录对象也存储在那里。
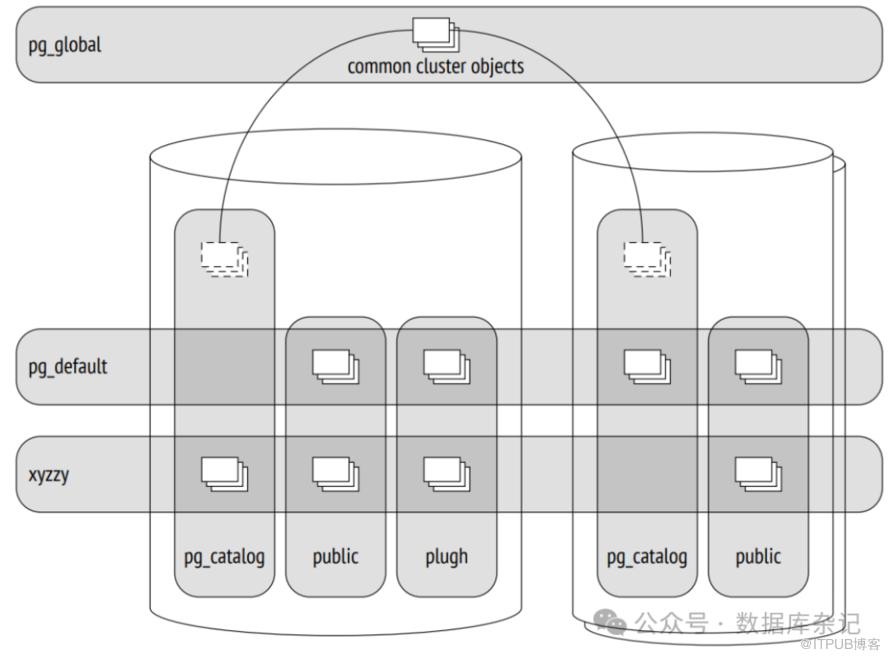
在初例初始期间,两个表空间被创建出来:
pg_default 位于目录PGDATA/base下边;它用于默认的表空间,除非另一个表空间被显式的用于这个目的。
pg_global 位于PGDATA/global目录下边;它用于存储整个实例中共享的那些系统目录对象。
当创建定制的表空间时,您可以指定任意目录;PG会在目录PGDATA/pg_tblspc中创建一个指向该位置的符号链接。事实上,PG中使用的所有路径都是相对于PGDATA目录,这也允许您将它移到一个不同的位置(假定您停掉了服务器)。
上一页的插图将数据库、模式和数据空间组合在一起。这里postgres数据库使用了表空间xyzzy做为默认表空间,而template1数据库使用的是pg_default。不同的数据库对象显示成了表空间和schema的交集。
关系
表和索引 --- 最重要的数据库对象,尽管有很多不同,它们仍有一样东西是相同的:都包含记录行。这一点非常明显,当我们想到表的时候,但对于B-树节点而言也是一样的,它包含了索引的值,以及指向其它节点或者表的数据行的引用。
其它一些对象也有相同的结构;例如,序列(实际上是一个单行的表)、物化视图(可以看作是保留了对应查询的表)。另外,还有普通 的视图,它不存储数据,但是却与表非常相似。
在PG中,所有这些对象都被指为一个更通用的词:关系。
在我看来,这是一个不太让人愉悦的术语,因为它混淆了数据库表和在关系理论中定义的真正的关系。这里我们也能感觉到项目上的学术遗留和它的创始人(Michael Stonebraker)的个人倾向,将所有事物都看作是关系。在他的一项工作里,他甚至引入了“有序关系”的概念来表示一张表,在表里头,行的顺序通过索引来定义。
关系的系统目录表,原来叫做pg_relation,但随着面向对象的流行,后来就被重命名为pg_class,也就是我们现在使用的名字。它的列仍然使用的是REL前缀。
文件和分叉
与一个关系相联系的所有信息都存储在几个不同的分叉(forks[3])中,每个分叉都包含特定类型的数据。
首先,分叉是通过单个文件来表示的。它的文件名由一个数字ID(oid)组成,可以通过与分叉类型相对应的后缀来扩展。
文件始终在增长,当大小达到1GB, 该分叉的另一个文件也会建出来(这样的文件有时候会称为段segment)。段的序列号会添加到文件名的末尾。
1GB的文件大小限制是历史原因,为了支持不同的文件系统,它们当中有的无法处理大文件。您可以修改这个限制,在编译PG的时候(使用:./configure --with-segsize)。
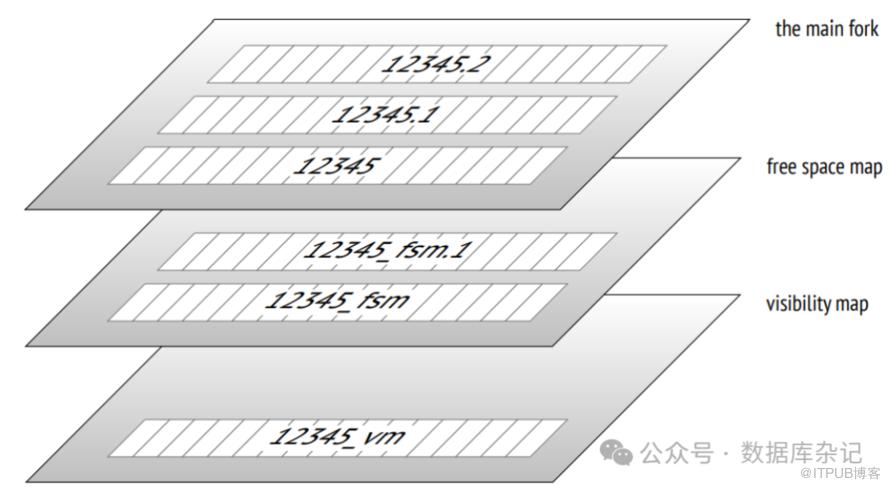
这样,单个关系可以被磁盘上的多个文件来表示。即使没有索引的小表,至少也有三个文件,通过几个强制的分叉。
每个表空间目录(除了pg_global)针对每个数据库都包含独立的子目录。属于相同表空间和数据库的对象的所有文件都位于相同的子目录下边。您可以想到,因为单个目录下边文件太多,文件系统处理的未必很好。
有几个标准的分叉类型。
主分叉 代表真实的数据:表行或索引行。这个分叉对于任何关系都是存在的(除了视图,它没有数据)。
主分叉的文件是通过他们的ID来命名的,存储在pg_class表中的relfilenode上。
我们看看建在表空间pg_default下边的一张表的文件路径:
=> CREATE UNLOGGED TABLE t(
a integer,
b numeric,
c text,
d json
);
=> INSERT INTO t VALUES (1, 2.0, 'foo', '{}');
=> SELECT pg_relation_filepath('t');
INSERT 0 1
postgres=# SELECT pg_relation_filepath('t');
 pg_relation_filepath
----------------------
 base/16384/16385
(1 row)
base目录对应于pg_default表空间,下一个子目录表示数据库,它里我们可以找到对应的文件:
=> SELECT oid FROM pg_database WHERE datname = 'internals';
oid
−−−−−−−
16384
(1 row)

=> SELECT relfilenode FROM pg_class WHERE relname = 't';
relfilenode
−−−−−−−−−−−−−
16385
(1 row)
这是文件系统中相应的文件:
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385');
size
−−−−−−
8192
(1 row)
init分叉 只存在于无日志表(使用UNLOGGED子句)以及他们的索引里。这些对象与普通对象一样,除了在它们身上做的操作都不记WAL日志以外。这会让这些操作变得更快,但是在有故障的情况下您无法确保数据的一致性。所以,PG会在恢复阶段简单的删除这类分叉的对象,并使用初始分叉去覆盖主分叉,创建一个哑元文件。
表t创建成无日志表,因此初始分叉出现了。它与主分叉名字相同,但是多了个_init后缀:
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_init');
size
−−−−−−
0
(1 row)
自由空间映射 保留对页内可用空间的跟踪。它的容量随时间不断变化,在执行回收以后,不断增长,当新的行版本号出现以后,又开始变小。FSM用于快速找到能够容纳新插入数据的页。
所有与FSM相关的文件都有后缀:_fsm。刚开始,没有这样的文件被创建;它们只在需要的时候出现。最简单的方式是对一张表做vacuum操作:
=> VACUUM t;
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_fsm');
size
−−−−−−−
24576
(1 row)
为了加快查找,FSM按树的形式组织;它至少有三个页面(这也是它的文件大小,即使是一张空表,也是如此)。
FSM既给表用,也给索引用。但是因为索引行不能添加到随意的一页(例如,B-树定义了按照排序后的顺序插入的位置),PG只跟踪那些完全空的,并且能在索引结构中重用的页。
可见性映射(vm) 可以快速展示哪个页需要被回收或冻结。基于此目的,它为表中的每页提供了两个提示位。第1位是对那些只包含最新行版本的页。vacuum会跳过这样的页,因为这些页没什么可以清理的。另外,当一个事务试图从这样的页中读数据行时,检查它的可见性没有意义,因此只索引扫描可以被使用。
第2个提示位是对只包含冻结行版本的页进行设置的。我将使用冻结映射(freeze map)来指这部分的分叉。
可见性映射文件包含后缀_vm。它们通常大小非常小。
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_vm');
size
−−−−−−
8192
(1 row)
可见性映射只对表提供,不向索引提供。
页
为了加速I/O,所有文件逻辑上会分成页(或块),代表着可以读或写的最小数据量。结果,很多内部的PG算法都被调整用于页的处理。
页大小通常是8kB。它可以配置成最多在32kB,但是只能在编译的时候进行配置(./configure --with-blocksize),通常没有人这么用。一旦编译好并启动了,实例就只能在这个页大小下工作;不可能创建支持不同页大小的表空间出来。
不管属于哪种分叉,所有的文件都被服务器以几乎相同的方式处理。页首先被移到buffer cache(那里它们被进程读或更新),接着按需要刷回磁盘。
TOAST
每一行都要适应单个页:没有办法将一行持续写到另一页中。为存储长的行,PG使用了特殊的机制,称为TOAST[4] (The Oversized Attributes Storage Technique)。
TOAST隐含有几个策略。你可以将长的属性值移到一个单独的服务表,将它们切成小的“toasts"。另一个建议是将长的值压缩,然后把它塞到一页里。或者是两者都考虑:先压缩,然后切并移走。
如果主表包含很多潜在的长的属性,一张单独的TOAST表会立即创建,用于所有的属性。例如,一张表有一列是numeric或text类型,TOAST表将被创建,即使该列不存任何长的值。
原文作者:数据库杂记;如有侵权,请联系管理员删除。

最新文章
- PostgreSQL Internals之路 Part-II 第10章 WAL日志
- 从Oracle过渡到PostgreSQL: 理解模式的概念
- PostgreSQL是Oracle的一个可行的替代方案——原因如下
- PostgreSQL Internals之路Part II: Buffer Cache和WAL第9章 Buffer Cache
- 天纵奇才 - "林诗栋"
- 没有PostgreSQL样例数据库,不用担心, 帮你搞定!
- 推荐几本数据库技术图书
- 由浅入深高可用:HAProxy + PostgreSQL配置逐步详解(二)
- PostgreSQL Internals之路 Part-I 第7,8章 冻结、重建表和索引
- 乒坛最新消息引发巨震 - 世界第一王楚钦惨败林诗栋,王曼昱0-4遭横扫,还有孙颖莎4-2稳胜张本美和
