在性能优化方面, 剪枝是很常见而且有效的思路。介绍下MySQL里几个跟这个思路相关的优化。
我们建一个这样的表来演示:表people有一个id主键和一个联合索引。
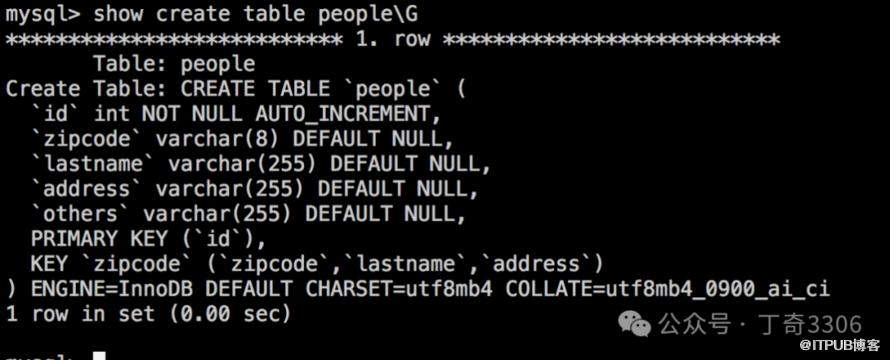
第一个例子是计算这个表id值是null的行数, 这个还是比较明显的。因为id 定义主键,所以每个id值都不可能是null,因此这个语句不需要遍历取每一个id判断,直接返回0。
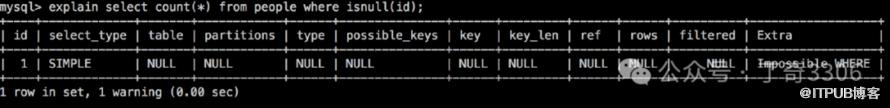 explain的里的impossible Where也说明这里直接跳过判断了。
第二个例子是我们昨晚课上里提到的,
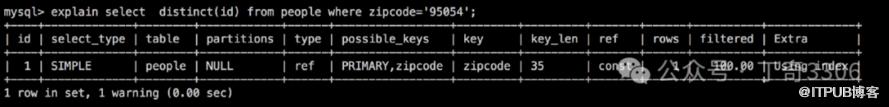
select distinct(id) from people where zipcode='95054';
如果按照distinct的正常执行逻辑,根据zipcode过滤后,应该要把符合条件的id放到临时表里,然后做去重,就会涉及到需要使用临时表。而由于id是主键,本身定义里有唯一性,MySQL判断返回的所有id不会重复,因此直接把zipcode查到的id就返回了。
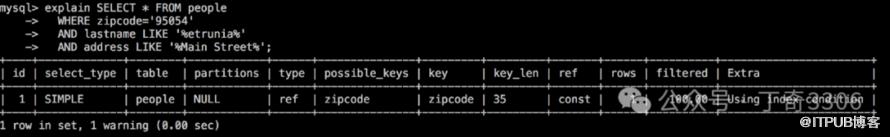
第三个例子是index condition pushdown优化,简称ICP
SELECT * FROM people WHERE zipcode='95054‘ AND lastname LIKE '%etrunia%' AND address LIKE '%Main Street%';
看这个语句,因为lastname like后面的参数第一个字符就是%,因此在用联合索引中定位的时候,只能用上zipcode字段,
在没有ICP之前优化功能,需要把所有满足zipcode等值条件的记录id都拿出来,然后回主键索引上取得整行的数据,再用另外两个条件过滤。
ICP优化的逻辑是,即使不能用在定位数据上,也把三个参数都传给InnoDB,InnoDB在根据zipcode定位到索引上的记录项时,先用lastname和address判断一下是否满足条件,如果不满足,则可以直接跳过这一行,可以减少之后回表操作的消耗。
explain结果里的表明用上了ICP优化。
还有一个很常用的剪枝手段是bloom filter。前一阵刚好看到PolarDB for MySQL发了一个 Bloom Filter For HashJoin下推的优化,创建完hash结构后,多做一个Bloom Filter。然后把bloom Filter扔给驱动表,这样在驱动表遍历过程中,如果可以确认不存在Hash表中的值,就能够直接从引擎层跳过,就不需要到server层再做hash匹配。
(搜:“Bloom Filter For HashJoin + PolarDB for MySQL”)
之所以印象深刻,是相比于集中式MySQL架构,这个优化在计算存储分离的架构下,优化效果会尤其明显,有一种算法之外的、工程上的美感。
原文作者:丁奇3306;如有侵权,请联系管理员删除。

