现在我们每个单元如果报名人数够,就会安排课堂。
虽然一个单元的主体内容是差不多的, 但每堂课的QA部分都是“随机”的。
这个问题就是第一单元的第二次开课上,一位同学提出来的:
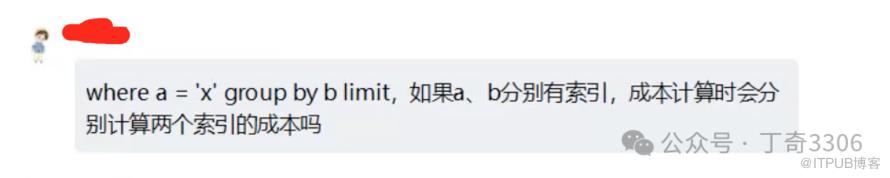
构造一个数据验证下:
create table t1(id int primary key auto_increment, a int not null , b int, c int , index (a), index b(b))engine=innodb;insert into t1(a,b,c) values(1,1,1),(2,2,2),(3,3,3),(4,4,4);insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) values(5,5,5);insert into t1(a,b,c) select a,b,c from t1;insert into t1(a,b,c) select a,b,c from t1;
这个表上字段a和b各自有索引,a=5的有4行, 等于1、2、3、4的各有16384万行。
来看着两个语句的执行计划
explain select b, count(*) from t1 where a=5 group by b limit 10;explain select b, count(*) from t1 where a=3 group by b limit 10;

可以看到,语句1里因为a=5的行只有4行,索引过滤效果很好,虽然需要临时表做grouop by,但是代价很小,因此选了索引a;
语句2只是修改了a的值,改成a=3后,满足条件的有16384行,这样选择索引后, group by成本就增加很多;
而如果选用索引b,扫描过程中b的值是有序的,在做group by这个逻辑的时候,只需要每个值跟前一个值对比即可,不需要临时表,代价小很多
这里优化器就选了索引b。
#转折 1.0
但是从这个执行效果看,这次又选错了。
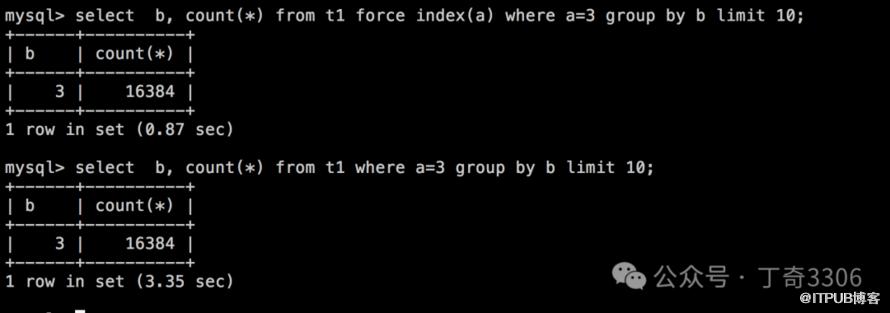
加上force index(a)后,执行时间0.87秒,而让优化器自己选的结果是需要执行3.35秒。
#转折 2.0
在我课堂上的同学经常会看到各种“优化器选错”的案例,是为了让同学们加深理解,特意构造的例子。
容易给人感觉MySQL优化器“总是选错”,实际上MySQL优化器并不是那么弱的, 至少代码里明确列出来的设计路径,是有严谨的时间复杂度的考虑的。
比如这个case,因为b的值很少(只有1个),导致最后的limit 10无效,需要全索引扫描索引b。
如果我们用随机的数据,(实际上这种情况会多些吧)就不一样了,对比例子如下:
先用把字段b的值改成随机值
update t1 set b = 100000*rand();再执行这两个语句的对比:
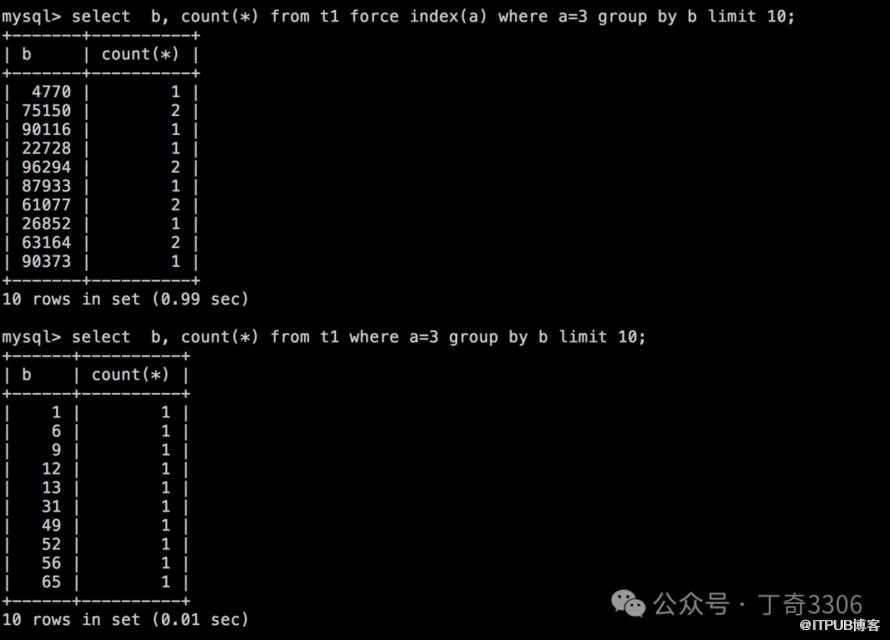
可以看到,force index(a)需要1秒左右,而优化器选择结果只需要10ms。
当然并不否认修改成随机数据前,这个优化器选择结果是一个bad case。
今晚(8月16号)19:00 是第一单元《读懂执行器》的第四次开课,内容有少量迭代,还是50¥,报名群:
原文作者:丁奇3306;如有侵权,请联系管理员删除。

