
本文是大数据社群会员 的实践笔记(知乎号:杜宁军),他本科学的计算机专业,2011年在中国科学院读在职的计算机硕士。工作中是一名开发部门的经理。
提交了《R语言学习笔记2-简单数据处理》之后,分享到大数据社群里,结果猴子说我写的不错,但是要等我完成实践作业以后再给我发放通关文牒。
我疑惑了,我不是已经完成了吗?于是把第3关的课程结尾又听了一遍,才搞清楚原来实践作业是:找到日常工作中的Excel数据,对数据进行预处理,并从中分析出有价值的信息。
想到我所在部门的项目采用的是Redmine软件进行项目管理和缺陷跟踪管理。
项目中干嘛要用Redmine软件呢?
简单来说,项目的缺陷是测试人员发现的问题(也就是软件行业里常说的bug),这些问题需要告诉开发人员。开发人员修复问题后在告诉测试人员“我已经修复了,你验证一下”。测试人员验证确实修复了就关闭问题。
当然,这只是简单的流程,实际要复杂得多。这个工作过程需要沟通,管理人员需要分配问题,也需要知道问题解决到什么程度了,所以需要一个平台记录这些问题,并管理处理流程,redmine就是这样的平台。
好在Redmine可以将数据导出Excel格式,于是我想到将所有数据导出进行预处理和分析。在Redmine中我选择了一个关心的项目,查询所有记录有2632条。导出数据时因为限制了一次最多导出500条,所以先导出打开的,再将剩余的已关闭的按更新时间设置时间段依次导出,最后共得到8个Excel文件。
数据准备好之后,就可以用最近学习到的知识进行实践操作了。
1. 导入数据
导入数据采用openxlsx包导入。
# import data
library("openxlsx")
issuesFile <- "issues-open.xlsx"
issuesOpen <- read.xlsx(issuesFile, "issues")
由于有8个Excel文件,所以导入后要进行合并,按行合并两个数据框使用rbind()函数。
2. 重命名列名
好多列啊,一共有24列,早知道导出的时候不导出这么多列了,但是想想一次只能导出500条,想想算了,还是忍了吧,耐心改列名。
# rename column namenames(issues) <- c("issueNo","project","track","parent","status","priority", "subject","author","assignee","updateTime","category","targetVersion","startDate","planDate","expectTime","costTime", "progress","createTime","finishDate","relateIssue","baseVersion","TPNo","severity","reproducability")3. 处理日期列
导入的日期列显示为一个数字,例如:42794.45,用class()函数查看,显示类型是numeric。通过下面的语句可以转换为Date类型,这里必须指定origin为“1899-12-30”才能得到正确的日期。
ssues$startDate <- as.Date(issues$startDate, origin="1899-12-30")
issues$updateTime <- as.Date(issues$updateTime, origin="1899-12-30")
issues$createTime <- as.Date(issues$createTime, origin="1899-12-30")
4. 项目数据分析
现在数据基本准备好了,我想从redmine的数据中分析出什么呢?
redmine管理有字段叫缺陷(defect),这个词是测试专用名词,其实就是我们常说的软件项目中的bug。那我就先统计一下缺陷的平均生存时间是多少天。
为什么统计这个指标呢?因为缺陷的生存时间在一定程度上可以反映出大家使用redmine处理缺陷的效率。更直白的讲缺陷的生存时间是从测试人员在redmine中创建一个缺陷开始,到这个缺陷通过测试人员验证并将这个缺陷关闭为止。所以我需要关注的是已关闭的缺陷。
issuesClosed <- issues[issues$status=="已关闭",]
issuesClosedDefects <- issues[issuesClosed$track=="Defect",]
obj <- issuesClosedDefects[,c("issueNo","project","updateTime","createTime")]
obj$duration <- as.numeric(obj$updateTime-obj$createTime)
average <- sum(obj$duration) %/% nrow(obj)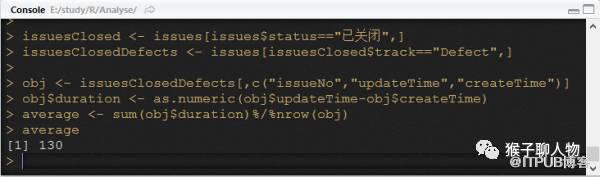
结果显示,缺陷的平均生存时间是130天,这体现了大家使用redmine管理缺陷的效率很低。
统计完总的平均生存时间,我想再看看不同的子项目之间这个数据有多大差别。
#计算每个子项目的平均缺陷生存时间
counts <- data.frame(table(obj$project))
counts$totals <- tapply(obj$duration, obj$project, sum)
counts$averages <- counts$totals %/% counts$Freq
由于项目名称太长,所以给行名加前缀p来做项目名称,用于绘图。
counts$names <- row.names(counts)
counts$names <- paste("p", counts$names, sep="")
清理无效数据
这里认为项目的缺陷个数小于5,或者平均缺陷生存时间等于0的项目为无效数据。
#clean
results <- counts[!(counts$Freq<5 | counts$averages=0),]
绘制柱状图
#draw
barplot(results$Freq,
        main="Average Duration",
        xlab = "Project",
        ylab = "Duration",
        names.arg = results$names)
下面生成的柱状图中,纵轴表示各个项目中缺陷的平均生存时间,横轴表示各个项目的名称。

通过数据分析结果,我们可以清晰的看到哪个项目的平均生存时间长,作为项目经理的你就可以有效的针对不积极处理bug的项目进行有效监督和管理。
虽然这次实践只是统计了一下缺陷的平均生存时间,但是跟仅仅把猴子老师在“闯关游戏”第2关中讲的例子代码敲一遍相比,内心的成就感要更强烈。
不仅是因为在实践过程中自己通过搜索引擎解决了几个问题,还因为这是我第一次将大数据社群中所学的知识运用到自己的实际工作中,让我对数据分析有了更真切的感受。
增长黑客是这几年在美国互联网界很流行的概念,它是一种介于技术和市场之间的团队角色,和传统的靠砸钱获取用户不同,主要靠技术和数据等低成本手段达成增长目标。
一般在一个增长团队中有两个重要的角色,一个是增长负责人,一个是目标负责人。
增长负责人,可能是负责增长的副总裁或者是产品经理,总之是一个能够领导增长团队的人。他要能管理团队产品的测试流程,确保产品有足够的测试量,并且这些测试都是有效的。
目标负责人为增长团队设定目标,而且能够紧密地跟踪目标进度,了解实现目标的方式。
增长团队是用数据分析来管理项目的,比如说,推特曾经发展得非常快,但很快这种增长就暂停了。2010年,公司出现增长停滞后,它们又成立了新团队,新加入团队的副总裁说,现在产品的测试量不够,几个月做几次测试太少,必须每周做十次测试。测试次数增加之后,团队经过数据分析可以更快地发现问题,增长就恢复了。
原文作者:猴子数据分析;如有侵权,请联系管理员删除。

