今天R语言给我帮了一个大忙,简单的几行代码几乎节省了我一天的时间,小白表示R语言太有用了。
事情是这样的。我想获取海关统计网页中表格里的数据,网页表格如下图:
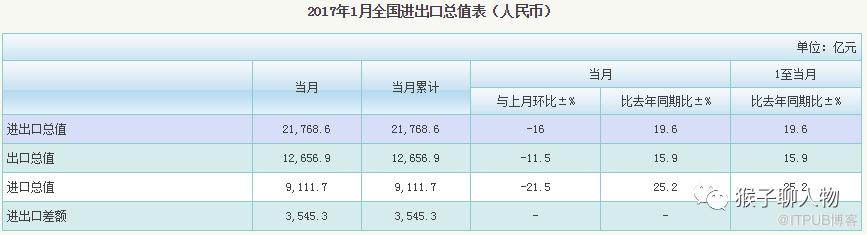
数据来源:http://www.chinacustomsstat.com/aspx/1/NewData/Stat_Data.aspx?State=1&next=1
但是呢,很坑爹的是,这个表格不能复制粘贴,Ctrl+C,Ctrl+V后出来的只是网址,估计是被禁用了复制粘贴功能。而如果一个一个敲的话工作量会很大,估计最后眼都要瞎了。
整个数据量也非常大,有2014-2017年四年的数据。而每年有7个项目,每个项目分成12个月,共计336个表,有的表内容还特别多,数字特别大。照这个工作量,一个数一个数敲到Excel中的话,一天不吃不喝估计都搞不定。
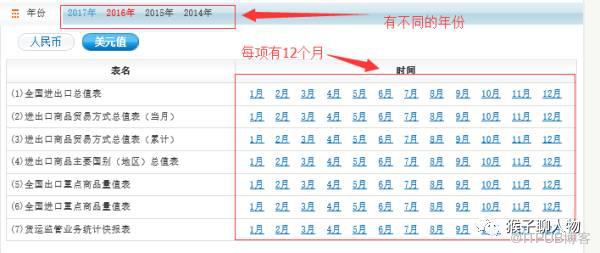
幸运的是,我最近刚入门了数据分析R语言。听说R语言也有爬取数据的功能,于是在网上简单的搜了一些帖子后,利用了XML包,成功的将这网页中的336个表存成了Excel格式。
代码如下:
#安装XML包
>install.packages(“XML”)
#载入XML包
>library(XML)
#写入表格所在的网址
>u<-"http://www.chinacustomsstat.com/aspx/1/NewData/Stat_Class.aspx?state=1&t=2&guid=7146"
# 读取网页中的表格
>tbls<-readHTMLTable(u)
如果网页包含多个表格,需要确定读取哪个表。可通过识别表的行数来确定。
#读取网页中的第一张表
>pop<-readHTMLTable(u,which=1)
#存储结果到CSV文档中
>write.csv(pop,file="d:/pop.csv")
这样,就快速实现了网页中的数据爬取。第一次将R语言运用到工作中去,灰常有成就感。
但是毕竟有336个网页,如果最后要运行336次代码,这肯定不是一个好的办法。进一步考虑到第4关的知识:自定义函数。考虑到同一类的网址只有最后四位数字不一样,就可以将上述的业务逻辑写到一个自定义函数中,然后用循环处理一下就可以了。
本文内容来自 大数据社群 会员实践笔记 (知乎:小熊猫)。
学习数据分析最大的好处是可以打开一个新的世界,这个世界里的知识可以极大的提高你现在的工作效率。将你从重复的手动劳动中解放出来。
上面提到获取页面表格可以使用R中的XML包。如果你要获取其他网页中的数据,可以使用R语言中最常用的爬虫工具RCurl包。这个包广泛用于在互联网上抓取各种数据源,例如金融数据,行情数据,价格数据,体育数据等,用于进行后续建模分析。

具体如何使用RCurl包爬取网页数据和进行分析呢?
可以点击下面“阅读原文”看大数据社群会员 李博 的实践案例《在天猫网页上抓取数据和分析情况报告》
原文作者:猴子数据分析;如有侵权,请联系管理员删除。

