我经常会看到一些缺乏统计概率常识的问题。比如这样的问题:
为什么一个清华毕业的,收入还干不过咪蒙?
这些问题,在朋友圈,微博,知乎上都引起了广泛讨论,不少人找了一堆理由来解释。但在我眼里,它们都是很低级的问题。
为什么这样说呢?
如果提问者懂一些统计概率的常识,这样的问题根本就不应该被提出来。要避免犯这样的低级错误,我们需要学习下面的总体和样本的知识。
不管是我们每天看到的新闻,还是现在很流行的人工智能,大数据,统计分析都需要处理数据,那么数据从哪里来呢?
有的时候搜集数据很容易,你可以获得研究对象的全部数据。
例如淘宝所有的用户,每一次上淘宝,所有的行为都会被记录下来。包括用户看了哪些商品,在某一个商品的详情页上停留了多久,用户最后购买了什么,这些数据都会自动地记录到淘宝的系统中。
通过对手机淘宝 天猫超市 用户使用时段的研究,可以发现用户主要在晚上使用手机淘宝里面的天猫超市子频道,21点达到最高峰。
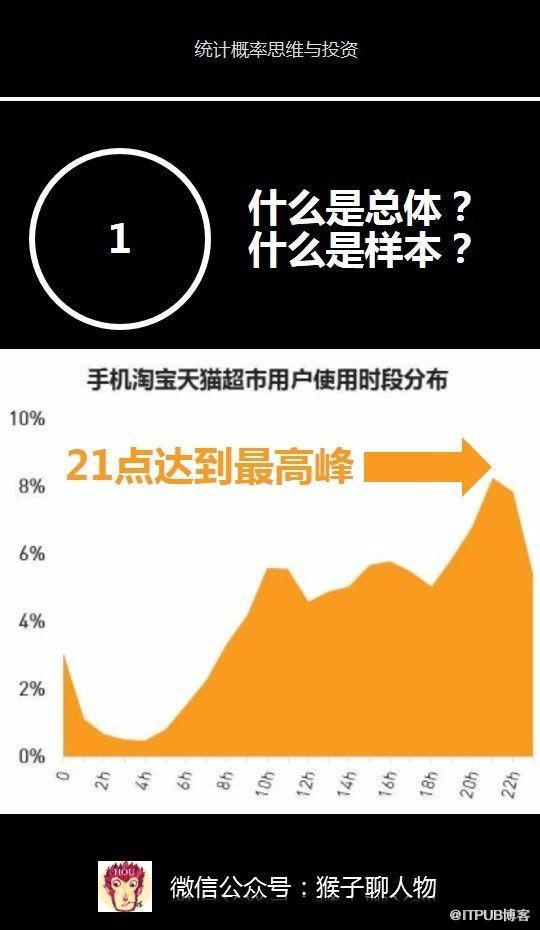
但现实生活中,也有很多情况你是无法像淘宝这样得到总体数据的,这时候就要用到抽样的方法,通过样本来推断出总体。
例如我想用统计概率的知识告诉你这个问题的答案:
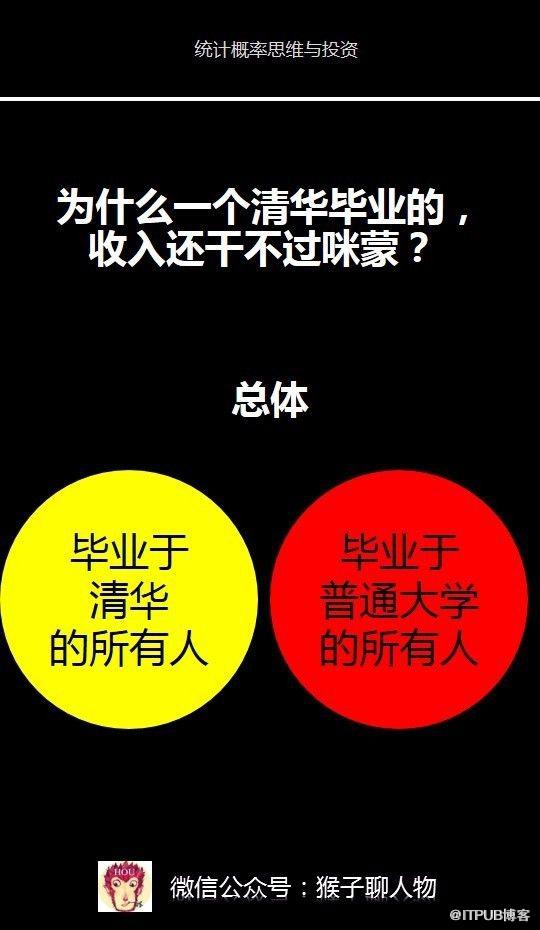
为什么一个清华毕业的,收入还干不过咪蒙?
首先,我需要要对两个群体对象进行比较:
第1个群体是所有毕业于清华人的平均收入。
第2个群体是像像咪蒙这样毕业于普通大学的所有人的平均收入。
我在这里画了2个大圆圈代表这两个群体对象,也就是两个总体。
接下来问题就来了。
我发现在获取每一位毕业生的收入是不可能做到的。因为没有任何的统计机构能追踪每一个人的人生轨迹。
然而我还想知道总体的平均收入,怎么办呢?
最恰当的方法可能就是,随机地从总体中选取一些人作为样本,然后根据样本的平均值来估计总体的平均数。
下面图片我在总体里画了白色的圆圈表示样本。

这里选取样本要注意两点:
1)随机抽取总体的人
我可不想我的样本里,毕业于普通大学的全是像咪蒙这样的成功创业人才,因为这会脱离了真实情况。
毕竟不管你是否毕业于名校,都有可能是每天挤地铁的公司普通员工,也有可能是开着宝马的高管,或者家里有个像王健林那样的爹。
所以,选取的样本应该把每种情况包括在内,才能代表总体。
2)抽取的样本大小要足够多
人们习惯通过很少的观察值,就得出结论。这样的结论,往往就存在样本不足导致的偏差。但是,只有样本足够多才能代表总体。
提出这样低级问题的人:为什么一个清华毕业的,收入还干不过咪蒙?
就是这个样本中只有咪蒙这1个特例数据,样本即不是随机的,同时样本也太少,并不能代表总体,所以得出了错误的结论。
那么样本数量选取多少合适呢?
有一个经验是,样本大小必须达到30以上,当然在允许的情况下,数量越多越好。
这样你就抽取了2个样本,一个是毕业于清华的人,一个是毕业于普通院校的人。每个样本有100人。
最后你统计后发现,毕业于清华的平均收入 大于 毕业于普通院校的平均收入。
这里的总体就是指清华毕业的所有人,样本就是从所有毕业与清华的人中随机抽取的人。
以后再有人提出类似这样低级的问题:为什么一个清华毕业的,收入还干不过咪蒙?
你就要考虑:他说的是总体,还是样本?如果是样本,那么这个样本是随机抽取的,还是特例?样本大小有多少?
抽样也经常发生在实际生活中,公司在发布产品前,为了了解用户的喜好,也要进行抽样。
微软在产品发布前,常会邀请典型用户(样本),比如办公室文员,家庭妇女到装有单向玻璃的观察室,请他们独立完成一项任务,比如网上购物,并用摄像头记录他们的所有行为。工程师们站在玻璃的另一边,记录和分析用户的行为,对用户体验不好的地方进行优化化产品。
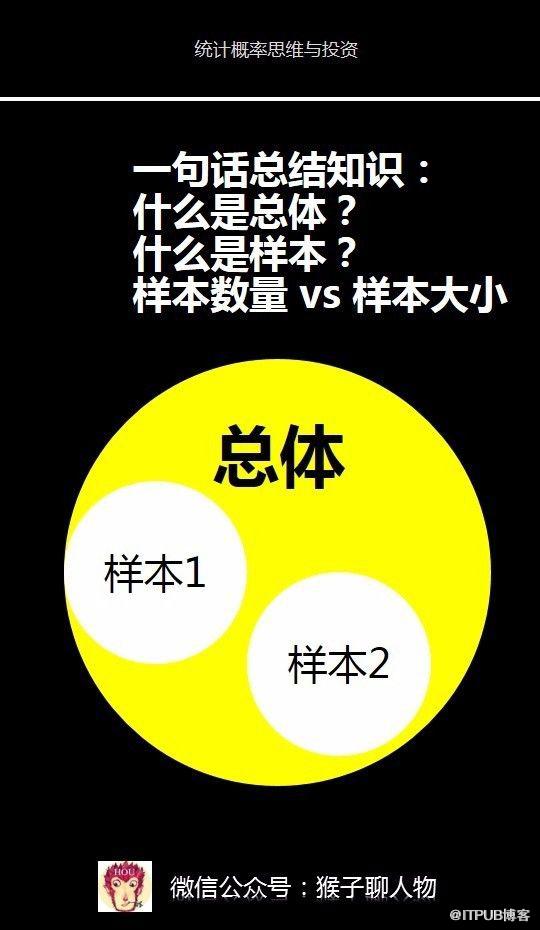
1. 总体是你研究对象的整个群体。例如所有毕业于清华的人。
2. 样本是从总体中选取的一部分,用于代表总体。例如随机抽取的100个毕业于清华的人构成一个样本。
3.这里要重点区分两个经常混淆的概念。样本数量是你有多少个样本。样本大小是每个样本里面有多少个数据。
例如我从总体中抽取了5个样本,每个样本有100个清华毕业的人。这里5个样本就是样本数量,而样本大小是指每个样本有100个人。
原文作者:猴子数据分析;如有侵权,请联系管理员删除。

