
什么是知识众筹?投资者选择自己看好的知识分享项目,并与知识分享者一起享受项目分红。
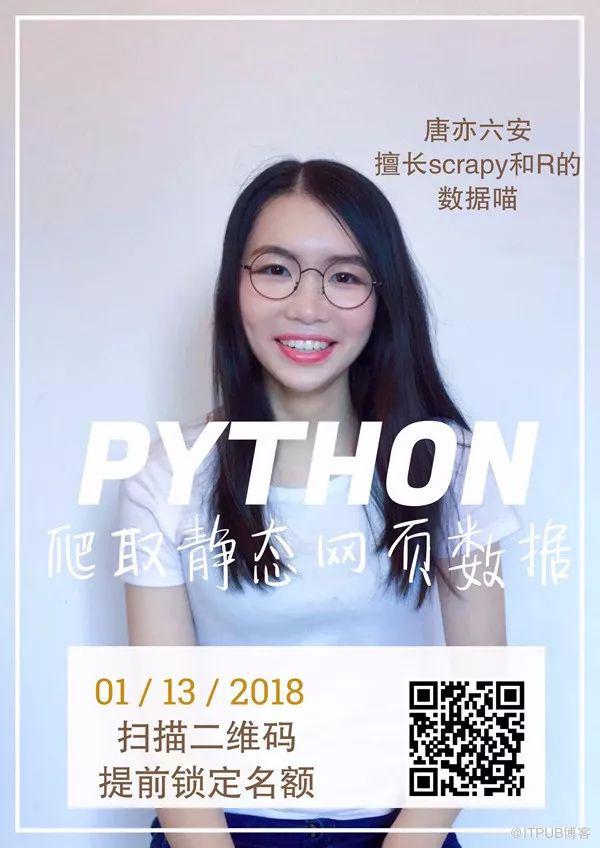
本期项目邀请了猴子数据分析社群会员、擅长Python爬虫的 唐亦六安。
网络爬虫,通俗点讲,就是从网页获取你想要的数据。房地产人员可能会想得到房价数据,运营人员可能想得到竞争对手数据,数据分析新手发愁没有数据练手。第三方数据获取平台又太贵,想要获取数据怎么这么难呢?
于是你上网查了下,发现一个叫Python的东东可以做到从网页爬取数据,也就是所谓的“爬虫”。
然而你发现自己需要学习的东西太多太多: http中的post,get,API,各类反爬机制,ip代理池,selenium,管道函数等等。
可自己又不是专业的爬虫工程师,该怎么办呢?
任何爬虫相关的书或者网课都是层层深入,可这些知识是大而全的,可能对于获取数据会告诉你四五种方式,自己造轮子或者调框架,解析函数用beautifulsoup4,request,xpath,css等五花八门的方法。最后你发现,换个网站你还是不会。
如果你想成为一名专业的爬虫工程师,不好意思,没有捷径可走,请从造轮子学起,踏踏实实学习爬虫的每个知识点。如果你只是想利用python获取数据,其实完全可以通过调用更改代码模板来获取数据。这个”模板”就是Python的scrapy框架。
我是唐亦六安,猴子数据分析社群成员,本科统计专业,善于调用Python的scrapy框架获取数据。成功爬取过豆瓣、房天下等网站数据,在知乎写数据分析相关实践笔记,5周时间内知乎文章收藏量破2K,个人页面浏览量破万,本次分享我将分享自己是如何从零学会数据分析的,并讲述自己如何调用Python中scrapy框架获取想要的数据。
分享内容包括以下4部分:
第1部分:我是如何从零学会数据分析的?
第2步部分:什么是爬虫?如何利用Python爬取数据?
别人口中的“网络爬虫”究竟是什么?为什么那么多人都在用爬虫?
第3部分:Python scrapy框架安装及基础知识讲解
不造轮子,直接从调用scrapy框架说起,包括scrapy安装及组件介绍,xpath语法讲解,如何将数据存储到本地,遇到问题如何进行调试等
第4部分:新手爬数据常见的坑及解决方案
遇见不让爬的网站如何做?xpath解析数据为空怎么办?文件乱码怎么解决?等常见问题都会讲解。
第4部分:项目实战 -大众点评美食数据获取
最后通过实战项目带你轻轻松松完成一次爬数据之旅
本次分享适合的人群:
不知道如何获取数据的数据爱好者
Python零基础但想直接调用代码模板获取数据的上班族
不想”造轮子,想直接从scrapy框架学习爬数据的大学生或在职人员
在scrapy学习中不知道如何进行调试的初学者
知识众筹项目参与规则非常简单:
1. 凯文凯利在新书中说“现在最缺乏的不是答案,而是好的问题”,为了能有效帮助到你,在下面留言框留言一个与“数据分析”相关的问题,留言点赞数前5名自动成为本期项目投资人(截止时间2018年1月13日 20:00)
2. 本期付费知识课程结束后,投资人会被邀请进入股东群,进入分红阶段:投资人与知识分享者按课程净收入的二八分成(5位投资人平分其中的二)。

原文作者:猴子数据分析;如有侵权,请联系管理员删除。

