传统的离线数仓数据延迟比较大,实时性比较低,不能满足实时指标计算场景,因此构建实时数仓成为当前迫切需求
一、离线数仓
如果数据的实时性并不是非常重要,那么在建立数据仓库时,通常会优先考虑建立离线数据仓库。
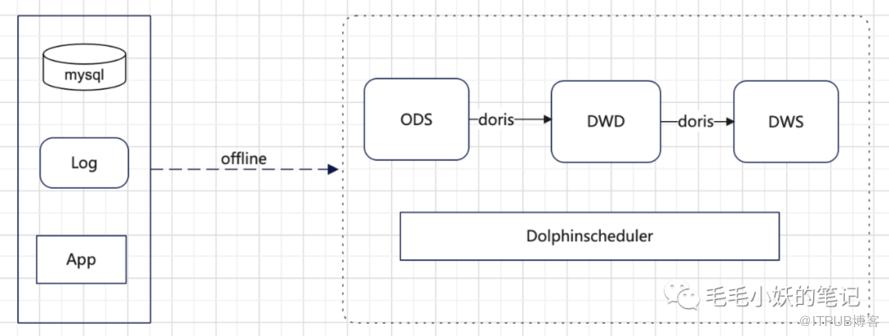
1. 技术实现
使用doris作为数据存储和计算以及分析查询的引擎
使用Dolphinscheduler作为任务调度
2. 优缺点
结合海豚调度,能够自动化实现T+1的数据采集、加工等
计算结果实时性的比较低,只能用于离线处理
二、Lambda架构
Lambda架构保留实时层、批处理层两条处理流程。批处理层用于离线处理大量数据,实时层用于实时处理数据,即最终会同时构建实时数仓和离线数仓。

1. 处理流程
Flink实时读取Kafka数据,回写到
kafka ods贴源层topicFlink实时读取Kafka的ods层数据,进行实时清洗和加工,结果写入到 kafka dwd明细层topic同样的步骤,Flink读取dwd层数据写入到
kafka dws汇总层topic
2. 优缺点
Lambda架构的优点是能够处理大量数据,同时也能够提供实时查询功能。
缺点是需要维护多个代码库和技术栈,增加了复杂度。
三、Kappa架构
不同于Lambda架构,Kappa架构则是将Lambda架构中的批处理层去掉,只保留速度层和服务层。这种架构模式将所有数据都视为实时数据,通过流式处理进行实时计算和分析。
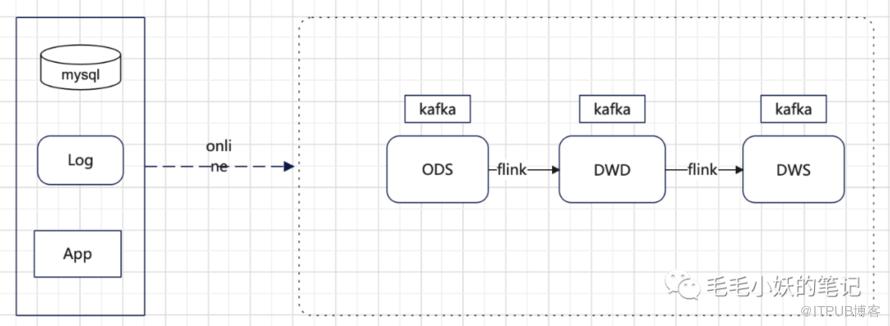
优缺点
Kappa架构的优点是简化了架构,减少了复杂度,同时能提供实时查询功能。
缺点是只能处理实时数据,无法进行离线处理。
四、改进的Kappa架构
随着数据湖技术的兴起,我们可以将kafka替换为数据湖,这样就能够支持数据回溯,支持数据更新,实现数据批流读写,支持实时接入。
目前市场上最流行的数据湖为三种: Delta、Apache Hudi和Apache Iceberg。其中Delta和
Apache Hudi对于多数计算引擎的支持度不够,特别是Delta完全是由Spark衍生而来,不支持Flink。对于Iceberg,Flink是完全实现了对接机制,且目前已经接入了doris,可以直接在doris中查询iceberg的数据,一起来看看其具备的功能:基于
快照的读写分离和回溯流批统一的写入和读取非强制绑定计算引擎
支持
ACID语义支持表、分区的
变更特性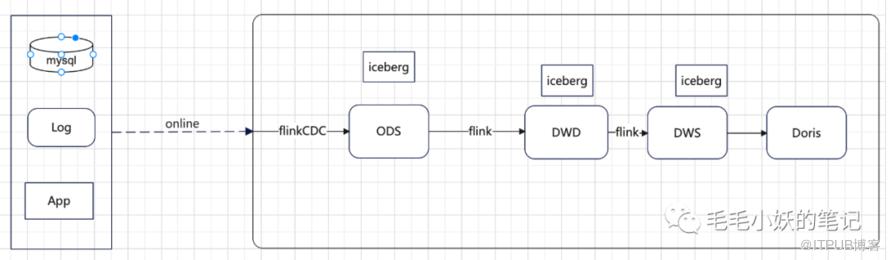
处理流程
存储介质由Kafka换成Iceberg,其余技术栈保持不变
Flink读取源头Kafka数据,结果存储到Iceberg ods层
继续执行后续的ods->dwd->dws层计算、结果存储
通过doris进行实时olap引擎查询分析、报表展示
五、总结
综上分析,技术架构为flink + iceberg + doris
flinkCDC将数据增量的从mysql或者kafka拉取到iceberg中,即ODS层。或者使用原有的数据接入功能将数据接入,增加对iceberg的支持。 如果需要进一步清洗,则再使用flink将ODS数据读取进行ETL再存储到DWD层。 如果需要进一步聚合,则再使用flink将DWD或者ODS数据进行汇总存储到DWS层。 最后通过flink对需要计算的实时指标进行计算并存储到doris。 在进行报表展示时可直接从doris读取计算结果。
六、iceberg的简单使用
最后简单讲一下iceberg的使用,便于我们理解和使用数据湖。
# 启动flink集群
./start-cluster.sh

# 启动flink-sql客户端
./sql-client.sh embedded
-j /Users/casey/Data/install/flink-1.15.2/lib/iceberg-flink-runtime-1.15-1.1.0.jar

# 创建catelog
CREATE CATALOG hadoop_catalog WITH (
'type'='iceberg',
'catalog-type'='hadoop',
'clients'='5',
'property-version'='1',
'warehouse'='hdfs://172.22.224.113:8020/user/hive/warehouse'
);

# 使用刚创建的catelog
use catalog hadoop_catalog;

# 创建数据库
create database iceberg_sjc;

# 使用刚创建的数据库
use iceberg_sjc;

# 创建表
create table testA(
  id bigint,
  name string,
  age int,
  dt string)
PARTITIONED by(dt);

# 插入数据
insert into testA values(1001,' 张三',18,'2021-07-01'),(1001,' 李四',19,'2021-07-02');
原文作者:毛毛小妖的笔记;如有侵权,请联系管理员删除。

