在上一篇文章中,我们介绍了如何使用 Flink CDC 将 mysql 数据接入 Doris 数据库。
这次我们来探讨下如何快速将 kafka 数据快速接入 Doris 数据库。这次我们将使用 Doris 提供的另外一种导入方式:Routine Load。
一、Routine Load介绍
Doris Stream Load 也可以将 kafka 数据接入 Doris。但是 Doris 为 kafka 数据接入提供了一种新的方式,不用写任何代码,只需要通过简单的几行命令就可以快速的将 kafka 数据接入 Doris 了,这就是 Routine Load,这种方式支持向 Doris 提交一个常驻的导入任务,通过不断的从指定的数据源读取数据,将数据导入到 Doris 中。
其原理如下图:
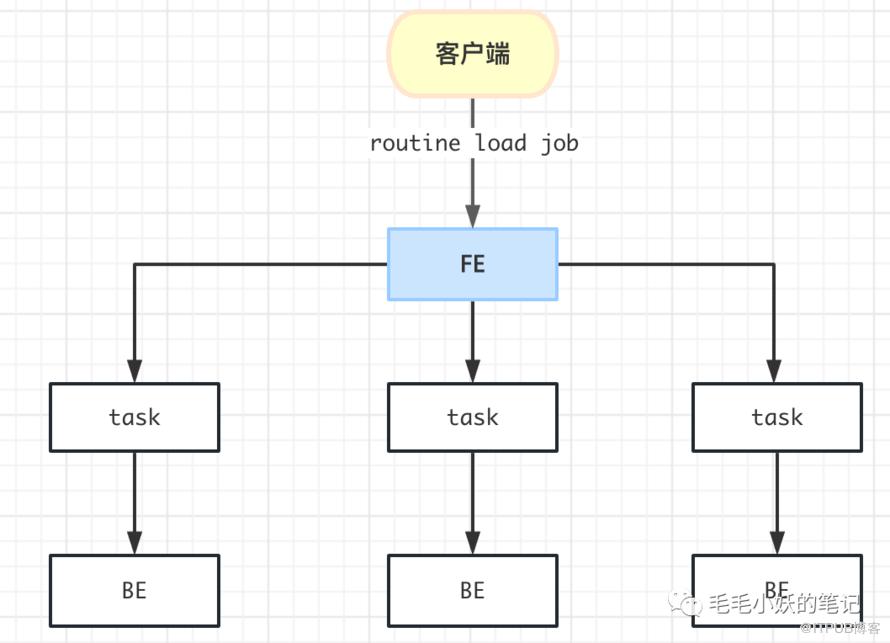
客户端向 FE 提交一个 Routine Load 作业 FE 通过 JobScheduler 将一个 Routine Load 作业拆分成若干个 task。每个 task 负责导入指定的一部分数据。task 被 TaskScheduler 分配到指定的 BE 上执行 在 BE 上,一个 task 被视为一个普通任务,通过 Stream Load 的导入机制进行导入。导入完成后,向 FE 汇报导入情况 FE 中的 JobScheduler 根据汇报结果,继续生成后续新的 Task,或者对失败的 Task 进行重试
注意:
Routine Load支持的格式为 csv 和 json。json可以是 jsonObject,也可以是 jsonArray 仅支持 Kafka 0.10.0.0(含) 以上版本
二、Routine Load实践
1. 建表准备
CREATE TABLE demo.student (
  `id` int NOT NULL COMMENT "id",
  `name` varchar(32) NULL COMMENT "name",
  `age` int NULL COMMENT "age"
) ENGINE=OLAP
UNIQUE KEY(`id`)
COMMENT "学生信息表"
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
"replication_allocation" = "tag.location.default: 3",
"in_memory" = "false",
"storage_format" = "V2"
);
2. kafka数据准备
必须先创建 topic 才能创建后续的 routine load,否则会创建失败。
csv 格式数据 topic :test_job_csv
1, 小明 ,18
2, 小花 ,21
json 格式数据 topic :test_job_json
{"id":3,"name":"小刚","age":18}
json 数组格式数据 topic :test_job_json_arr
[{"id":4,"name":"小夏","age":22},{"id":5,"name":"小小","age":32}]
3. csv 格式的 Routine Load 任务示例
数据格式:csv 指定列分隔符为: ,指定列名为:id, name, age 指定 group.id:"test_job_group_id" 指定 client.id:"test_job_client_id" 指定过滤条件:id < 100 指定消费分区:0 指定消费位置为有数据的位置(OFFSET_BEGINNING)开始消费
CREATE ROUTINE LOAD demo.test_job_csv ON student
COLUMNS TERMINATED BY ",",
COLUMNS(id, name, age),
WHERE id < 100
PROPERTIES
(
    "desired_concurrent_number"="3",
    "max_batch_interval" = "20",
    "max_batch_rows" = "300000",
    "max_batch_size" = "209715200",
    "strict_mode" = "true"
)
FROM KAFKA
(
    "kafka_broker_list" = "ip1:9092,ip2:9092",
    "kafka_topic" = "test_job_csv",
    "property.group.id" = "test_job_group_id",
    "property.client.id" = "test_job_client_id",
    "kafka_partitions" = "0",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
show routine load
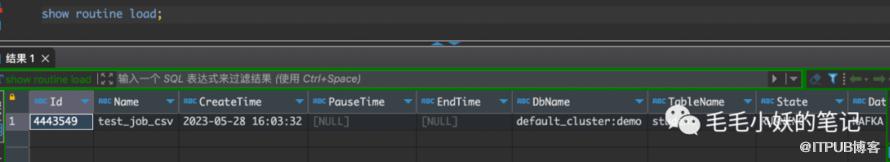
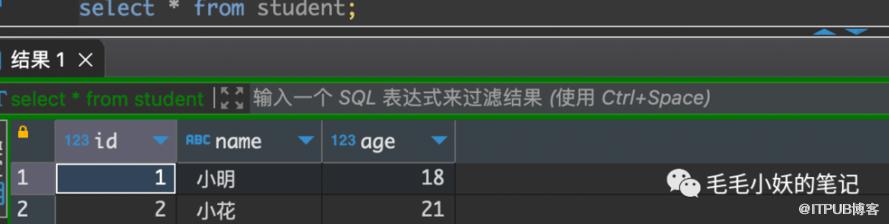
我们再来查看一下表中是否有数据,由于任务创建成功首次消费会有一定延迟,可以等会儿再查看,我们看到数据已经成功入库了:
4. json 格式的 Routine Load 任务示例
数据格式:json 指定列名为:id, name, age 指定 group.id:"test_job_json_group_id" 指定 client.id:"test_job_json_client_id" 指定过滤条件:id < 100 指定消费分区:0 指定消费位置:从每个分区的 offset 为0的位置消费
CREATE ROUTINE LOAD demo.test_job_json ON student
COLUMNS(id, name, age),
WHERE id < 100
PROPERTIES
(
    "desired_concurrent_number"="3",
    "max_batch_interval" = "20",
    "max_batch_rows" = "300000",
    "max_batch_size" = "209715200",
    "strict_mode" = "true",
    "format" = "json",
    "jsonpaths" = "[\"$.id\",\"$.name\",\"$.age\"]",
    "strip_outer_array" = "false"
)
FROM KAFKA
(
    "kafka_broker_list" = "ip1:9092,ip2:9092",
    "kafka_topic" = "test_job_json",
    "property.group.id" = "test_job_json_group_id",
    "property.client.id" = "test_job_json_client_id",
    "kafka_partitions" = "0",
    "kafka_offsets" = "0"
);
show routine load

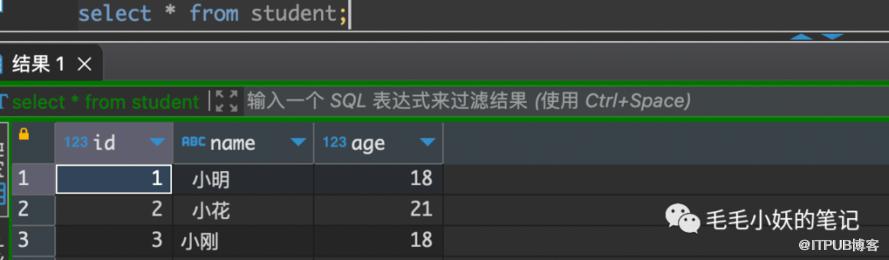
5. json 数组格式的 Routine Load 任务示例
"strip_outer_array" = "true"。这样就可以成功的将 json 数组格式的数据通过 Routine Load 接入 Doris 了。这里就不做演示了,感兴趣的小伙伴可以自行尝试。
需要注意的是:topic 的数据只能是 csv,json 或者 json array 中的一种,不能将数据混合到一起,否则会导致任务异常终止的。
三、任务参数说明
1. COLUMNS TERMINATED BY
2. COLUMNS
3. WHERE
4. PROPERTIES
desired_concurrent_number:任务的并发数设置 max_batch_interval:数据的拉取的最大间隔 max_batch_rows:数据拉取的最大数据条数 max_batch_size:数据拉取的最大数据量 strict_mode:是否开启严格模式,默认为false format:数据格式:csv,json。默认为csv jsonpaths:数据中字段的名字,不填写则 Doris 表字段必须与数据字段个数保持一致 strip_outer_array:json 数据的格式,false 则为jsonObject,true 则为数组格式。csv 格式的数据不需要这个参数
5. FROM KAFKA
kafka_broker_list:kafka broker列表 kafka_topic:kafka topic名称 property.group.id:group 消费者组id property.client.id:客户端id,不填写则会自动生成 kafka_partitions:topic分区,多个分区以逗号分隔。去掉这个参数则消费所有分区 property.kafka_default_offsets:每个分区默认的 offset 位移 kafka_offsets:分别设置每个分区的 offset 位移,多个分区以逗号分隔
四、Routine Load 常见操作
1. 查看 routine load 任务
show routine load
2. 修改 routine load 任务
ALTER ROUTINE LOAD FOR [db.]job_name
[job_properties]
FROM data_source
[data_source_properties]
[db.]job_name
指定要修改的作业名称job_properties
指定需要修改的作业参数data_source
修改数据源,目前只支持 kafkadata_source_properties
kafka 相关属性
3. 暂停 routine load 任务
PAUSE [ALL] ROUTINE LOAD FOR job_name
暂停名称为 test 的任务
PAUSE ROUTINE LOAD FOR test;暂停所有任务
PAUSE ALL ROUTINE LOAD;
4. 停止 routine load 任务
STOP ROUTINE LOAD FOR job_name;
停止名称为 test 的任务
STOP ROUTINE LOAD FOR test;
5. 恢复 routine load 任务
RESUME [ALL] ROUTINE LOAD FOR job_name
恢复名称为 test 的任务
RESUME ROUTINE LOAD FOR test;恢复所有任务
RESUME ALL ROUTINE LOAD;
五、总结
在集群资源允许的情况下,使用 Routine Load 能够大大减少我们的代码开发量,同时使用起来也特别方便,使用简单的几个脚本即可将 kafka 数据接入 Doris,还是挺香的。
原文作者:毛毛小妖的笔记;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
