1.理解什么是IO
首先从字眼上去理解I/O 其实就输入和输出的缩写,在计算机上的IO其实是指:
I:输入是指系统接收的信号或数据。 0:输出是指从系统发出的数据或信号。 IO执行:进行数据的输入和输出 I/O设备是指用户和计算机之间沟通的载体: 键盘或鼠标(输入设备···) 显示器和打印机(输出设备···) 调制解调器和网卡(输入和输出同时处理) 磁盘IO 网络IO 内存IO
计算机中的一个程序和运行时数据是驻留在内存中,由CPU来执行调度,涉及到数据交换的地方,通常是磁盘、网络等,就需要IO接口(所以一般网络上常说的IO都是指这个磁盘IO和网络IO)
2.IO中的数据流
数据流的分类:
按数据流向: 输入流和输出流 按数据流动数据形式:字节流,字符流,缓冲流
如JAVA中常见的一些输入输出流: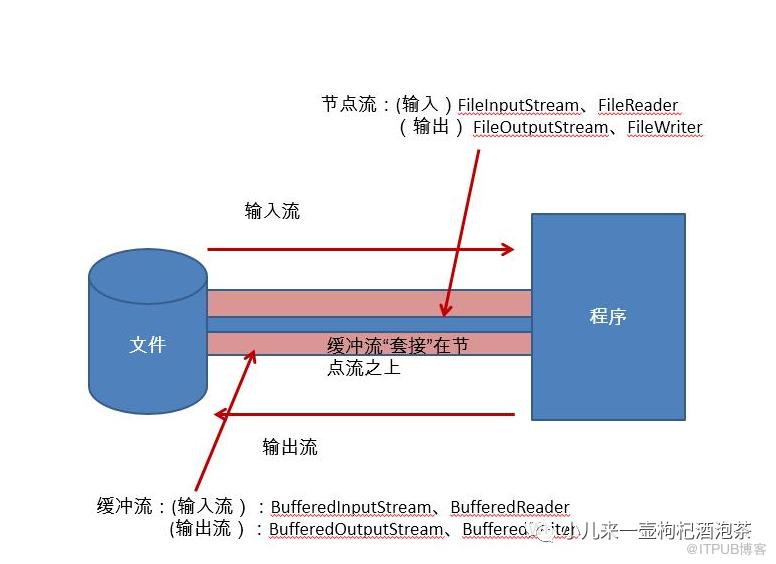
3.IO的操作和文件描述符的关系
在unix的操作系统,一切皆文件,所谓的文件其实就是指:一串二进制流。对应复杂操作系统中引入了文件描述符来绑定相关的IO的操作。
PS:文件描述符是由无符号整数表示的句柄,进程使用它来标识打开的文件。文件描述符与包括相关信息(如文件的打开模式、文件的位置类型、文件的初始类型等)的文件对象相关联,这些信息被称作文件的上下文。
在UNIX、Linux的系统调用中,大量的系统调用都是依赖于文件描述符。所以在某种程度是对文件描述符fd的操作就是数据流的操作。
具体的进程和文件描述的关系:可以参考:https://blog.csdn.net/qq_40772498/article/details/108782099
4.IO速度引发同步IO和异步IO
因Cpu和内存处理的数据的程度远高于我们的其他外设的速度,如磁盘速度,或其他网络IO数据的读取。因为速度的不匹配的问题,所以为了高效的处理多任务就是是并发的执行任务,索引引入了同步IO和异步IO:
同步IO:就是CPU执行某个IO任务的时候,我们的程序一直干等着(主线程只能挂起)IO的结果返回,如(等待网络数据返回),才继续执行下一个任务。
PS:IO操作需要等待数据过程中阻塞了当前线程,导致其他代码无法执行,此时我们可以引入多线程或多进程并发执行任务,为多个用户进行服务。各自的线程和进程之间的相互不影响,各自的线程如遇到IO导致线程被挂起,其他用户的线程不受影响。
多线程和多进程模式的缺点:
1:不能无限新增线程和进程。 2:多线程和多进程多的情况增加系统开销,需要开辟更多的虚拟空间 3:进程和线程的上下文的切换所需的系统开销大。
异步IO:就是CPU执行遇到IO任务的时候,我们的程序不会一直干等着这个IO结果的返回(主线程并没有休息),而是把任务分配下去之后(发出IO指令),并不等待IO结果,我们继续之前下一个任务,等过些时间后,IO处理完成返回结果的时,再通知CPU进行处理。
PS:异步IO模型需要一个消息循环,在消息循环中,主线程会不断重复进行“读取消息-处理消息”的处理。
异步IO模型下,一个线程就可以同时处理多个IO请求。因为线程不会因为IO阻塞而挂起!
5:.同步、异步与阻塞,非阻塞区别
区别
1.阻塞/非阻塞, 它们是程序的一种运行状态,是关于程序在等待消息(无所谓同步或者异步)时的状态描述,它是程序(线程)【等待关注消息】通知时的状态角度来说。
2.同步/异步,是程序【获得关注消息】通知的机制,与消息的通知机制有关的一种描述;
3.同步和异步是个线程处理方式或手段,他们区别是遇到IO请求是否等待。
同步:是指代码调用IO操作时,必须等待IO操作完成才返回的调用方式。 异步:是指代码调用IO操作时,不必等IO操作完成就返回的调用方式
异步操作是可以被阻塞住的:从框架的角度是定义同步和异步:
- flask,bottle,fanlo 是一个同步框架
- FastAPI,Quart,Sanic,Vibora,Tornado····等即支持同步也支持异步异步操作是可以被阻塞住的,只不过它不是在处理消息时阻塞,
而是在等待消息通知时被阻塞。
4.阻塞和非阻塞是线程的一种状态,线程要么处于阻塞,要么处于非阻塞,两者并不相同也并不冲突,它们的主要区别是:数据没准备好的情况下是否立即返回在某个时刻。
阻塞:是指调用函数时候当前线程被挂起。 非阻塞:是指调用函数时候当前线程不会被挂起,而是立即返回.
引起进程阻塞的事件可以有多种多样,比如:
等待I/O完成 申请缓冲区不能满足 等待信件(信号)等····
同步、异步、阻塞、非阻塞的组合
同步阻塞形式: 效率最低 异步阻塞形式: 异步操作是可以被阻塞住的,只不过它不是在处理消息时阻塞, 而是在等待消息通知时被阻塞 同步非阻塞形式:效率低下 异步非阻塞形式: 效率最高
6.完整IO交互必经两阶段
阶段1:用户空间<------------->内核空间
阶段2:内核空间<------------->设备空间
普通的IO示例:
网络IO示例:
7.五种IO模型
7.1阻塞模式IO(Blocking IO)
定义:
进行系统调用的实时,我们的线程会给挂起,且一直阻塞直到内核把数据准备好,之后再由内核缓冲区复制到用户态(用户空间),再等待内核准备的时间段内,什么事也做不了。
优缺点:
优点: 1:开发简单,容易; 2:阻塞期间用户线程挂载,挂起期间不会占用CPU资源。 缺点: 1:一个线程维护一个IO,并发量大的时候需创建大量的线程来维护网络连接,内存和线程开销比较大,不适用于大并发。 2:无论是多线程还是多进程都会严重占据系统资源,降低系统对外界响应效率
改进措施:池化(“进程池”或“线程池”或“连接池”)
无论哪个池,其实都是为了在减少创建和销毁的操作的系统。
如:线程池-减少创建和销毁线程频率,维持合理数量的线程数,并让空闲的线程重新承担新的执行任务,提供线程复用,而不是新建。
如:连接池”也是对已存在的连接进行重用,维持相关连接的缓存池,减少创建和关闭连接的频率。
“池化”方案的优缺点:
优:在一定程度上缓解了频繁调用IO接口带来的资源占用。 缺: 1.“池”的数据量是其上限,如果请求大大超过池的上限时,也会造成请求的处理影响,
使用“池”须考虑我们的请求规模,随时根本情况调整“池”的大小。
7.2 非阻塞模式IO(Blocking IO)
定义:
进行系统调用的时候,内核在没有准备好数据的情况下,返回一个错误码,而程序此时不会休眠,而是一直不断的轮询内核缓存区内的数据是否已经准备好(文件描述符缓冲区是否就绪),如果数据准备就绪,则进行数据拷贝,进行返回。
优缺点:
优点: 1:每次发起IO操作调用,再等待内核数据准备过程中,不会进行挂载,而是直接立即返回,用户线程不会阻塞,实时性较好。 2:阻塞期间用户线程挂载,挂起期间不会占用CPU资源。 缺点: 1:每次都需要询问内核是否有数据准备好(文件描述符缓冲区是否就绪) 2:轮询对于CPU来说是较大的浪费,占用大量的CPU时间,效率不高(web服务器一般不会采取此模式) 3:此模式的轮询是使用用户线程执行进行轮询询问。
PS:在socket套接字可以通过为套接字的描述符属性设置非阻塞式,可以使用此功能.
7.3 多路复用IO(multiplexing I/O)
定义:
和非阻塞模式类似,只是轮询的方式不再是使用用户线程,而是由内核轮询,由内核程序箭头所需要的数据,当数据准备好后,则调用内核函数复制数据到用户空间。
select只负责等,recvfrom只负责拷贝。各司其职!
PS:复用IO的基本思路就是通过slect或poll、epoll 来监控多fd ,来达到不必为每个fd创建一个对应的监控线程,从而减少线程资源创建的目的。
在网络IO中:
多路复用IO主要用于处理多个IO连接时候的场景。在多路复用IO模型中,会有一个线程不断去轮询多个socket的状态,只有当socket真正有读写事件时,才真正调用实际的IO读写操作。
多路复用IO模式,通过一个线程就可以管理多个socket,只有当socket真正有读写事件发生才会占用资源来进行实际的读写操作。因此,多路复用IO比较适合连接数比较多的情况。
如果使用:在多线程 + 阻塞IO 中,每个socket对应一个线程,这样会造成很大的资源占用,并且尤其是对于长连接来说,线程的资源一直不会释放,如果后面陆续有很多连接的话,就会造成性能上的瓶颈。
多路复用IO方式:
select:线性扫描所有监听的fd(文件描述符),有最大数量限制 poll: 和select类似只是数据结构不一样,需在内核中分配一个pollfd结构数据,没有大小限制 epoll: 用于代替poll和select,没有大小限制。使用一个文件描述符管理多个文件描述符。且同时使用事件驱动代替轮询。epoll采用了mmap虚拟内存的映射技术减少了用户态和内核态的数据传输的开销。
优缺点:
优点: 1:系统不需要创建大佬先吃,只使用一个线程,一个选择器就可以同时处理非常多的上千上万的链接,大大减少系统开销。 缺点: 1:本质上,这种模式下的系统调用依然是阻塞式的,还是属于同步IO的范畴,需要在读写事件就绪之后,由系统调用进行阻塞的读写。
对比非阻塞IO模式:
多路复用IO为何比非阻塞IO模型的效率高的原因:因为在非阻塞IO中,不断地询问socket状态的时候是通过【用户线程】 去进行的,而在多路复用IO中,轮询每个socket状态是内核在进行的,这个效率要比用户线程要高的多。
7.4 信号驱动式IO(signal blocking I/O)
定义:
信号驱动式I/O是指进程预先告知内核,使得当某个描述符上发生某事时,内核使用信号通知相关进程。
信号驱动IO模型,应用进程告诉内核:当数据报准备好的时候,给我发送一个信号,信号处理程序对SIGIO信号进行捕捉,并且发起系统调用来获取数据。
首先 开启信号驱动IO套接字,并使用sigaction来进行系统调用安装信号处理,之后系统直接的进行返回,用户线程不挂起,可以继续做其他的,然后等待通知。 数据准备好,内核发送SIGIO信号,通知数据已准备就绪,然后进行系统调用获取数据。
网络IO中:信号驱动IO模型,下当用户线程发起一个IO请求操作,会分配对应的socket一个信号函数,然后用户线程会继续执行,不会挂起,另一方面,当内核数据就绪时会发送一个信号给用户线程,用户线程接收到信号之后,便在信号函数中调用IO读写操作来进行实际的IO请求操作。
PS:这个一般用于UDP中,对TCP套接口几乎是没用的,原因是该信号产生得过于频繁,并且该信号的出现并没有告诉我们发生了什么事情(暂时还不理解这些地方,后续加深理解一下)
7.3 异步IO(asynchronous I/O)
PS:在unix中异步IO函数以aio_或lio_开头
windows下应该是:IOCP是一个Win32 机制,方便于带有控制并发的服务器的并发执行(这个还真不了解,网上有人是这么一说,待了解!)
当应用程序调用aio_read时,(发起一个用户线程执行read),内核一方面取数据报内容返回,另一方面将程序控制权还给应用进程,应用进程继续处理其他事情,是一种非阻塞的状态(不会对用户线程产生任何阻塞,用户线程不会挂起)
内核等待数据准备完成—然后拷贝数据到用户进程内的缓冲区后,内核会给用户线程发送一个信号,告诉它(用户线程)read操作完成了。
PS:也就说异步IO模型中:用户线程完全不需要关心实际的整个IO操作是如何进行的,只需要先发起一个readi请求,当接收内核返回的成功信号时表示IO操作已经完成,可以直接去使用数据了(通过函数调用的方式进行数据处理)。
PS:异步IO依赖信号处理程序来进行通知,(但是通知是IO数据处理结果完成,而不是通知IO数据准备完成)
异步IO是真正的非阻塞,主进程,只需要负责分配IO工作,然后等待IO结果出来完成(数据已经从内核缓存区复制到用户空间内的应用程序的缓冲区)时通过回调函数对数据进行处理。
优缺点:
优点: 1:在异步IO模型中,IO操作的两个阶段都不会阻塞用户线程,这两个阶段都是由内核自动完成,然后发送一个信号告知用户线程操作已完成。 2:用户线程中不需要再次调用IO函数进行具体的读写。 3:在异步IO模型中,收到信号表示IO操作已经完成,不需要再在用户线程中调用iO函数进行实际的读写操作。 4:真正的实现了异步非阻塞模式
总结五种IO模型:
阻塞程度:
阻塞IO>非阻塞IO>多路转接IO>信号驱动IO>异步IO,效率是由低到高的。
对比
前面四种IO模型实际上都属于同步IO,只有最后一种是真正的异步IO,
无论是多路复用IO还是信号驱动模型,IO操作的第2个阶段都会引起用户线程阻塞,也就是内核进行数据拷贝的过程都会让用户线程阻塞
参考资料:
IO概念和五种IO模型:https://www.cnblogs.com/shengguorui/p/11949282.html
python并发编程之IO模型 :https://www.cnblogs.com/haiyan123/p/7465486.html
五种IO模型详解及优缺点 :https://blog.csdn.net/haitaobiyao/article/details/107533649
个人其他博客地址
简书:https://www.jianshu.com/u/d6960089b087
掘金:https://juejin.cn/user/2963939079225608
小钟同学 | 文 【原创】| QQ:308711822
1:本文相关描述主要是个人的认知和见解,如有不当之处,还望各位大佬指正。 2:关于文章内容,有部分内容参考自互联网,如有链接会声明标注;如没有及时标注备注的链接的,如有侵权请联系,我会立即删除处理哟。
原文作者:程序员小钟同学;如有侵权,请联系管理员删除。

最新文章
- 深入FastAPI异步编程-之并发编程(15)-定义全局的支持全局上下文变量和局部上下文的对象可以任意传递了!
- 深入FastAPI异步编程-之并发编程(13)-纠错-修改基于aiojobs库结合aiojobs的和FastAPI框架的示例
- 深入FastAPI异步编程-之并发编程(13)-基于aiojobs库实现类似Background Tasks的效果
- 深入FastAPI异步编程-之并发编程(12)-基于pyee异步事件驱动通知
- 深入FastAPI异步编程-之并发编程(11)-异步中的?同步原语
- 深入FastAPI异步编程-之并发编程(10)-?asyncio.wait 更精细化并发补充说明
- 深入FastAPI异步编程-之并发编程(9)-asyncio.as_completed的补充说明
- 深入FastAPI异步编程-之并发编程(8)-asyncio.gather的补充说明
- 深入FastAPI异步编程-之并发编程(7)番外篇~Windows系统下事件循环插曲
- 深入FastAPI异步编程-之并发编程(6)~事件循环
