一个文件下载器的简单封装思路。
1 aiofiles的简单使用示例
首先关于异步文件的基本的操作,其实和问同步的文件操,不多说直接上示例:
import asyncio
import aiofiles


async def wirte_msg(msg):
    # 通过with方式进行文件的开关操作
    print('开始写入文件')
    async with aiofiles.open("ceshi.txt", "w", encoding="utf-8") as fp:
        # 注意await不能少
        await fp.write(msg)
    print('==========>' * 3)

async def read_msg_readlines():
    async with aiofiles.open("ceshi.txt", "r", encoding="utf-8") as fp:
        # 注意await不能少
        content = await fp.readlines()
        print('每次按行读取整个文件内容,将读取到的内容放到一个列表中,返回list类型:', content)
        print('==========>' * 3)

async def read_msg_readlines_2():
    async with aiofiles.open("ceshi.txt", "r", encoding="utf-8") as fp:
        # 读取每行
        async for line in fp:
            print('每次读取一行', line)

        print('==========>' * 3)

async def read_msg_read():
    async with aiofiles.open("ceshi.txt", "r", encoding="utf-8") as fp:
        content = await fp.read()
        print('全部读取:', content)
        print('==========>'*3)


if __name__ == "__main__":
    asyncio.run(wirte_msg('你好\n我是的谁\n你喜欢吃什么啊!'))
    asyncio.run(read_msg_read())
    asyncio.run(read_msg_readlines())
    asyncio.run(read_msg_readlines_2())
输出的结果为:
开始写入文件
==========>==========>==========>
全部读取: 你好
我是的谁
你喜欢吃什么啊!
==========>==========>==========>
每次按行读取整个文件内容,将读取到的内容放到一个列表中,返回list类型: ['你好\n', '我是的谁\n', '你喜欢吃什么啊!']
==========>==========>==========>
每次读取一行 你好

每次读取一行 我是的谁

每次读取一行 你喜欢吃什么啊!
==========>==========>==========>
2 aiohttp作为客户端时候的最简单下载图片示例:
import aiohttp
import asyncio
import aiofiles


async def main():
    async with aiohttp.ClientSession() as session:
        async with session.get('https://ss0.bdstatic.com/70cFvHSh_Q1YnxGkpoWK1HF6hhy/it/u=611689948,3635607410&fm=224&gp=0.jpg') as response:
            content =await response.read()
            # 异步的方式处理文件
            async with aiofiles.open('a.jpg', 'wb') as f:
                # 并不能少了await
                await f.write(content)

# 可以直接使用run
# loop = asyncio.get_event_loop()
# loop.run_until_complete(main())
# loop.close()
asyncio.run(main())
3 异步的图片下载器的抽象分类和封装
3.1 分析需求
通过上面一个简单的下载图片示例来看,其实里面涉及到我们的结果维度的实体,我们可以对涉及到相关的实体进行抽象出来。
先从上面思考几个问题点:
谁启动我们的事件循环
谁来派发我们的任务到事件循环上
谁来管理我们的任务
派发的任务是怎么样一个性质的请求
响应回来的怎么样的一个请求
我们的对一个任务的请求处理是通过谁去处理
我们的对于请求响应的结果是怎么样处理的
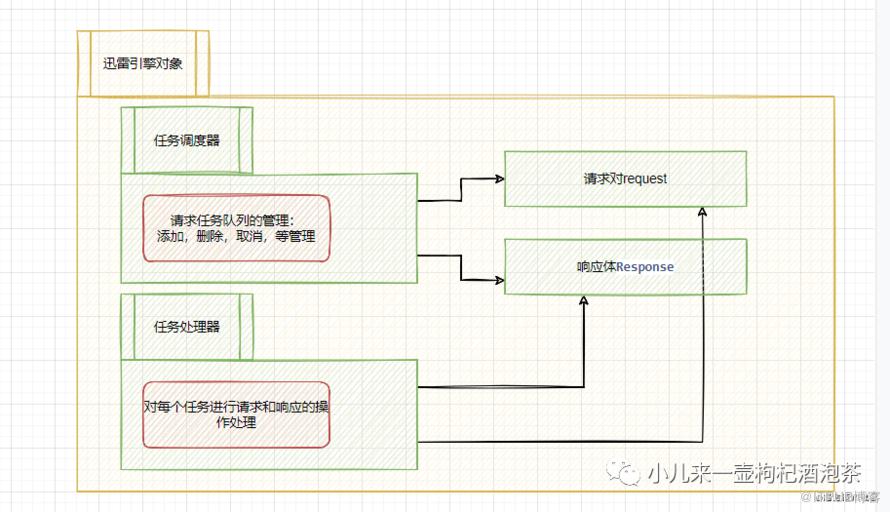
通过对上面问题的思考的话,我们从多个维度的去思考和设计,其中主要涉及的问题如何对我们的下载器进行对于的模型的抽象和分离,于是乎我们的可以大概定义出几个需要涉及到实体对象:
1:首先定义一个启动下载器的引擎对象
2:这个引擎的对象的话,主要负责启动我们的整个时间循环的启动和我们的任务的分发提交到我们的引擎对象上。
3:而关于任务的分发的,我们需要定义一个调度器,用于管理我们的任务处理队列。
4:对于每个任务的来说,我们的又涉及到每一个任务分为:任务的请求体和任务的响应体。
5:每一个任务就是一个抽象好的任务的请求体,每个请求提的任务里面就可以包含很多的信息。比如:
任务的请求URL,
媒体类型,
请求回调
请求的头,
需要的请求方法等。
3.2 初步框架的结构
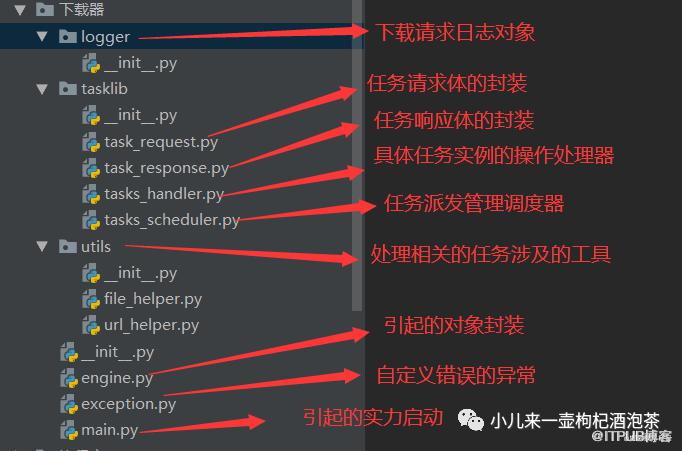
参考某哥的的示例,不过它给的示例我一直无法正常的运行起来,可能是我的姿势不对,所以我自己重新梳理和简化了一篇。
ps:框架的示例参考来自:https://gitee.com/Tefile/corasy 有兴趣的可以去看看这位大哥的,以下的示例大部分来自它的思路。并且加上了更多的注释!方便自己理解!!
3.3 实践
首先我们的从内到外的进行我们的各个实体的对象的抽象封装。
3.1.1 定义任务请求体task_request
from dataclasses import dataclass
from types import MethodType
from typing import Optional


@dataclass
class TaskRequest:
    # 有默认值需要放到最后面去定义

    '''
    定义一个请求中涉及的相关的参数信息
    '''

    # 任务名称
    name: Optional[str] = None

    # 任务请求的URL
    url: Optional[str] = None

    # 任务请求的处理方法
    method: Optional[str] = 'GET'

    # 回调
    callback: Optional[MethodType] = None
    # 请求头
    headers: Optional[dict] = None
    # 编码
    encoding: Optional[str] = 'utf-8'
    # 请求处理的超时时间
    timeout: Optional[int] = 15

    # 是否需要进行代理请求
    is_proxy: Optional[bool] = False

    # 代理请求地址---需要设置的是的IP格式的
    proxy: Optional[str] = '127.0.0.1'

    # POST方式移交的时候--需要的boby参数
    data: Optional[dict] = None
3.1.2 定义任务响应体task_response
from typing import Optional, Any
from .task_request import TaskRequest


class TaskResponse:
    # 类型提示,需要是一个TaskRequest
    def __init__(self, task_request: Optional[TaskRequest], http_response: Optional[Any]):
        # 来自于那个的请求任务对象
        self.request = task_request
        # 最终相应的回来的处理结果对象,还没进行处理的
        self._response = http_response

        # 响应状态
        self.status = http_response.status
        # 响应头信息
        self.headers = http_response.headers

    # def get_json(self):
    #     return  self._response.json()json

    async def get_json(self):
        await self._response.json()

    def get_readbytes(self):
        # 文件的类型
        return self._response.read()
3.1.3 定义任务tasks_scheduler调度器
这里需要引入队列来管理我们的任务的添加和获取
import asyncio

try:
    import uvloop

    # 定义事件虚幻的优先使用uvloop的循环机制
    asyncio.set_event_loop_policy(uvloop.EventLoopPolicy())
except ImportError:
    pass


class TasksScheduler:

    def __init__(self):
        # 定义存贮任务的队列----你可以引入有本地磁盘的存储的队列
        self.queue = asyncio.Queue()

    async def get_one_pending_task_request(self):
        """ 获取一个请求任务 """
        return await self.queue.get()
        # 提取之后,将其添加到已爬取的链接中

    async def add_new_task_request(self, request):
        """ 单个任务请的添加处理 """
        if request is None:
            return
        await self.queue.put(request)

    async def add_batch_new_task_requests(self, requests):
        '''
        批量的添加的请求任务
        '''
        if requests is None:
            return
        for request in requests:
            await self.add_new_request(request)

    def __len__(self):
        '''
        返回的当前队列任务的数量
        :return:
        '''
        return self.queue.qsize()

    def is_has_task_requests(self):

        return self.queue.qsize() > 0
3.1.4 定义任务的处理器-tasks_handler
处理器主要是从我们的调度器里面获取出我们的任务。也就是提取出来我们的请求体的对象。
from .task_response import TaskResponse
import aiohttp
from ..exception import InvalidVerifyException


class TaskHandler:

    # 传入我们的一个请求任务的请求体的对象
    async def fetch(self, task_request):
        # 定义需要处理的请求的中的一些关键字
        kwargs = {}
        try:
            # 提取用户请求体自定义的相关的参数信息:
            if task_request.headers:
                headers = task_request.headers
                # 请求头
                kwargs['headers'] = headers

            # 超时设置
            kwargs['timeout'] = task_request.timeout  # 时间延迟

            # 判断是否需要进行请求代理的设置
            is_proxy = task_request.is_proxy
            if is_proxy and task_request.proxy:
                # 设置请求的代理
                kwargs["proxy"] = task_request.proxy

            # 请求的具体的URL的地址
            url = task_request.url
            # 开始处理请求
            async with aiohttp.ClientSession() as session:
                # 这里可以直接的是session.reques ,

                aiohttp.request
                if task_request.method == "POST":
                    # POST下提交的参数
                    response = await session.post(url, data=task_request.data, **kwargs)
                else:
                    # 提交请求处理
                    response = await session.get(url, **kwargs)
                    print('获取相应状态码', response.status)  # 获取相应状态码

                # 返回一个相应的任务体的对象
                return TaskResponse(task_request=task_request, http_response=response)
        except Exception as e:
            InvalidVerifyException(errcode=2000, errmsg='请求任务{}处理异常'.format(task_request.name))

        return None
3.1.5 定义任务的处理引擎类
from .tasklib.tasks_scheduler import TasksScheduler
from .tasklib.task_handler import TaskHandler
import asyncio
from datetime import datetime


class TasksEngine:

    def __init__(self, mytask_action):
        self.task_limit = 2  # 定义引擎并发数
        self.mytask_action = mytask_action  # 任务实例对象
        self.task_scheduler = TasksScheduler()  # 调度器
        self.my_task_handler = TaskHandler()  # 处理器

    # 启动引擎的方法
    async def start(self):

        # 获取这个引擎对象需要处理的任务列表----哪mytask_action.start_requests返回一个迭代器的对象列表
        start_requests = iter(self.mytask_action.start_requests())
        # 跑任务
        await self.execute(self.mytask_action, start_requests)  # 执行

    async def execute(self, mytask_action, start_requests):
        self.mytask_action.logger.info(self.mytask_action.name + "开始::")

        # 准备初始化任务请求---
        await self._init_execute_task_requests(start_requests)
        # 开始启动
        await self.run(mytask_action)

    async def run(self, mytask_action):
        # 爬虫开始的时间
        pass
        await asyncio.create_task(self._do_next_taks_request_action(mytask_action))
        start_time = datetime.now()
        try:
            # 处理完任务队列的添加后,开始提交处理任务的协程
            await asyncio.run(self._do_next_taks_request_action(mytask_action))

        finally:

            self.mytask_action.logger.info(f'{"-" *5 } 认任务处理总共用时: {datetime.now() - start_time} {"<" * 25}')

    async def _init_execute_task_requests(self, start_requests):
        for task_request in start_requests:
            # 把当前需要请求的处理的URL放到我们的调度任务队列里面
            await self.task_scheduler.add_new_task_request(task_request)  # 传入每个网址

    async def _do_next_taks_request_action(self, mytask_action):
        pass
        # 控制协程的并发量
        semaphore = asyncio.Semaphore(value=self.task_limit)
        # 定义死循环,这样不断从我们的调度器里面提取任务
        while True:
            # 从调度器队列中获取一个请求 get_one_prepared_task_request() 在调度器中定义的
            task_request = await self.task_scheduler.get_one_pending_task_request()
            await semaphore.acquire()

            # 创建任务 用于注册到事件循环中
            # 将每个从调度器中取出的请求都创建任务 --> 每次while循环创建一个任务(不断的创建任务)
            asyncio.create_task(self._task_handle_action(task_request, mytask_action, semaphore))

    # 对每一个的请求任务体的对象开始提交到我们的下载处理对象中进行处理
    async def _task_handle_action(self, task_request, mytask_action, semaphore):
        try:
            # 使用处理器对象来处理的返回结果
            task_response = await self.my_task_handler.fetch(task_request)
        except Exception as exc:  # 有异常执行except 但是不执行下面的else了
            mytask_action.logger.info(f'请求解析处理异常: {exc}')
        else:
            # 如果没有异常,则执回调
            if task_request.callback:
                pass
                # callback = task_request.callback
                # result = callback(task_response)

            # 回答请求处理结果
            await self.callback_process_item(mytask_action, task_request, task_response)

        # 释放锁资源,让下一皮的并发请求进来
        semaphore.release()

    # 护理请求的回调
    async def callback_process_item(self, mytask_action, task_request, task_response):
        await mytask_action.callback(task_request, task_response)
3.1.6 定义任务处理入口:
from typing import Optional
from loguru import logger
from downSdk.tasklib.task_request import TaskRequest
from downSdk.tasklib.task_response import TaskResponse
from downSdk.engine import TasksEngine


# 定义处理任务的名称
class MyTaskAction:
    name: Optional[str] = None  # 爬虫名称
    start_urls: Optional[list] = None  # 处理任务的离别

    def __init__(self, name=None, start_urls: Optional[list] = None):
        self.name = name
        self.start_urls = start_urls
        self.logger = logger

    def start_requests(self):
        return [TaskRequest(name='美女图{}'.format(index), url=url) for index, url in enumerate(self.start_urls)]
        # for index, url in enumerate(self.start_urls):
        #     # 返回一个迭代器的对象
        #      TaskRequest(name='美女图{}'.format(index), url=url)

    async def start(self):
        engine = TasksEngine(self)  # 传入爬虫对象
        # 该方法中封装了execute方法
        # execute方法封装了事件循环 用来实现爬虫的初始化的启动
        await engine.start()  # 启动爬虫

    async def callback(self, task_ruqest=None, task_response: Optional[TaskResponse] = None):
        print('回调:task_ruqest:', task_ruqest.name)
        print('回调:task_response:', type(task_response))
        # 这里返回的是一个协程的对象
        # aqsda = await asyncio.create_task(task_response.get_json())
        # print(aqsda)


if __name__ == '__main__':
    start_urls = [
        'https://adservice.google.com/adsid/integrator.js?domain=m.chachahaoma.com',
        'https://adservice.google.com/adsid/integrator.js?domain=m.chachahaoma.com',
        'https://adservice.google.com/adsid/integrator.js?domain=m.chachahaoma.com',
        'https://adservice.google.com/adsid/integrator.js?domain=m.chachahaoma.com',
        'https://adservice.google.com/adsid/integrator.js?domain=m.chachahaoma.com',
        'https://adservice.google.com/adsid/integrator.js?domain=m.chachahaoma.com'
    ]
    mytask = MyTaskAction(name='测试框架的任务', start_urls=start_urls)
    import asyncio
    # 注意需要使用这种方式启动
    asyncio.run(mytask.start())
4 总结
如果不出意外,那你复制完我上面的代码到自己的上面,应该是可以跑起来的,因为我自己是跑完了一次的!
说明的一点:上面的示例中,关于返回的响应体,我没进行文件的写入!可以参考简单的示例进行扩展!
经过上面的示例的话,大概我的可以总结的出几个结论:
1:封装其实对扩展性来说的,上面的封装后,你可以按自己的需求扩展的请求信息的定义
2:对应异步并发的处理,需要注意进行控制
3:证明awite的后面必须跟一个协程对象或协程或一个协程Task任务
4: 一处异步记得处处需要awite
5:如果回调的是一个协程的对象,对于协程对象的一个同步的方法的访问的是有问题的,这个时候续集需要的使用异步的思维的处理。
6:异步的协程涉及的问题还非常多,后续还有待继续的研究。比如:
比如协程asyncio.create_task和loop..create_task的不同之处
loop=asyncio.set_event_loop(loop) 设置一个事件循环为当前线程的事件循环;
loop=asyncio.new_event_loop() 创建一个新的事件循环
run_in_executor 在协程函数里调用同步函数的处理方式,启动的是线程池的处理方式
asyncio.run_coroutine_threadsafe():线程安全的启动协程的处理方案
个人其他博客地址
简书:https://www.jianshu.com/u/d6960089b087
掘金:https://juejin.cn/user/2963939079225608
小钟同学 | 文 【原创】| QQ:308711822
1:本文相关描述主要是个人的认知和见解,如有不当之处,还望各位大佬指正。
2:关于文章内容,有部分内容参考自互联网整理,如有链接会声明标注;如没有及时标注备注的链接的,如有侵权请联系,我会立即删除处理哟。
原文作者:程序员小钟同学;如有侵权,请联系管理员删除。

最新文章
- 深入FastAPI异步编程-之并发编程(15)-定义全局的支持全局上下文变量和局部上下文的对象可以任意传递了!
- 深入FastAPI异步编程-之并发编程(13)-纠错-修改基于aiojobs库结合aiojobs的和FastAPI框架的示例
- 深入FastAPI异步编程-之并发编程(13)-基于aiojobs库实现类似Background Tasks的效果
- 深入FastAPI异步编程-之并发编程(12)-基于pyee异步事件驱动通知
- 深入FastAPI异步编程-之并发编程(11)-异步中的?同步原语
- 深入FastAPI异步编程-之并发编程(10)-?asyncio.wait 更精细化并发补充说明
- 深入FastAPI异步编程-之并发编程(9)-asyncio.as_completed的补充说明
- 深入FastAPI异步编程-之并发编程(8)-asyncio.gather的补充说明
- 深入FastAPI异步编程-之并发编程(7)番外篇~Windows系统下事件循环插曲
- 深入FastAPI异步编程-之并发编程(6)~事件循环
