网址:https://itgogogo.cn
大家好,我是皇子。
今天给大家分享阿里巴巴Java校招面经,同学的面试感受是「整个面试过程体验很舒服,面试官一直引导」。
可惜他挂了,自己没准备充分。
稍微整理下,包含以下知识点:
MySQL:MySQL索引的数据结构、 索引失效的场景 Redis:什么是热Key问题,如何解决热key问题、数据淘汰策略 操作系统:进程与线程概念、进程与线程的区别 计算机网络:计算机网络体系结构、数据在各层之间的传递过程 Java:Collections.sort和Arrays.sort的实现原理、Arraylist与LinkedList区别、 ArrayList集合加入1万条数据,应该怎么提高效率、谈谈线程池阻塞队列、直接缓冲区与非直接缓冲器有什么区别? 算法:二叉树的深度遍历
MySQL
MySQL索引的数据结构
MySQL的默认存储引擎是InnoDB,它采用的是B+树结构的索引。
B+树:只有叶子节点才会存储数据,非叶子节点只存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。
在这张图里,有两个重点:
最外面的方块,的块我们称之为一个
磁盘块,可以看到每个磁盘块包含几个数据项(粉色所示)和指针(黄色/灰色所示),如根节点磁盘包含数据项(左开右闭)17和35,包含指针P1、P2、P3,P1表示小于等于17的磁盘块,P2表示在大于17和小于等于35之间的磁盘块,P3表示大于35的磁盘块。真实的数据存在于叶子节点即3、4、5……、65。非叶子节点不存储真实的数据,只存储指引搜索方向的数据项,如17、35并不真实存在于数据表中。叶子节点之间使用
双向指针连接,最底层的叶子节点形成了一个双向有序链表,可以进行范围查询。
索引失效的场景
在索引列上使用mysql的内置函数,索引失效。
对索引列运算(如,+、-、*、/),索引失效。
索引字段上使用(!= 或者 < >,not in)时,可能会导致索引失效。
索引字段上使用is null, is not null,可能导致索引失效。字段为空是可以走索引的,但是部分场景可能会失效,字段尽量设置为非null然后设置默认值
如果字段类型是字符串,where时一定用引号括起来,否则会因为隐式类型转换,索引失效
like通配符可能导致索引失效。最左前缀不仅仅适用于组合索引,还适用于varchar的like语句,但是要注意,只有like "XXX%"的情况走索引,like "%XXX"和like "%XXX%"是不走索引的。
查询条件包含or或者in,可能导致索引失效。具体是由MySQL优化器内部决定是全表扫描还是索引查找,用效率较高的一种方式。
联合索引,查询时的条件列不是联合索引中的第一个列,索引失效。
左连接查询或者右连接查询查询关联的字段编码格式不一样,可能导致索引失效。
MySQL优化器估计使用全表扫描要比使用索引快,则不使用索引:MySQL优化器内部就是找到一个索引扫描行数最少的方案去执行语句。那么扫描行数怎么来判断的?是逐行统计数据表的数据吗?其实并不是,而是根据统计信息来预估的值,这个统计信息就是我们常说的索引的“区分度”。
建议:在使用前最好还是先用 explain 来试试到底sql语句走不走索引,然后选择较优的sql。
Redis
什么是热Key问题,如何解决热key问题
什么是热Key呢?
在Redis中,我们把访问频率高的key,称为热点key。
如果某一热点key的请求到服务器主机时,由于请求量特别大,可能会导致主机资源不足,甚至宕机,从而影响正常的服务。
而热点Key是怎么产生的呢?主要原因有两个:
用户消费的数据远大于生产的数据,如秒杀、热点新闻等读多写少的场景。
请求分片集中,超过单Redis服务器的性能,比如固定名称key,Hash落入同一台服务器,瞬间访问量极大,超过机器瓶颈,产生热点Key问题。
那么在日常开发中,如何识别到热点key呢?
凭经验判断哪些是热Key;
客户端统计上报;
服务代理层上报
如何解决热key问题?
Redis集群扩容:增加分片副本,均衡读流量;
将热key分散到不同的服务器中;
使用二级缓存,即JVM本地缓存,减少Redis的读请求。
数据淘汰策略
我们通常在设计一个系统的时候,由于数据库的读取速度远小于内存的读取速度,所以为了加快读取速度,会将一部分数据放到内存中,称为缓存。
但是内存容量是有限的,当你要缓存的数据超出容量,就得有部分数据删除,这时候哪些数据删除,哪些数据保留, 就是缓存淘汰策略要干的事情。
可以设置内存最大使用量,当内存使用量超出时,会执行数据淘汰策略
Redis 具体有 6 种淘汰策略:
| 策略 | 描述 |
|---|---|
| volatile-lru | 当内存不足以容纳新写入数据时,从设置了过期时间的key中使用LRU(最近最少使用)算法进行淘汰 |
| allkeys-lru | 当内存不足以容纳新写入数据时,从所有key中使用LRU算法进行淘汰 |
| volatile-lfu | 4.0版本新增,当内存不足以容纳新写入数据时,在过期的key中,使用LFU(最不经常使用)算法进行删除key |
| allkeys-lfu | 4.0版本新增,当内存不足以容纳新写入数据时,从所有key中使用LFU算法进行淘汰 |
| volatile-random | 当内存不足以容纳新写入数据时,从设置了过期时间的key中,随机淘汰数据 |
| allkeys-random | 当内存不足以容纳新写入数据时,从所有key中随机淘汰数据 |
| volatile-ttl | 当内存不足以容纳新写入数据时,在设置了过期时间的key中,根据过期时间进行淘汰,越早过期的优先被淘汰 |
| noeviction | 默认策略,当内存不足以容纳新写入数据时,新写入操作会报错 |
操作系统
进程与线程概念
进程
进程是资源分配的基本单位。
进程控制块 (Process Control Block, PCB) 描述进程的基本信息和运行状态,所谓的创建进程和撤销进程,都是指对 PCB 的操作。
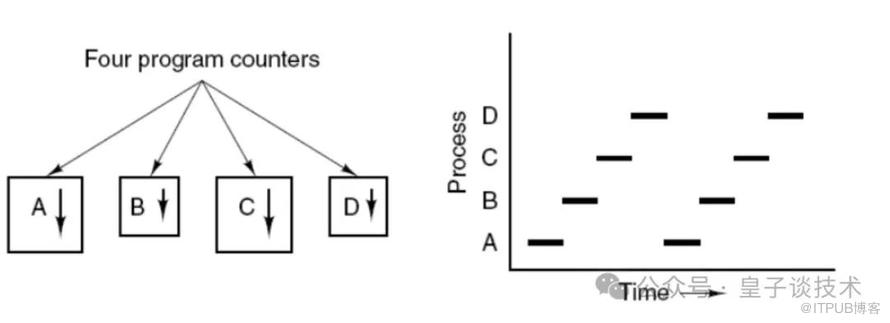
下图显示了 4 个程序创建了 4 个进程,这 4 个进程可以并发地执行。
线程
线程是独立调度的基本单位。
一个进程中可以有多个线程,它们共享进程资源。
QQ 和浏览器是两个进程,浏览器进程里面有很多线程,例如 HTTP 请求线程、事件响应线程、渲染线程等等,线程的并发执行使得在浏览器中点击一个新链接从而发起 HTTP 请求时,浏览器还可以响应用户的其它事件。
进程与线程的区别
拥有资源
进程是资源分配的基本单位,但是线程不拥有资源,线程可以访问隶属进程的资源。
调度
线程是独立调度的基本单位,在同一进程中,线程的切换不会引起进程切换,从一个进程中的线程切换到另一个进程中的线程时,会引起进程切换。
系统开销
由于创建或撤销进程时,系统都要为之分配或回收资源,如内存空间、I/O 设备等,所付出的开销远大于创建或撤销线程时的开销。类似地,在进行进程切换时,涉及当前执行进程 CPU 环境的保存及新调度进程 CPU 环境的设置,而线程切换时只需保存和设置少量寄存器内容,开销很小。
通信方面
线程间可以通过直接读写同一进程中的数据进行通信,但是进程通信需要借助 IPC。
计算机网络
计算机网络体系结构
应用层:为特定应用程序提供数据传输服务,例如 HTTP、DNS 等协议。数据单位为报文。表示层:数据压缩、加密以及数据描述,这使得应用程序不必关心在各台主机中数据内部格式不同的问题。会话层:建立及管理会话。传输层(运输层):为进程提供通用数据传输服务。由于应用层协议很多,定义通用的传输层协议就可以支持不断增多的应用层协议。运输层包括两种协议:传输控制协议 TCP,提供面向连接、可靠的数据传输服务,数据单位为报文段;用户数据报协议 UDP,提供无连接、尽最大努力的数据传输服务,数据单位为用户数据报。TCP 主要提供完整性服务,UDP 主要提供及时性服务。网络层:为主机提供数据传输服务。而传输层协议是为主机中的进程提供数据传输服务。网络层把传输层传递下来的报文段或者用户数据报封装成分组。数据链路层:网络层针对的还是主机之间的数据传输服务,而主机之间可以有很多链路,链路层协议就是为同一链路的主机提供数据传输服务。数据链路层把网络层传下来的分组封装成帧。物理层:考虑的是怎样在传输媒体上传输数据比特流,而不是指具体的传输媒体。物理层的作用是尽可能屏蔽传输媒体和通信手段的差异,使数据链路层感觉不到这些差异。
❝五层协议没有表示层和会话层,而是将这些功能留给应用程序开发者处理。
❝TCP/IP 协议:它只有四层,相当于五层协议中数据链路层和物理层合并为网络接口层。
TCP/IP 体系结构不严格遵循 OSI 分层概念,应用层可能会直接使用 IP 层或者网络接口层。
数据在各层之间的传递过程
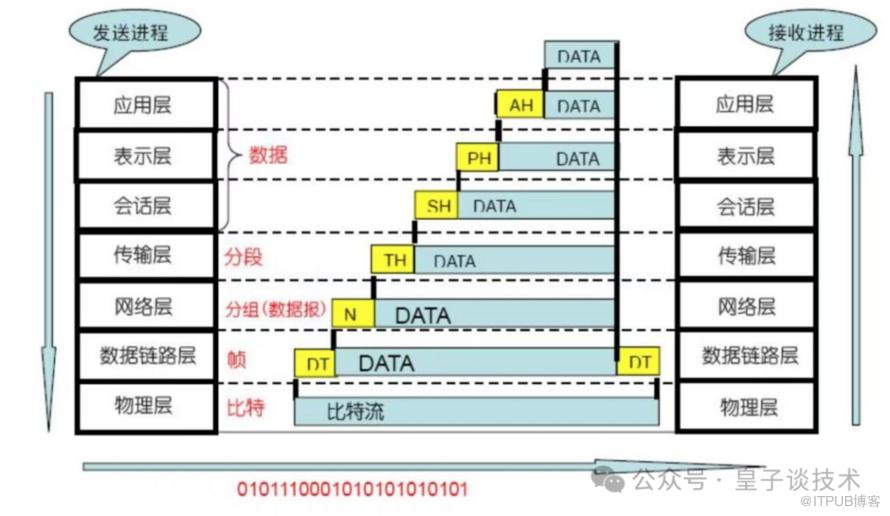
在向下的过程中,需要添加下层协议所需要的首部和尾部,而在向上的过程中不断拆开首部和尾部。
路由器只有下面三层协议,因为路由器位于网络核心中,不需要为进程或者应用程序提供服务,因此也就不需要传输层和应用层。
数据在各层传递过程及数据格式变化
数据格式变化
Java
Collections.sort和Arrays.sort的实现原理
Collection.sort是对list进行排序,Arrays.sort是对数组进行排序。
Collections.sort底层实现
Collections.sort方法调用了list.sort方法
list.sort方法调用了Arrays.sort的方法
因此,Collections.sort方法底层就是调用的Array.sort方法
Arrays.sort底层实现
Arrays的sort方法,如下:
如果比较器为null,进入sort(a)方法。如下:
因此,Arrays的sort方法底层就是:
legacyMergeSort(a),归并排序, ComparableTimSort.sort():即Timsort排序。
Timesort排序
Timsort排序是结合了合并排序(merge.sort)和插入排序(insertion sort)而得出的排序方法;
1.当数组长度小于某个值,采用的是二分插入排序算法,如下:
找到各个run,并入栈。
按规则合并run。
Arraylist与LinkedList区别
可以从它们的底层数据结构、效率、开销进行阐述哈
ArrayList是数组的数据结构,LinkedList是链表的数据结构。 随机访问的时候,ArrayList的效率比较高,因为LinkedList要移动指针,而ArrayList是基于索引(index)的数据结构,可以直接映射到。 插入、删除数据时,LinkedList的效率比较高,因为ArrayList要移动数据。 LinkedList比ArrayList开销更大,因为LinkedList的节点除了存储数据,还需要存储引用。
ArrayList集合加入1万条数据,应该怎么提高效率
因为ArrayList的底层是数组实现,并且数组的默认值是10,如果插入10000条要不断的扩容,耗费时间,所以我们调用ArrayList的指定容量的构造器方法ArrayList(int size) 就可以实现不扩容,就提高了性能。
谈谈线程池阻塞队列
ArrayBlockingQueue LinkedBlockingQueue DelayQueue PriorityBlockingQueue SynchronousQueue
ArrayBlockingQueue: (有界队列)是一个用数组实现的有界阻塞队列,按FIFO排序量。
LinkedBlockingQueue: (可设置容量队列)基于链表结构的阻塞队列,按FIFO排序任务,容量可以选择进行设置,不设置的话,将是一个无边界的阻塞队列,最大长度为Integer.MAX_VALUE,吞吐量通常要高于ArrayBlockingQuene;newFixedThreadPool线程池使用了这个队列
DelayQueue:(延迟队列)是一个任务定时周期的延迟执行的队列。根据指定的执行时间从小到大排序,否则根据插入到队列的先后排序。newScheduledThreadPool线程池使用了这个队列。
PriorityBlockingQueue:(优先级队列)是具有优先级的无界阻塞队列;
SynchronousQueue:(同步队列)一个不存储元素的阻塞队列,每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于LinkedBlockingQuene,newCachedThreadPool线程池使用了这个队列。
针对面试题:线程池都有哪几种工作队列?
回答以上几种ArrayBlockingQueue,LinkedBlockingQueue,SynchronousQueue等,说出它们的特点,并结合使用到对应队列的常用线程池(如newFixedThreadPool线程池使用LinkedBlockingQueue),进行展开阐述就可以了。
直接缓冲区与非直接缓冲器有什么区别?
在Java中,缓冲区分为两种类型:直接缓冲区(Direct Buffer)和非直接缓冲区(Indirect Buffer,也称为堆缓冲区)。
非直接缓冲区(Heap Buffer)
非直接缓冲区的创建是在Java堆内存中分配空间,通过 ByteBuffer.allocate()方法创建。操作非直接缓冲区的数据不需要进行额外的内存复制,但在进行I/O操作时(如文件读写或网络通信),数据需要从堆内存复制到操作系统内核的缓冲区,然后再进行实际的I/O操作,这可能导致额外的性能开销。
直接缓冲区(Direct Buffer)
直接缓冲区不是在Java堆内存上分配,而是通过JNI(Java Native Interface)在Java虚拟机之外的系统本地内存区域中分配,可以通过 ByteBuffer.allocateDirect()方法创建。使用直接缓冲区的优点在于,当进行I/O操作时,可以直接在物理内存与操作系统内核之间交换数据,省去了将数据从堆内存复制到内核缓冲区的步骤,因此对于大量数据的传输,可以显著提高性能。 缺点是创建和销毁直接缓冲区涉及到JNI调用和系统资源管理,可能会有更高的开销,并且直接缓冲区生命周期结束后,垃圾回收器无法自动释放其占用的内存,需要通过 ByteBuffer#cleaner()或者ByteBuffer#dispose()方法手动释放。
直接缓冲区通常用于对性能要求较高的场合,如大规模的数据处理、高性能网络编程等场景;而非直接缓冲区更适合于普通用途,特别是在内存使用量较小或者性能需求不高的情况下。
算法
二叉树的深度遍历
关注公众号,后台发送【简历】,领取简历摸板
网址:https://itgogogo.cn
大家好,我是皇子。
今天给大家分享阿里巴巴Java校招面经,同学的面试感受是「整个面试过程体验很舒服,面试官一直引导」。
可惜他挂了,自己没准备充分。
稍微整理下,包含以下知识点:
MySQL:MySQL索引的数据结构、 索引失效的场景 Redis:什么是热Key问题,如何解决热key问题、数据淘汰策略 操作系统:进程与线程概念、进程与线程的区别 计算机网络:计算机网络体系结构、数据在各层之间的传递过程 Java:Collections.sort和Arrays.sort的实现原理、Arraylist与LinkedList区别、 ArrayList集合加入1万条数据,应该怎么提高效率、谈谈线程池阻塞队列、直接缓冲区与非直接缓冲器有什么区别? 算法:二叉树的深度遍历
MySQL
MySQL索引的数据结构
MySQL的默认存储引擎是InnoDB,它采用的是B+树结构的索引。
B+树:只有叶子节点才会存储数据,非叶子节点只存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。
在这张图里,有两个重点:
最外面的方块,的块我们称之为一个
磁盘块,可以看到每个磁盘块包含几个数据项(粉色所示)和指针(黄色/灰色所示),如根节点磁盘包含数据项(左开右闭)17和35,包含指针P1、P2、P3,P1表示小于等于17的磁盘块,P2表示在大于17和小于等于35之间的磁盘块,P3表示大于35的磁盘块。真实的数据存在于叶子节点即3、4、5……、65。非叶子节点不存储真实的数据,只存储指引搜索方向的数据项,如17、35并不真实存在于数据表中。叶子节点之间使用
双向指针连接,最底层的叶子节点形成了一个双向有序链表,可以进行范围查询。
索引失效的场景
在索引列上使用mysql的内置函数,索引失效。
对索引列运算(如,+、-、*、/),索引失效。
索引字段上使用(!= 或者 < >,not in)时,可能会导致索引失效。
索引字段上使用is null, is not null,可能导致索引失效。字段为空是可以走索引的,但是部分场景可能会失效,字段尽量设置为非null然后设置默认值
如果字段类型是字符串,where时一定用引号括起来,否则会因为隐式类型转换,索引失效
like通配符可能导致索引失效。最左前缀不仅仅适用于组合索引,还适用于varchar的like语句,但是要注意,只有like "XXX%"的情况走索引,like "%XXX"和like "%XXX%"是不走索引的。
查询条件包含or或者in,可能导致索引失效。具体是由MySQL优化器内部决定是全表扫描还是索引查找,用效率较高的一种方式。
联合索引,查询时的条件列不是联合索引中的第一个列,索引失效。
左连接查询或者右连接查询查询关联的字段编码格式不一样,可能导致索引失效。
MySQL优化器估计使用全表扫描要比使用索引快,则不使用索引:MySQL优化器内部就是找到一个索引扫描行数最少的方案去执行语句。那么扫描行数怎么来判断的?是逐行统计数据表的数据吗?其实并不是,而是根据统计信息来预估的值,这个统计信息就是我们常说的索引的“区分度”。
建议:在使用前最好还是先用 explain 来试试到底sql语句走不走索引,然后选择较优的sql。
Redis
什么是热Key问题,如何解决热key问题
什么是热Key呢?
在Redis中,我们把访问频率高的key,称为热点key。
如果某一热点key的请求到服务器主机时,由于请求量特别大,可能会导致主机资源不足,甚至宕机,从而影响正常的服务。
而热点Key是怎么产生的呢?主要原因有两个:
用户消费的数据远大于生产的数据,如秒杀、热点新闻等读多写少的场景。
请求分片集中,超过单Redis服务器的性能,比如固定名称key,Hash落入同一台服务器,瞬间访问量极大,超过机器瓶颈,产生热点Key问题。
那么在日常开发中,如何识别到热点key呢?
凭经验判断哪些是热Key;
客户端统计上报;
服务代理层上报
如何解决热key问题?
Redis集群扩容:增加分片副本,均衡读流量;
将热key分散到不同的服务器中;
使用二级缓存,即JVM本地缓存,减少Redis的读请求。
数据淘汰策略
我们通常在设计一个系统的时候,由于数据库的读取速度远小于内存的读取速度,所以为了加快读取速度,会将一部分数据放到内存中,称为缓存。
但是内存容量是有限的,当你要缓存的数据超出容量,就得有部分数据删除,这时候哪些数据删除,哪些数据保留, 就是缓存淘汰策略要干的事情。
可以设置内存最大使用量,当内存使用量超出时,会执行数据淘汰策略
Redis 具体有 6 种淘汰策略:
| 策略 | 描述 |
|---|---|
| volatile-lru | 当内存不足以容纳新写入数据时,从设置了过期时间的key中使用LRU(最近最少使用)算法进行淘汰 |
| allkeys-lru | 当内存不足以容纳新写入数据时,从所有key中使用LRU算法进行淘汰 |
| volatile-lfu | 4.0版本新增,当内存不足以容纳新写入数据时,在过期的key中,使用LFU(最不经常使用)算法进行删除key |
| allkeys-lfu | 4.0版本新增,当内存不足以容纳新写入数据时,从所有key中使用LFU算法进行淘汰 |
| volatile-random | 当内存不足以容纳新写入数据时,从设置了过期时间的key中,随机淘汰数据 |
| allkeys-random | 当内存不足以容纳新写入数据时,从所有key中随机淘汰数据 |
| volatile-ttl | 当内存不足以容纳新写入数据时,在设置了过期时间的key中,根据过期时间进行淘汰,越早过期的优先被淘汰 |
| noeviction | 默认策略,当内存不足以容纳新写入数据时,新写入操作会报错 |
操作系统
进程与线程概念
进程
进程是资源分配的基本单位。
进程控制块 (Process Control Block, PCB) 描述进程的基本信息和运行状态,所谓的创建进程和撤销进程,都是指对 PCB 的操作。
下图显示了 4 个程序创建了 4 个进程,这 4 个进程可以并发地执行。
线程
线程是独立调度的基本单位。
一个进程中可以有多个线程,它们共享进程资源。
QQ 和浏览器是两个进程,浏览器进程里面有很多线程,例如 HTTP 请求线程、事件响应线程、渲染线程等等,线程的并发执行使得在浏览器中点击一个新链接从而发起 HTTP 请求时,浏览器还可以响应用户的其它事件。
进程与线程的区别
拥有资源
进程是资源分配的基本单位,但是线程不拥有资源,线程可以访问隶属进程的资源。
调度
线程是独立调度的基本单位,在同一进程中,线程的切换不会引起进程切换,从一个进程中的线程切换到另一个进程中的线程时,会引起进程切换。
系统开销
由于创建或撤销进程时,系统都要为之分配或回收资源,如内存空间、I/O 设备等,所付出的开销远大于创建或撤销线程时的开销。类似地,在进行进程切换时,涉及当前执行进程 CPU 环境的保存及新调度进程 CPU 环境的设置,而线程切换时只需保存和设置少量寄存器内容,开销很小。
通信方面
线程间可以通过直接读写同一进程中的数据进行通信,但是进程通信需要借助 IPC。
计算机网络
计算机网络体系结构
应用层:为特定应用程序提供数据传输服务,例如 HTTP、DNS 等协议。数据单位为报文。表示层:数据压缩、加密以及数据描述,这使得应用程序不必关心在各台主机中数据内部格式不同的问题。会话层:建立及管理会话。传输层(运输层):为进程提供通用数据传输服务。由于应用层协议很多,定义通用的传输层协议就可以支持不断增多的应用层协议。运输层包括两种协议:传输控制协议 TCP,提供面向连接、可靠的数据传输服务,数据单位为报文段;用户数据报协议 UDP,提供无连接、尽最大努力的数据传输服务,数据单位为用户数据报。TCP 主要提供完整性服务,UDP 主要提供及时性服务。网络层:为主机提供数据传输服务。而传输层协议是为主机中的进程提供数据传输服务。网络层把传输层传递下来的报文段或者用户数据报封装成分组。数据链路层:网络层针对的还是主机之间的数据传输服务,而主机之间可以有很多链路,链路层协议就是为同一链路的主机提供数据传输服务。数据链路层把网络层传下来的分组封装成帧。物理层:考虑的是怎样在传输媒体上传输数据比特流,而不是指具体的传输媒体。物理层的作用是尽可能屏蔽传输媒体和通信手段的差异,使数据链路层感觉不到这些差异。
❝五层协议没有表示层和会话层,而是将这些功能留给应用程序开发者处理。
❝TCP/IP 协议:它只有四层,相当于五层协议中数据链路层和物理层合并为网络接口层。
TCP/IP 体系结构不严格遵循 OSI 分层概念,应用层可能会直接使用 IP 层或者网络接口层。
数据在各层之间的传递过程
在向下的过程中,需要添加下层协议所需要的首部和尾部,而在向上的过程中不断拆开首部和尾部。
路由器只有下面三层协议,因为路由器位于网络核心中,不需要为进程或者应用程序提供服务,因此也就不需要传输层和应用层。
数据在各层传递过程及数据格式变化
数据格式变化

Java
Collections.sort和Arrays.sort的实现原理
Collection.sort是对list进行排序,Arrays.sort是对数组进行排序。
Collections.sort底层实现
Collections.sort方法调用了list.sort方法
list.sort方法调用了Arrays.sort的方法
因此,Collections.sort方法底层就是调用的Array.sort方法
Arrays.sort底层实现
Arrays的sort方法,如下:
如果比较器为null,进入sort(a)方法。如下:
因此,Arrays的sort方法底层就是:
legacyMergeSort(a),归并排序, ComparableTimSort.sort():即Timsort排序。
Timesort排序
Timsort排序是结合了合并排序(merge.sort)和插入排序(insertion sort)而得出的排序方法;
1.当数组长度小于某个值,采用的是二分插入排序算法,如下:
找到各个run,并入栈。
按规则合并run。
Arraylist与LinkedList区别
可以从它们的底层数据结构、效率、开销进行阐述哈
ArrayList是数组的数据结构,LinkedList是链表的数据结构。 随机访问的时候,ArrayList的效率比较高,因为LinkedList要移动指针,而ArrayList是基于索引(index)的数据结构,可以直接映射到。 插入、删除数据时,LinkedList的效率比较高,因为ArrayList要移动数据。 LinkedList比ArrayList开销更大,因为LinkedList的节点除了存储数据,还需要存储引用。
ArrayList集合加入1万条数据,应该怎么提高效率
因为ArrayList的底层是数组实现,并且数组的默认值是10,如果插入10000条要不断的扩容,耗费时间,所以我们调用ArrayList的指定容量的构造器方法ArrayList(int size) 就可以实现不扩容,就提高了性能。
谈谈线程池阻塞队列
ArrayBlockingQueue LinkedBlockingQueue DelayQueue PriorityBlockingQueue SynchronousQueue
ArrayBlockingQueue: (有界队列)是一个用数组实现的有界阻塞队列,按FIFO排序量。
LinkedBlockingQueue: (可设置容量队列)基于链表结构的阻塞队列,按FIFO排序任务,容量可以选择进行设置,不设置的话,将是一个无边界的阻塞队列,最大长度为Integer.MAX_VALUE,吞吐量通常要高于ArrayBlockingQuene;newFixedThreadPool线程池使用了这个队列
DelayQueue:(延迟队列)是一个任务定时周期的延迟执行的队列。根据指定的执行时间从小到大排序,否则根据插入到队列的先后排序。newScheduledThreadPool线程池使用了这个队列。
PriorityBlockingQueue:(优先级队列)是具有优先级的无界阻塞队列;
SynchronousQueue:(同步队列)一个不存储元素的阻塞队列,每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于LinkedBlockingQuene,newCachedThreadPool线程池使用了这个队列。
针对面试题:线程池都有哪几种工作队列?
回答以上几种ArrayBlockingQueue,LinkedBlockingQueue,SynchronousQueue等,说出它们的特点,并结合使用到对应队列的常用线程池(如newFixedThreadPool线程池使用LinkedBlockingQueue),进行展开阐述就可以了。
直接缓冲区与非直接缓冲器有什么区别?
在Java中,缓冲区分为两种类型:直接缓冲区(Direct Buffer)和非直接缓冲区(Indirect Buffer,也称为堆缓冲区)。
非直接缓冲区(Heap Buffer)
非直接缓冲区的创建是在Java堆内存中分配空间,通过 ByteBuffer.allocate()方法创建。操作非直接缓冲区的数据不需要进行额外的内存复制,但在进行I/O操作时(如文件读写或网络通信),数据需要从堆内存复制到操作系统内核的缓冲区,然后再进行实际的I/O操作,这可能导致额外的性能开销。
直接缓冲区(Direct Buffer)
直接缓冲区不是在Java堆内存上分配,而是通过JNI(Java Native Interface)在Java虚拟机之外的系统本地内存区域中分配,可以通过 ByteBuffer.allocateDirect()方法创建。使用直接缓冲区的优点在于,当进行I/O操作时,可以直接在物理内存与操作系统内核之间交换数据,省去了将数据从堆内存复制到内核缓冲区的步骤,因此对于大量数据的传输,可以显著提高性能。 缺点是创建和销毁直接缓冲区涉及到JNI调用和系统资源管理,可能会有更高的开销,并且直接缓冲区生命周期结束后,垃圾回收器无法自动释放其占用的内存,需要通过 ByteBuffer#cleaner()或者ByteBuffer#dispose()方法手动释放。
直接缓冲区通常用于对性能要求较高的场合,如大规模的数据处理、高性能网络编程等场景;而非直接缓冲区更适合于普通用途,特别是在内存使用量较小或者性能需求不高的情况下。
算法
二叉树的深度遍历
关注公众号,后台发送【简历】,领取简历摸板
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

