黑脸是啥,是失望吗?
大家好,我是皇子。
小米是一家致力于持续创新,不断追求极致的产品服务体验的公司,同时价格还很厚道。
不管是小米手机,还是其他智能家居、智能穿戴设备、以及小米 SU7 都可以看到小米在产品创新和体验上的追求。
接下来,我们介绍一位小米后端开发的暑期实习二面凉经,从开始的被改时间,到过程的从严肃到黑脸,最后是面试到30分钟面试官不想面了,这位后端开发也很痛苦。
过程是:这位同学本来对Java的sprincloud并不熟悉,但是呢?
这位面试官一直揪着问了几个上难度的java相关问题后,这位同学也有点崩溃了。
好不容易等到面试官换了其他问题,他自己却没能发挥好回答到点上。
然后整个过程就是每次一回答面试官就黑脸,他自己也很难受,就这样面到30分钟就结束了。
过程也无手撕算法,因为压力大,这位同学也并未进行反问。
这里稍微整理一下面试过程的知识点:
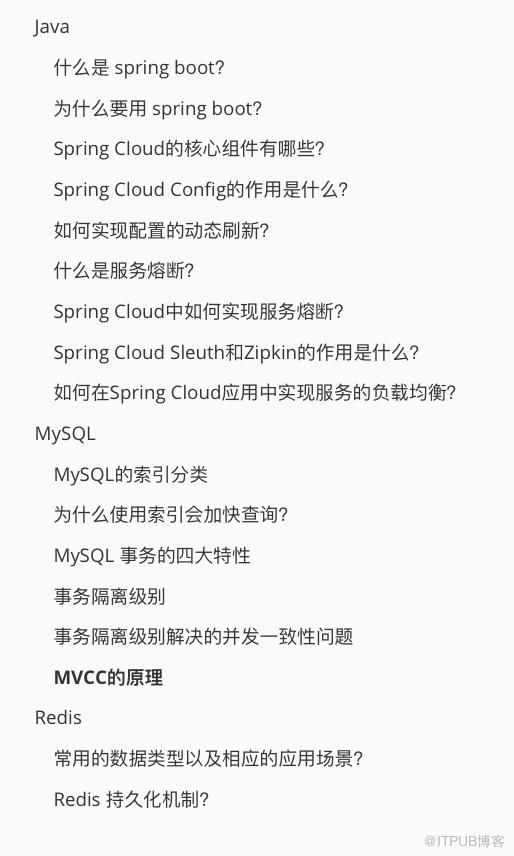
Java
什么是 spring boot?
SpringBoot是Spring开源框架下的子项目,是Spring的一站式解决方案,主要是简化了spring的使用难度,降低了对配置文件的要求,使得开发人员更容易上手。
为什么要用 spring boot?
简化了Spring配置文件 没有代码和XML文件的生成 内置tomcat 能够独立运行 简化监控
Spring Cloud的核心组件有哪些?
Eureka:服务注册与发现组件,负责管理微服务实例的注册与心跳检查。 Ribbon:客户端侧负载均衡器,可实现智能的客户端负载均衡和服务调用。 Hystrix:断路器组件,通过熔断机制防止服务雪崩效应,提供容错能力。 Zuul(或Spring Cloud Gateway):API网关,提供路由转发和过滤器功能,用于微服务间的请求转发和处理。 Config Server/Config Client:分布式配置中心,支持配置的集中管理和推送。
Spring Cloud Config的作用是什么?
Spring Cloud Config主要用于集中管理微服务应用的配置信息。它分为服务端(Config Server)和客户端(Config Client)两部分。服务端负责存储配置文件,客户端从服务端拉取配置信息并应用于微服务。
如何实现配置的动态刷新?
动态刷新配置通常可以通过Spring Cloud Bus配合使用。当配置发生变化时,Config Server接收到更新,通过Spring Cloud Bus向各个Client发送刷新消息,客户端接收到消息后自动重新加载配置。
什么是服务熔断?
服务熔断是一种应对服务雪崩效应的微服务容错机制。
当某个服务因为某种原因响应变慢或失败率升高时,为了防止整个系统受影响,会暂时停止对该服务的调用,快速返回错误响应给客户端,这就是服务熔断。
服务熔断通常具备以下几个关键特性:
触发条件:熔断器会在预设的阈值(如错误率、超时次数、响应时间等)被超过时触发。这些阈值可以根据业务需求和系统承受能力进行定制。
熔断状态:熔断器通常有三种状态:
关闭状态(Closed):正常情况下,熔断器处于关闭状态,允许请求正常通过并调用下游服务。 开启状态(Open):当触发条件满足时,熔断器切换到开启状态,立即拒绝后续请求,不再尝试调用问题服务。 半开状态(Half-Open):经过一段时间(称为恢复期)后,熔断器进入半开状态,允许少量请求试探性地通过,以检测下游服务是否已经恢复。如果这些试探请求成功,熔断器会认为服务已恢复并恢复到关闭状态;否则,熔断器将继续保持开启状态,延长恢复期。
反馈与恢复:熔断器不仅负责切断请求,还应具备状态监测与反馈机制,当问题服务恢复正常时能及时调整状态,重新允许请求通过。
Spring Cloud中如何实现服务熔断?
在Spring Cloud中,服务熔断通过Hystrix实现。开发者可以在客户端定义断路器规则,比如失败阈值、超时时间等。一旦达到触发条件,Hystrix会打开断路器,后续请求直接失败而不会去调用实际的服务,一段时间后尝试半开状态恢复调用。
Spring Cloud Sleuth和Zipkin的作用是什么?
Spring Cloud Sleuth是一个用于收集服务间调用链路跟踪信息的工具,它可以让我们在分布式系统中追踪请求的流向,帮助分析系统的性能瓶颈和故障点。
Zipkin则是一个分布式的跟踪系统,它提供了存储、查找和展示跟踪数据的服务。
Sleuth集成了Zipkin,使得开发者可以很容易地在Spring Cloud应用中加入跟踪功能,收集并输出跟踪数据到Zipkin服务器进行分析。
如何在Spring Cloud应用中实现服务的负载均衡?
在Spring Cloud应用中,服务的负载均衡可以通过Ribbon或Spring Cloud LoadBalancer实现。Ribbon是一个客户端负载均衡器,它允许你以声明式的方式控制HTTP和TCP客户端的行为。
在微服务架构中,当服务消费者需要调用服务提供者时,Ribbon会根据负载均衡策略(如轮询、随机、权重响应时间等)选择一个合适的服务实例进行调用。
另外,Spring Cloud LoadBalancer是Spring Cloud项目中的一个更现代的负载均衡器,它为Ribbon提供了一个替代方案,支持更多种类的负载均衡策略,并且与Spring Cloud DiscoveryClient有更好的集成,简化了配置和使用。
MySQL
MySQL的索引分类
从三个不同维度对索引分类:
例如从基本使用的角度来讲:
主键索引: InnoDB主键是默认的索引,数据列不允许重复,不允许为NULL,一个表只能有一个主键。
唯一索引: 数据列不允许重复,允许为NULL值,一个表允许多个列创建唯一索引。
普通索引: 基本的索引类型,没有唯一性的限制,允许为NULL值。
组合索引:多列值组成一个索引,用于组合搜索,效率大于索引合并
为什么使用索引会加快查询?
传统的查询方法,是按照表的顺序遍历的,不论查询几条数据,MySQL需要将表的数据从头到尾遍历一遍。
在我们添加完索引之后,MySQL一般通过BTREE算法生成一个索引文件,在查询数据库时,找到索引文件进行遍历,在比较小的索引数据里查找,然后映射到对应的数据,能大幅提升查找的效率。
和我们通过书的目录,去查找对应的内容,一样的道理。
MySQL 事务的四大特性
ACID是 MySQL 事务的四大特性
1、原子性(Atomicity)
事务被视为不可分割的最小单元,事务的所有操作要么全部提交成功,要么全部失败回滚。
回滚可以用回滚日志(Undo Log)来实现,回滚日志记录着事务所执行的修改操作,在回滚时反向执行这些修改操作即可。
2、一致性(Consistency)
数据库在事务执行前后都保持一致性状态。在一致性状态下,所有事务对同一个数据的读取结果都是相同的。假如 A 账户给 B 账户转 10 块钱,不管成功与否,A 和 B 的总金额是不变的。
3、隔离性(Isolation)
一个事务所做的修改在最终提交以前,对其它事务是不可见的。
4、持久性(Durability)
一旦事务提交,则其所做的修改将会永远保存到数据库中。即使系统发生崩溃,事务执行的结果也不能丢失。
系统发生崩溃可以用重做日志(Redo Log)进行恢复,从而实现持久性。
与回滚日志(Undo Log)记录数据的逻辑修改不同,重做日志记录的是数据页的物理修改。
事务隔离级别
读未提交(READ UNCOMMITTED):事务中的修改,即使没有提交,对其它事务也是可见的。
读已提交(READ COMMITTED):一个事务只能读取已经提交的事务所做的修改。换句话说,一个事务所做的修改在提交之前对其它事务是不可见的。
可重复读(REPEATABLE READ):保证在同一个事务中多次读取同一数据的结果是一样的。
可串行化(SERIALIZABLE):强制事务串行执行,这样多个事务互不干扰,不会出现并发一致性问题。该隔离级别需要加锁实现,因为要使用加锁机制保证同一时间只有一个事务执行,也就是保证事务串行执行。
事务隔离级别解决的并发一致性问题
并发一致性问题包含:脏读、不可重复读、幻读
一图看透4种事务隔离级别:读未提交、读已提交、可重复读、可串行化,分别解决哪些并发一致性问题。
MVCC的原理
多版本并发控制(Multi-Version Concurrency Control, MVCC)是 MySQL 的 InnoDB 存储引擎实现隔离级别的一种具体方式,用于实现提交读和可重复读这两种隔离级别。
而未提交读隔离级别总是读取最新的数据行,要求很低,无需使用 MVCC。
可串行化隔离级别需要对所有读取的行都加锁,单纯使用 MVCC 无法实现。
(一) 基本思想加锁能解决多个事务同时执行时出现的并发一致性问题。
在实际场景中读操作往往多于写操作,因此又引入了读写锁来避免不必要的加锁操作,例如读和读没有互斥关系。
读写锁中读和写操作仍然是互斥的,而 MVCC 利用了多版本的思想,写操作更新最新的版本快照,而读操作去读旧版本快照,没有互斥关系,这一点和 CopyOnWrite 类似。
在 MVCC 中事务的修改操作(DELETE、INSERT、UPDATE)会为数据行新增一个版本快照。
脏读最根本的原因是事务读取到其它事务未提交的修改
不可重复读最根本的原因是事务读取到其它事务已提交的修改。
在事务进行读取操作时,为了解决脏读和不可重复读问题,MVCC 规定只能读取已经提交的快照。当然一个事务可以读取自身未提交的快照,这不算是脏读。
(二) 实现原理
MVCC 的实现原理主要依赖于:记录中的三个隐藏字段、Undo Log、ReadView(读视图)、快照读&当前读
可参考官网:https://dev.mysql.com/doc/refman/8.0/en/innodb-multi-versioning.html
关于隐藏字段每行记录处理我们自定义的字段外,还有数据库隐式定义的DB_TRX_ID、DB_ROLL_PTR、DB_ROW 等字段
MVCC 的实现原理主要依赖于记录中的三个隐藏字段为:DB_TRX_ID、DB_ROLL_PTR、DB_ROW
DB_TRX_ID:最近修改的事务ID:6字节,插入或更新行的最后一个事务(已提交或未提交的事务)的事务标识符。此外,删除在内部被视为更新,其中行中的特殊位设置为将其标记为已删除。
DB_ROLL_PTR:回滚指针:7字节,滚动指针指向写入回滚段的Undo Log 记录。如果行已更新,则 Undo Log 记录包含在更新之前重建行内容所需的信息。
DB_ROW_ID:隐藏的主键:6字节,如果数据表没有主键,那么InnoDB 会自动生成一个6字节的 ROW_ID
其他隐藏字段
系统版本号 SYS_ID:是一个递增的数字,每开始一个新的事务,系统版本号就会自动递增。 事务版本号 TRX_ID :事务开始时的系统版本号。
常用的数据类型以及相应的应用场景?
string:简单的key-value类型(相当于Java/Golang中的Map),适用于需要计数的场景,比如统计用户的访问次数、热点文章的点赞转发数量等。 list:使用双向链表实现(相当于java中的双向队列),适用于发布与订阅、消息队列、慢查询。 set:无序集合(相当于java中的HashSet),适用于存放不能重复的数据以及需要获取多个数据源交集和并集等场景,比如统计共同粉丝和共同爱好等。 zset:有序集合,在set的基础上增加了一个权重参数 score,使得集合中的元素能够按 score 进行有序排列(相当于Java 中 HashMap 和 TreeSet 的结合),适用于需要对数据根据某个权重进行排序的场景。比如统计礼物排行榜等。 hash:相当于java中的HashMap,数组 + 链表实现,适用于对象数据的存储,比如用户信息,商品信息等等。 bitmap:存储的是连续的二进制数字(0 和 1),二进制数字中每一个 bit 位表示某个元素对应的值或者状态,适合需要保存状态信息的场景,比如统计用户是否签到、是否在线、是否点赞过某个视频等。
Redis 持久化机制?
redis是一个内存数据库,数据保存在内存中,但是内存的数据变化是很快的,也容易发生丢失(比如重启机器、机器故障)。
所以Redis提供了持久化的机制,将内存中的数据写入到硬盘。Redis提供了两种持久化机制,分别是RDB(Redis DataBase)和AOF(Append Only File)。
持久化方式一:RDB【默认方式】在指定时间间隔后,将内存中的数据快照写入二进制文件【默认为dump.rdb】,保存在磁盘中 ;在恢复时候,直接读取快照文件,进行数据的恢复。在写入时,Redis 会用新 RDB 文件替换原来的 RDB 文件,并删除旧的 RDB 文件【写时复制(copy-on-write)】。
触发机制:
save:同步命令,执行save命令期间,会占用当前Redis主进程,阻塞所有客户端的请求,直到RDB过程完成为止。
bgsave:异步命令,执行该命令时,Redis会fock子进程,子进程在后台异步进行快照操作,快照同时还可以响应客户端请求。
自动化flushall:通过配置文件对 Redis 进行设置,让他自动进行数据集保存操作。
退出redis,也会自动产生rdb文件。
优势:RDB文件紧凑,全量备份,恢复数据很快,适合大规模的数据恢复。
劣势:需要一定的时间间隔进行操作,如果在快照持久化期间,redis意外宕机了,最后一次修改的数据就没有了。fork进程的时候,会占用一定的内容空间。
持久化方式二:AOF以日志【默认为appendonly.aof】的形式来记录每个写的操作,将Redis执行过的所有指令记录下来(读操作不记录),保存在AOF文件中,redis启动的时候会读取该文件重新执行所有的指令来恢复数据。
触发机制(在配置文件中可以设置不同的 AOF 持久化方式):
appendfsync always:每次发生数据变更会被立即记录到磁盘,严重降低Redis的速度,但数据完整性比较好。
appendfsync everysec:每秒同步一次,显示地将多个写命令同步到硬盘记录,如果在这一秒内宕机,有数据丢失。
appendfsync no:让操作系统决定何时进行同步。
优势:支持实时持久化/秒级持久化,可以更好的保护数据不丢失,非常适合做灾难性的误删除的紧急恢复。
劣势:对于同一份数据来说,AOF日志文件通常比RDB数据快照文件更大,修复速度更慢!
难度吧,也不算大。
但是作为面试官黑着脸是不友好的,而且只会影响应聘者后面的发挥,最后影响到找到公司岗位上的合适人选。
要是觉得不合适,快点结束就好了。
要是为了KPI,走个形式,那希望打开格局“打工人何苦为难打工人”,大家觉得呢,欢迎点个转发、在看和赞~
推荐阅读
关于作者:一位热爱技术,并在职场与自媒体间探索的实践者,希望通过分享个人经验和见解,帮助更多人实现自我成长和价值。
如果您对我的公众号内容感兴趣,欢迎关注我。
也可以在下方添加我微信和一支烟花AI社区技术群,一起交流技术、职场心得。欢迎~
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

