怀疑到是否是纯KPI面
大家好,我是皇子。
今年5月,一名认证为字节跳动员工的用户在脉脉发帖称:“HR说北京裁员已经到了不让裁员的地步了”(真狠呀)。
据称当时,这是涉及房产、医疗、游戏三块业务的调整,相较于过去的一次性大规模裁员,这次变成了一对一调整,执行的是考核优化策略,这也是一直没爆炸性的裁员消息被媒体报道的主要原因。
这种谈好赔偿后直接离职,用这种细水长流的新型方式进行裁员,在完成裁员目标的同时,相比去年11月进行大规模业务收缩,甚至还传出了裁员锁天台的消息,动静确实小上了不少。
即使在这样的背景下,应该也不至于为了KPI放到三面吧?
那下面我们还是先看下,字节跳动半个小时就结束的三面面经吧。
虽然无手撕,但是还是有关于算法的问题的。
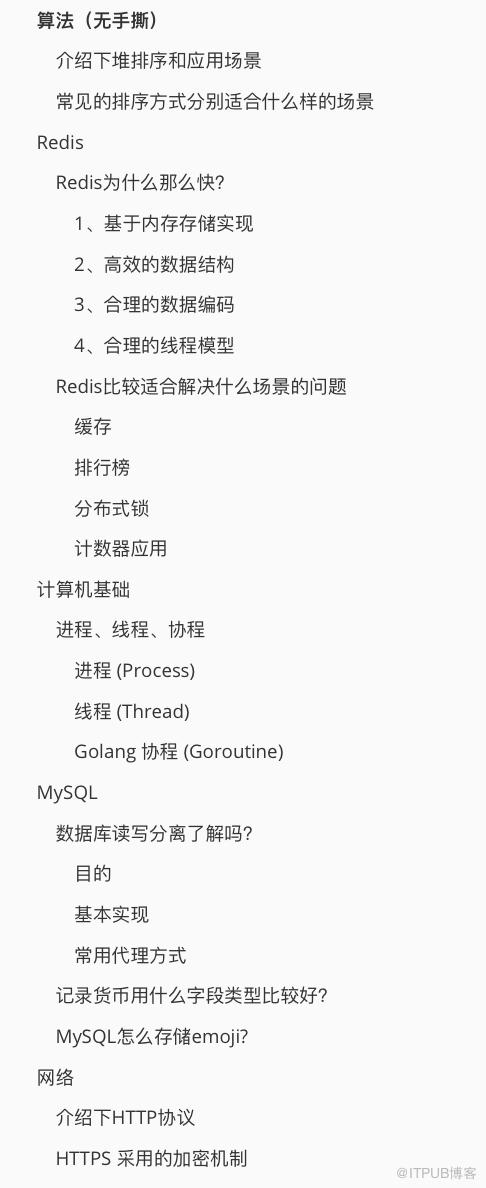
算法(无手撕)
介绍下堆排序和应用场景
堆排序是指利用堆这种数据结构所设计的一种排序算法。
堆积是一个近似完全二叉树的结构,并同时满足堆积的性质:即子结点的键值或索引总是小于(或者大于)它的父节点。堆排序可以说是一种利用堆的概念来排序的选择排序。
分为两种方法:
- 大根堆:每个节点的值都大于或等于其子节点的值,在堆排序算法中用于升序排列。
- 小根堆:每个节点的值都小于或等于其子节点的值,在堆排序算法中用于降序排列。
排序操作步骤:
构建一个大根堆 H[0……n-1] 把堆首(最大值)和堆尾互换 把堆的尺寸缩小 1,并重新构建堆(目的是把交换后的根节点数据调整到相应位置) 重复步骤 2,直到堆的尺寸为 1
应用场景
堆排序在内存受限环境中的应用:因为堆排序不需要额外的存储空间,它适合用于内存受限的环境。
在线算法:堆排序可以被用于在线算法中,即可以一边接收数据一边进行排序。
实时系统:在需要快速响应的实时系统中,堆排序因其确定的时间复杂度而被广泛采用。
优点
空间复杂度低:堆排序是原地排序,只需要常数级别的额外空间。 时间复杂度稳定:对于任何输入数据,堆排序的时间复杂度都是O(n log n)。
缺点
不稳定排序:堆排序是一种不稳定的排序算法,即相等的元素可能改变其原有的顺序。 相较于快速排序,效率较低:尽管平均情况下时间复杂度相同,但在实际应用中,快速排序通常比堆排序更快。
手撕算法贴好,备用
func heapSort() {
	arr := []int{5, 3, 2, 1, 4}
	HeapSort(arr)
}

func HeapSort(arr []int) []int {
	l := len(arr)
	// 获取节点,在从下往上每个节点上构建大根堆,最终得到完整的大根堆
	for i := l / 2; i >= 0; i-- {
		heapMaxRoot(arr, i, l)
	}

	for i := l - 1; i >= 0; i-- {
		// 把堆首(最大值)和堆尾互换
		pkg.SwapInt(arr, 0, i)

		// 重新构建大根堆
		l--
		heapMaxRoot(arr, 0, l)
	}

	return arr
}

// 构建大根堆
func heapMaxRoot(arr []int, i, l int) {
	// i为父节点,确定左右节点索引
	left := i*2 + 1
	right := i*2 + 2
	// 最大值的索引,初始值为i
	maxNumIndex := i
	// 确定存在最大值的索引是否在左右节点
	if left < l && arr[left] > arr[maxNumIndex] {
		maxNumIndex = left
	}
	if right < l && arr[right] > arr[maxNumIndex] {
		maxNumIndex = right
	}
	// 不为当前根节点时,交换数据,并在当时最大值的节点上继续构建大根堆
	if maxNumIndex != i {
		pkg.SwapInt(arr, i, maxNumIndex)
		heapMaxRoot(arr, maxNumIndex, l)
	}
}
常见的排序方式分别适合什么样的场景
大数据集:快速排序、归并排序、堆排序通常适用于大数据集。 稳定性:如果需要稳定的排序结果,应考虑使用归并排序。 内存限制:堆排序和快速排序适用于内存受限的环境。 数据分布:计数排序和桶排序适用于数据分布已知的情况。 特殊需求:根据具体情况选择最合适的算法,例如需要快速响应时选择堆排序。
选择排序算法时,需要考虑数据的特性(如大小、是否接近有序、元素范围等)、对稳定性的需求、可用内存等因素。
Redis
Redis为什么那么快?
1、基于内存存储实现
我们都知道内存读写是比在磁盘快很多的,Redis基于内存存储实现的数据库,相对于数据存在磁盘的MySQL数据库,省去磁盘I/O的消耗。
2、高效的数据结构
我们知道,Mysql索引为了提高效率,选择了B+树的数据结构。其实合理的数据结构,就是可以让你的应用/程序更快。先看下Redis的数据结构&内部编码图:
3、合理的数据编码
Redis 支持多种数据数据类型,每种基本类型,可能对多种数据结构。什么时候使用什么样数据结构,使用什么样编码,是redis设计者总结优化的结果。
4、合理的线程模型
I/O 多路复用
多路I/O复用技术可以让单个线程高效的处理多个连接请求,而Redis使用用epoll作为I/O多路复用技术的实现。并且,Redis自身的事件处理模型(redis是采用单reactor的网络模型,其组成是IO多路复用)将epoll中的连接、读写、关闭都转换为事件,不在网络I/O上浪费过多的时间。
单线程模型
Redis是单线程模型的,而单线程避免了CPU不必要的上下文切换和竞争锁的消耗。也正因为是单线程,如果某个命令执行过长(如hgetall命令),会造成阻塞。Redis是面向快速执行场景的数据库。,所以要慎用如smembers和lrange、hgetall等命令。 Redis 6.0 引入了多线程提速,它的执行命令操作内存的仍然是个单线程。
Redis比较适合解决什么场景的问题
缓存
我们一提到redis,自然而然就想到缓存,国内外中大型的网站都离不开缓存。合理的利用缓存,比如缓存热点数据,不仅可以提升网站的访问速度,还可以降低数据库DB的压力。并且,Redis相比于memcached,还提供了丰富的数据结构,并且提供RDB和AOF等持久化机制,强的一批。
排行榜
当今互联网应用,有各种各样的排行榜,如电商网站的月度销量排行榜、社交APP的礼物排行榜、小程序的投票排行榜等等。Redis提供的zset数据类型能够实现这些复杂的排行榜。
比如,用户每天上传视频,获得点赞的排行榜可以这样设计:1.用户Jay上传一个视频,获得6个赞,可以酱紫:
zadd user:ranking:2021-03-03 Jay 6
2.过了一段时间,再获得一个赞,可以这样:
zincrby user:ranking:2021-03-03 Jay 1
3.如果某个用户John作弊,需要删除该用户:
zrem user:ranking:2021-03-03 John
4.展示获取赞数最多的3个用户
zrevrangebyrank user:ranking:2021-03-03 0 2
分布式锁
几乎每个互联网公司中都使用了分布式部署,分布式服务下,就会遇到对同一个资源的并发访问的技术难题,如秒杀、下单减库存等场景。用java(synchronize或者reentrantlock)或者golang(sync.Mutex或者sync.RMutex或者channel实现的锁)本地锁肯定是不行的。
如果是并发量不大话,使用数据库的悲观锁、乐观锁来实现没啥问题。 但是在并发量高的场合中,利用数据库锁来控制资源的并发访问,会影响数据库的性能。实际上,可以用Redis的setnx+嵌入lua脚本执行检查和删除redis Key来实现分布式的锁。 除此之外,还可以使用官方提供的 RedLock 分布式锁实现。
计数器应用
各大网站、APP应用经常需要计数器的功能,如短视频的播放数、电商网站的浏览数。这些播放数、浏览数一般要求实时的,每一次播放和浏览都要做加1的操作,如果并发量很大对于传统关系型数据的性能是一种挑战。Redis天然支持计数功能而且计数的性能也非常好,可以说是计数器系统的重要选择。
计算机基础
进程、线程、协程
进程 (Process)
进程是计算机程序的一次执行过程,是系统进行资源分配和调度的基本单位。每个进程都有独立的地址空间、数据段、堆栈和资源。进程之间相互隔离,通信需要通过进程间通信(IPC)机制,如管道、消息队列、信号量等。
线程 (Thread)
线程是进程内的一个执行单元,是比进程更小的调度和执行单位。同一进程内的线程共享进程的地址空间、文件描述符和其他资源,使得线程间的通信比进程间通信更高效。线程有自己的栈和寄存器集,但线程的创建和切换仍有一定的开销。
Golang 协程 (Goroutine)
Goroutine 是 Go 语言中一种轻量级的线程,由 Go 运行时调度。Goroutine 的开销远小于标准的 OS 线程,可以轻松创建数万个 Goroutine 同时运行。Goroutine 之间的切换由 Go 运行时管理,无需依赖操作系统的线程调度,这使得 Goroutine 成为并发编程中处理大量 I/O 绑定任务的理想选择。Goroutine 具有自动的调度和上下文切换,使得并发编程更加简单和高效。
MySQL
数据库读写分离了解吗?
读写分离的基本原理是将数据库读写操作分散到不同的节点上,下面是基本架构图:
目的
主从服务器负责各自的读和写,极大程度缓解了锁的争用; 主服务器处理写操作以及实时性要求比较高的读操作,而从服务器处理读操作。 从服务器可以使用 MyISAM,提升查询性能以及节约系统开销; 增加冗余,提高数据库可用性。
基本实现
数据库服务器搭建主从集群,一主一从、一主多从都可以。 主数据库负责读写操作,从数据库只负责读操作。 主数据库通过复制将数据同步到从数据库,每台数据库服务器都存储了所有的业务数据。 业务服务器将写操作发给主数据库,将读操作发给从数据库。
常用代理方式
读写分离常用代理方式来实现,代理服务器接收应用层传来的读写请求,然后决定转发到哪个服务器。
记录货币用什么字段类型比较好?
货币在数据库中MySQL常用Decimal和Number类型表示,这两种类型被MySQL实现为同样的类型。他们被用于保存与货币有关的数据。
例如:salary DECIMAL(9,2),9(precision)代表将被用于存储值的总的位数,而2(scale)代表将被用于存储小数点后的位数。存储在salary列中的值的范围是从-9999999.99到9999999.99。
DECIMAL和NUMBER值作为字符串存储,而不是作为
二进制浮点数,以便保存那些值的小数精度。之所以不使用float或者double的原因:因为float和double是以二进制存储的,所以有一定的误差。
MySQL怎么存储emoji ?
MySQL可以直接使用字符串存储emoji。
但是需要注意的,utf8 编码是不行的,MySQL中的utf8是阉割版的 utf8,它最多只用 3 个字节存储字符,所以存储不了表情。那该怎么办?
需要使用utf8mb4编码。
网络
介绍下HTTP协议
这个问题比较泛了,可以随意发挥。比如从基础概念开始:介绍请求报文和响应报文;也可以介绍HTTP协议的请求方法;HTTP状态码等。
HTTPS 采用的加密机制
HTTPS 采用混合的加密机制
使用非对称密钥加密方式(一般是:RSA),传输对称密钥加密方式所需要的 Secret Key,从而保证安全性; 获取到 Secret Key 后,再使用对称密钥加密方式进行通信,从而保证效率。(下图中的 Session Key 就是 Secret Key)。
对称密钥加密方式的传输效率更高,但是无法安全地将密钥 Secret Key 传输给通信方。而非对称密钥加密方式可以保证传输的安全性,因此我们可以利用非对称密钥加密方式将 Secret Key 传输给通信方。
以上,觉得有用点亮【赞与在看】让我们总能披荆斩棘,挑战自我。
推荐阅读
关于作者:一位热爱技术,并在职场与自媒体间探索的实践者,希望通过分享个人经验和见解,帮助更多人实现自我成长和价值。
如果您对我的公众号内容感兴趣,欢迎关注我。
也可以在下方添加我微信和一支烟花AI社区技术群,一起交流技术、职场心得。欢迎~
原文作者:皇子谈技术;如有侵权,请联系管理员删除。

