大家好,我是极客君,去年鹅厂内部极客圈举办了第二次极客大赛,题目如下:
"实现一个世界上最小的程序来输出自身的MD5"
作为极客圈一员的我也参加了比赛,比赛竞争很激烈,为了争夺一个字节的优势,大家都拿出自己的绝活,比赛重新刷新了我对汇编的认知和对程序运行原理理解,昨天分享一个典型的朴素解法:
但这篇"菜鸟"朴素解法,已经让有些人看得不知所云,其实要完全理解其中一些技巧,可能需要实际操作一下,计算机实践很重要,看不懂也可以做个吃瓜群众,长长见识也可以。
上篇文章说过点赞在看超过20,今天就放出大神解法,我相信此法一出,评论区会一片惊呼:
A:天啊,这个男人不得了,他做到了最短!
B:神仙打架
C : 膜拜第一名大佬,各种技巧溜得飞起,学习了
D : 跪着看完了,厉害!
E : 降维打击
...
文章稍微有点长,不想慢慢看完,可以直接拉到底,接下来该你上场表演了 。
开阔眼界的大神解法
299字节打印自身的MD5,NO.1(冠军)
用 nasm 写汇编,手动构造 ELF 格式文件。ELF 文件分为三部分:
[A] [B] [C]其中 A 的长度为 64 的倍数,B+C 的长度 <= 55。
A+B 包括:ELF 文件头、计算 MD5 一个 block 的代码、输出 16 进制的代码。尽可能压缩这部分代码的大小。
C 是对 A 计算 MD5(不加 padding)的中间结果,13 字节。(为什么是 13 不是 16?因为撞了 3 个字节,详见下文。)
思路
大的方向无非就这些:
撞:理想情况下,我们的程序就简单执行一条输出指令,撞出一个满足
MD5(print(md5_string)) == md5_string的md5_string。利用外部能力:调用外部程序,或者利用 Linux 内核中的 MD5 实现。
算:程序读取自身,计算 MD5 并输出。
如果考虑撞,MD5 有 128 位,2 的 128 次方据说已经超过了宇宙中基本粒子的数量,穷举显然是不行的,只能用密码学的方法构造。鉴于本文作者的密码学知识接近于 0,就不卖弄了,不过据群里的同学说这样构造出来的文件会很大,并不适合本次比赛。
而利用外部能力的路已经被堵死,不允许 fork,也不允许使用 socket,此路不通。
看来可行的方法就是算,成了一个纯工程优化问题。这一块正好本文作者有点经验,研究生方向是编译器,做的题目是 code size reduction。
MD5 算法
第一想法是去抄开源代码,我一开始抄了 Linux kernel 里的 MD5 实现,但后来发现并不适合本次比赛。开源的 MD5 实现为了性能大都做了人工循环展开和常量预计算,会把代码撑得很大。不如直接照着 MD5 算法的伪码来写,维基百科上面的伪代码写得够清晰,就它了。
简单描述:
需要先对原始数据做 padding,将它的长度变成 64 字节的整数倍,MD5 算法在 64 字节长的 block 上进行。
具体 padding 方法:在原始数据后增加一字节 0x80,然后再增加若干个 0,直到总长度为 64 的倍数,并且最后至少留出 8 个字节的位置,用于填写 little endian 编码的原始数据总长度(按位计,即字节数乘以 8)。
Padding 完成后,对每个 64 字节 block 进行计算,block 的计算方法参考下一节的代码。每一轮计算结束后更新 16 字节的 MD5 状态,最后一轮计算完成后,将状态用 16 进制打印出来。
C++ 实现
以下是一个 C++ 写的完整实现,在不太损失可读性的前提下用较简短的写法,不考虑性能:
#include <cmath>
#include <cstdio>
#include <cstring>
#include <memory>

using namespace std;

static const uint8_t SHIFT[] = {7, 12, 17, 22, 5,  9, 14, 20, 4, 11, 16, 23, 6, 10, 15, 21};

// 注:为了省事,下面代码假设了 CPU 是 little endian
static void compute_md5(void* result, const void* orig_data, size_t orig_size) {

  uint32_t* hash = reinterpret_cast<uint32_t*>(result);
  hash[0] = 0x67452301;
  hash[1] = 0xefcdab89;
  hash[2] = 0x98badcfe;
  hash[3] = 0x10325476;

  // 计算padding后的总长度
  size_t padded_size;
  if (orig_size % 64 > 55) {
    padded_size = orig_size / 64 * 64 + 128;
  } else {
    padded_size = orig_size / 64 * 64 + 64;
  }

  // 增加padding
  std::unique_ptr<char[]> padded_data(new char[padded_size]);
  memset(padded_data.get(), 0, padded_size);
  memcpy(padded_data.get(), orig_data, orig_size);
  padded_data[orig_size] = 0x80;
  *(uint64_t*)(padded_data.get() + padded_size - 8) = orig_size * 8;

  // 开始计算
  for (const uint32_t* data = (const uint32_t*)padded_data.get();
      padded_size >= 64; data += 16, padded_size -= 64) {
    uint32_t a = hash[0];
    uint32_t b = hash[1];
    uint32_t c = hash[2];
    uint32_t d = hash[3];
    for (int i = 0; i < 64; ++i) {
      uint32_t f, g;
      if (i < 16) {
        f = ((c ^ d) & b) ^ d;   // 等价于 (b & c) | ((~b) & d);
        g = i;
      } else if (i < 32) {
        f = ((b ^ c) & d) ^ c;    // (d & b) | ((~d) & c);
        g = 5*i + 1;
      } else if (i < 48) {
        f = b ^ c ^ d;
        g = 3*i + 5;
      } else {
        f = c ^ (b | (~d));
        g = 7*i;
      }
      uint32_t K = static_cast<uint32_t>(fabs(sin(i + 1)) * 4294967296.0);
      f += a + K + data[g % 16];
      int shift_val = SHIFT[(i / 16) * 4 + (i % 4)];
      f = (f << shift_val) | (f >> (32 - shift_val));
      a = d;
      d = c;
      c = b;
      b += f;
    }
    hash[0] += a;
    hash[1] += b;
    hash[2] += c;
    hash[3] += d;
  }
}

int main(int argc, char** argv) {
  FILE* fp = fopen(argv[0], "rb");
  if (fp == nullptr) {
    perror("Failed to open file");
    return 1;
  }

  char buffer[65536];
  size_t len = fread(buffer, 1, sizeof(buffer), fp);
  fclose(fp);

  unsigned char result[16];
  compute_md5(result, buffer, len);

  for (int i = 0; i < 16; ++i) {
    printf("%02x", result[i]);
  }
  putchar('\n');
  return 0;
}
这个版本用 g++ -Os 编译出来,strip 一下,不做其他处理,大约 14 KB。
用汇编改写
接下来的任务就是想办法用汇编重写这个 14 KB 的程序,将代码压缩到最小。
手动构造 ELF
手动构造 ELF 网上能找到不少例子,例如:Smallest executable program (x86-64)。它使用 nasm 构造了一个最小的 64 位 ELF,先照着它搭个架子。
这个例子提供了两个思路:(1) ELF 头部有很多不重要的字段,可以用来放代码或数据 (2) ehdr 的最后 8 个字节和 phdr 的最前面 8 个字节可以重合。
借助 nasm 可以很容易地将 file size 硬编码到代码里。还有 %define、%if 等也可以帮助我们省很多事。
手动构造 ELF 以后,也不再需要再去读文件,加载到内存里的地址完全受我们控制了,直接去读。
系统调用
没有 C 库以后,系统调用需要自己写。x86-64 有 syscall 指令,发起系统调用很方便。
入参:
eax = 系统调用号,可以在
/usr/include/asm/unistd_64.h文件中找到rdi, rsi, rdx, r10, r8, r9 分别为第 1 至 6 个参数
出参:
rax = 返回值(如果失败,返回 -errno)
rcx, r11 被破坏(它们分别被 syscall 指令用来保存返回地址和 rflags)
其他寄存器的值保留
假设栈顶 32 字节是计算好的 MD5 字符串,输出的系统调用:
   0:   b8 01 00 00 00          mov    eax,0x1        ; write 系统调用
   5:   bf 01 00 00 00          mov    edi,0x1        ; 标准输出
   a:   48 89 e6                mov    rsi,rsp        ; 指针
   d:   ba 20 00 00 00          mov    edx,0x20       ; 长度 32 字节
  12:   0f 05                   syscall
汇编代码优化
-
预先计算 MD5 中间状态
将 ELF 文件分为三部分:[A] [B] [C]
其中 A 的长度为 64 的倍数,B+C 的长度 <= 55。
A+B 包括:ELF 文件头、计算 MD5 一个 block 的代码、输出 16 进制的代码。
C 是对 A 计算 MD5(不加 padding)的中间结果,16 字节,由辅助脚本计算并填入。(后面会把 C 变成 13 字节,见下文。)
这样可以省掉外层循环,汇编只用计算最后 64 位字节。
-
避免 copy
默认 text 段是不可写的,可以修改 p_flags,从 5 (可读可执行) 写为 7 (可读写可执行),同时把 p_memsz 改大一些。这样 padding 就可以直接加在后面,不需要再拷贝到栈上。
-
分支之间共用指令
注意最内层的那一串 if-else:有两个分支都用到
b^c,还有两个分支计算f的最后一步是^c,还两个分支计算f的最后一步是^d。这里代码都可以共用,不仅可以省掉几个字节,更重要的是,分支代码码变得更短以后,更容易塞到文件头里面。 -
指令选择
尽量选用早期 x86 就有的指令,一般编码会比较短。很多不常用的指令,只因为生得早,占了好坑,都只要一两个字节。
例如:
lodsb只要一个字节,而mov al,[rsi]; inc rsi要好几个。又如,
loop addr指令大致相当于dec ecx; jnz addr,也少了好几个字节。没有哪个现代编译器会主动生成这个指令,实际上 Intel 也不建议用,较新的 CPU 里没有为这个指令做优化,性能偏低。但对本题却相当合适。拿不准的时候多试几次,用 objdump 看哪个短。
-
寄存器的选择
优先使用从 32 位时代沿袭下来的 8 个寄存器 (rax, rbx, rcx, rdx, rsi, rdi, rbp, rsp),避免使用 r8-r15。对于很多指令,使用 r8-r15 会多占一个字节。例如:
 0:   41 83 e0 01             and    r8d,0x1
4: 83 e0 01 and eax,0x1 -
用最短的代码赋值小常量给寄存器
对 0 值,对寄存器异或自身:
xor eax, eax。这个很常见,减少代码体积,也不损失性能,Intel 也推荐这样写。对于非 0 值,下面的写法就损失性能了,但对本题有用。
将常量 1 赋给 ebx,最自然的写法 5 个字节:
0: bb 01 00 00 00 mov ebx,0x1这样写只要 4 个字节(如果知道 ebx 的高位已经是 0,则只需后一指令,2 个字节):
0:   31 db                   xor    ebx,ebx
2:   b3 01                   mov    bl,0x1
这样写只要 3 个字节:
0:   6a 01                   push   0x1
2: 5b pop rbx -
32 位 or 64 位寄存器
x86-64 有一个特性,目标操作数是 32 位寄存器时,会同时清空对应 64 位寄存器的高 32 位。所以
xor eax, eax与xor rax, rax等价;mov eax, 1也与mov rax, 1等价。使用 32 位寄存器常常可以省一个字节(r8-r15 除外):0: 31 c0 xor eax,eax
2: 48 31 c0 xor rax,rax但注意,在作为地址时,情况相反,64 位少一个字节:
0:   67 8d 43 08             lea    eax,[ebx+0x8]
4: 8d 43 08 lea eax,[rbx+0x8] -
进程初始状态
网上说 Linux 进程启动时,除了 RCX 以外,其他寄存器的值都不确定。但实测拿到的都是 0,所以省略对寄存器清 0 的操作。
(有的资料说其他寄存器会继承
execve之前的值,懒得去验证,不过对此存疑。如果操作系统不清 0,这会是一个安全漏洞,父进程可能无意中漏泄信息给子进程。) -
使用 16 位地址
ELF 的常见初始虚拟地址是诸如 0x8048000 这样的值,把它改成 0x1000,这样两个字节可以放下地址。
不能比 0x1000 更小了,因为 0x1000 == 4096 是一个页面的大小,在最前面至少要留一个页面,否则 NULL 会成为有效指针。
-
栈优化
栈涉及到内存操作,比用寄存器慢。然而 push、pop 作为元老级的 8086 指令,编码超级短,前 8 个寄存器的 push、pop 只要一个字节。
0:   50                      push   rax
1:   5b                      pop    rbx
2:   48 89 c3                mov    rbx,rax
在这个例子里,出栈再入栈竟然比 mov 少一个字节!
-
浮点运算
现在 Intel 推荐用 SSE/AVX 来做浮点运算,但对本题还是 x87 香,计算 sin、取绝对值都是一条指令的事情(两个字节)。
x87 寄存器是栈式的,写复杂的算式比较麻烦。好在本题的式子并不复杂,下面几行代码就可以计算出
(fabs(sin(i + 1)) * 4294967296.0),其中[rbx-0x14]指向一个预存了4294967296.0的地址。10d4: 50 push rax ; i+1 入栈
10d5: db 04 24 fild DWORD PTR [rsp] ; 转成浮点数,放到st0
10d8: d9 fe fsin ; sin
10da: d9 e1 fabs ; abs
10dc: d8 4b ec fmul DWORD PTR [rbx-0x14] ; 乘以 4294967296
10df: dd 0c 24 fisttp QWORD PTR [rsp] ; 转成整数,写到栈顶
10e2: 5a pop rdx ; 出栈,读到结果 -
pext 指令
C++ 代码里有一处
(i / 16) * 4 + (i % 4),很适合用 pext 指令来实现。pext 是一条 BMI 2 指令,可以简便地从源操作数里抽一些不连续的位出来。假设
i放在 eax,那么用pext ecx, eax, bit_mask(bit_mask = 0b00110011) 就可以从i里面提取出第 0、1、4、5 位,正好就是(i / 16) * 4 + (i % 4)的值。 -
使用 near 跳转
jmp、jcc 都有 8 位偏移和 32 位偏移两个版本。32 位太浪费,尽量调整代码块的位置,让所有跳转都变成 8 位(跳转范围在 -128 至 127 字节之间)。实在避免不了的,用两条短 jmp 中转一下都能节省一个字节。
-
寻址优化
x86-64 提供了相对 rip 的寻址,为位置无关代码(PIC)提供了很大便利。又由于它比绝对寻址短,所以编译器通常在非 PIC 代码中也会使用它。
但遗憾的是,它始终使用 32 位偏移量,太浪费。可以考虑固定使用一个寄存器保存一个地址,后面的寻址都相对它进行,并设法将偏移保持在 8 位的范围内(-128 至 127)。
对比以下三条指令的长度:
0:   8b 43 02                mov    eax,DWORD PTR [rbx+0x2]
3:   8b 05 02 00 00 00       mov    eax,DWORD PTR [rip+0x2]
9: 8b 04 25 02 00 00 00 mov eax,DWORD PTR [0x2] -
调用函数
call 指令没有 8 位偏移的版本,32 位偏移很浪费。先将函数地址装到一个寄存器,再 call 这个寄存器,只要两个字节:
0: ff d3 call rbx
最后撞三个字节
写完代码以后,发现 ELF 头部还剩两个可以自由修改的字节。代码里还有一些等效的指令,例如,当已知 eax 和 ecx 的值相等时,下面四条指令等价:
lea     ecx, [rax+rax*4+1]
lea     ecx, [rax+rcx*4+1]
lea     ecx, [rcx+rax*4+1]
lea     ecx, [rcx+rcx*4+1]
又如,在判断循环条件时,下面代码里的 jb 可以替换为 jne:
inc   eax
cmp   al, 64
jb    _loop_md5
于是,通过给 nasm 增加参数 -Dalternative=...,并在代码里使用 %if alternative = ... 来选择使用哪一种等价的写法。
再写一个额外的程序来遍历头部两个字节的值,以及代码中这些有 alternative 的地方的指令选择,使得计算出的 MD5 的中间结果的最后三个字节是 0x80 0x00 0x00,即与 MD5 padding 的前三个字节相同,这样就可以从文件内容中省去这三个字节。
代码
完整代码:
bits 64

    ; 定义“变量”对应的寄存器
    ; R_ 表示 64 位,r_ 表示对应的 32 位,_w 表示低 16 位, _l 表示低 8 位
    %define r_base ebx          ; 始终指向$$+offs
    %define R_base rbx
    %define r_base_w bx
    ;%define r_a  r8d            ; a,b,c,d 在内层循环中保存MD5状态
    ;%define R_a  r8            ; r_a 现在不占用寄存器了,移到栈顶 [rsp]
    %define r_b  edi
    %define R_b  rdi
    %define r_c  ebp
    %define R_c  rbp
    %define r_d  edx
    %define R_d  rdx
    %define r_i  eax            ; 内层循环下标
    %define R_i  rax
    %define r_i_l al
    %define r_f  esi            ; 内层循环中的变量 F
    ; ecx用作临时变量

; 一般是使用 0x8048000,故意改成一个很小的数,以便两个字节可以放下地址
%define base 0x1000
            org base
ehdr:                                           ; Elf64_Ehdr
            db  0x7F, "ELF", 2, 1, 1, 0         ;   e_ident
    ; times 8 db  0

    ; 这个代码块正好8字节,放这里
_16_to_32:
    ; if (16 <= i && i < 32) {
    ;    g = 5*i + 1;
    ;    f = ((b ^ c) & d) ^ c;    // (d & b) | ((~d) & c);
    ; }
    %if alternative = 1   ; alternative用于控制生成多种等效的代码,fill.py会对它们进行遍历,
                          ; 找到使MD5中间结果最后几个字节恰好等于 0x80 0x00 0x00 的组合
    lea     ecx, [R_i+R_i*4+1]
    %elif alternative = 2
    lea     ecx, [R_i+rcx*4+1]
    %elif alternative = 3
    lea     ecx, [rcx+R_i*4+1]
    %else
    lea     ecx, [rcx+rcx*4+1]
    %endif
    and     r_f, r_d
    jmp     _reuse_code         ; _16_to_32 与 _32_to_48 最后一条指令相同,jmp过去省两个字节
times 8 - ($ - _16_to_32) db 0
    ; end
            dw  2                               ;   e_type
            dw  62                              ;   e_machine
            ;dd  1                               ;   e_version (modifiable)
_0x1p32     dd   4294967296.0    ; pow(2.0, 32)
            dq  _start                          ;   e_entry
            dq  phdr - $$                       ;   e_phoff
            ;dq  0                               ;   e_shoff (modifiable)
            ;dd  0                               ;   e_flags (modifiable)
            ;dw  ehdrsize                        ;   e_ehsize (modifiable)

; 14个可以修改的字节,放一个函数在此(13字节)
    ; 将al低4位转为1位16进制
_make_hex:
    and     eax, 15
    cmp     al, 10
    jb      .lt10
    add     al, 'a' - '0' - 10
.lt10:
    add     al, '0'
    stosb
    ret
    ; 剩一个字节,放pext的mask
    %if alternative = 1
_pext_mask  db  0b00110011
    %elif alternative = 2
_pext_mask  db  0b01110011
    %elif alternative = 3
_pext_mask  db  0b10110011
    %else
_pext_mask  db  0b11110011
    %endif
times 14-($-_make_hex) db 0

            dw  phdrsize                        ;   e_phentsize

            ;; overlap the last 8 bytes of ehdr with phdr
phdr:                                           ; Elf64_Phdr
            dd  1                               ; p_type = 1
                                                ;   e_phnum (word, 1)
                                                ;   e_shentsize (word, modifiable)
            db  7                               ; p_flags=7 (readable, writable, executable)
            db  0    ; 这个字节留给fill.py修改 (p_flags只要最低1字节对即可,高位随便改)
_context_ptr dw  base + (_context - $$)         ;   e_shnum (word, modifiable)
                                                ;   e_shstrndx (word, modifiable)

ehdrsize    equ $ - ehdr

            dq  0                               ;   p_offset
            dq  $$                              ;   p_vaddr
            ;;dq  $$                              ;   p_paddr (modifiable)
_0_to_16: ; 这个代码块正好8字节,放这里
    ; if (i < 16) {
    ;     g = i;
    ;     f = ((c ^ d) & b) ^ d;   // (b & c) | ((~b) & d);
    ; }
    mov     r_f, r_c
    xor     r_f, r_d
    and     r_f, r_b
    jmp     _reuse_code_2       ; _0_to_16 与 _48_to_64 最后一条指令相同,jmp过去省两个字节
times 8-($-_0_to_16) db 0

            dq  filesize                        ;   p_filesz
            ;dq  filesize+512                    ;   p_memsz
            ; 挪用p_memsz用于存一些其他数据,只要这里填的值至少比filesize大一些,但又不要过于
            ; 巨大以免运行错误
_16_to_32_relay: jmp short _16_to_32   ; 中转向_16_to_32的跳转,便得两处跳转都使用8位偏移量
_compute_start_ptr dd  ($$ + filesize - filesize % 64)
times (8 - ($ - _16_to_32_relay)) db 0

            ;dq  0x1000                          ;   p_align
            ;; p_align是phdr的最后8个字节,对静态链接的代码没什么用,省去
phdrsize    equ     $ + 8 - phdr

_shift      db 7, 12, 17, 22, 5,  9, 14, 20, 4, 11, 16, 23, 6, 10, 15, 21

%assign start_of_code base + ($ - $$)
%warning code: start_of_code

_48_to_64:
    ; if (i >= 48) {
    ;     g = 7*i;
    ;     f = c ^ (b | (~d));
    ; }
    %if alternative = 1
    imul    ecx, r_i, 7
    %else
    imul    ecx, 7
    %endif
    mov     r_f, r_d
    not     r_f
    or      r_f, r_b
_reuse_code:
    xor     r_f, r_c
    jmp     _join

; R_base 偏移 offs 字节,指向 _make_hex
offs    equ     _make_hex - $$

    ; 程序入口
_start:
    mov     r_base_w, base + offs           ; mov     r_base, $$ + offs
                                            ; 文档说进程启动时rdi的值未定,但实测至少tlinux2
                                            ; 保证了它是0
    mov     esi, [R_base - offs - $$ + _context_ptr]
                                       ; 本来这里应该用movzx读2个字节的,但正好后面2个字节也是0,就用mov省一个字节
    push    rsi
    ; MD5 padding
    mov     byte [rsi + _end - _context], 0x80
    mov     word [rsi + _end - _context + paddingsize - 8], filesize*8

    ; uint32_t a = hash[0];
    ; uint32_t b = hash[1];
    ; uint32_t c = hash[2];
    ; uint32_t d = hash[3];

    push    qword [rsi]
    mov     r_b, [rsi + 4]
    mov     r_c, [rsi + 8]
    mov     r_d, [rsi + 12]

    ; for (int i = 0; i < 64; ++i) {
    ; xor     r_i, r_i  ; 文档说启动时rax的值未定,实测至少tlinux2上进程启动时eax=0
_loop_md5:

    ; 有两个分支用到 b^c,在分支前先算出来放到f,省两个字节
    mov     r_f, r_b  ; f = b ^ c
    xor     r_f, r_c
    mov     ecx, r_i  ; g = i

    cmp     r_i_l, 16
    jb      _0_to_16
    cmp     r_i_l, 32
    jb      _16_to_32_relay
    cmp     r_i_l, 48
    jae     _48_to_64

_32_to_48:
    ; if (32 <= i && i < 48) {
    ;    g = 3*i + 5;
    ;    f = b ^ c ^ d;
    ; }
    %if alternative = 1
    lea     ecx, [R_i+R_i*2+5]
    %elif alternative = 2
    lea     ecx, [R_i+rcx*2+5]
    %elif alternative = 3
    lea     ecx, [rcx+R_i*2+5]
    %else
    lea     ecx, [rcx+rcx*2+5]
    %endif
_reuse_code_2:
    xor     r_f, r_d

_join:
    ; f += a
    ; a = d;
    ; (d := garbage)
    xchg    r_d, [rsp]
    add     r_f, r_d

    ; f += in[g % 16];
    and     ecx, 15
    mov     r_d, [R_base - offs - $$ + _compute_start_ptr]
    add     r_f, [R_d + rcx*4]

    ; int shift_val = _shift[(i / 16) * 4 + (i % 4)];
    pext    ecx, r_i, [R_base-offs-$$+_pext_mask] ; _pext_mask的高24位不是0,不过不影响,因为r_i高位全是0
    mov     cl, [R_base-offs-$$+_shift+rcx]     ; [_shift + rcx]

    ; K[i] := floor(2^32 × abs (sin(i + 1)))
    inc     r_i
    push    R_i
    fild    dword [rsp]
    fsin
    fabs
    fmul    dword [R_base-offs-$$+_0x1p32]    ; * 2^32
    fisttp  qword [rsp]

    ; f += K[i]
    pop     R_d         ; 把r_d当作临时寄存器用一下,pop出来的是刚才fisttp写入[rsp]的值,即K[i]
    add     r_f, r_d

    ; f = (f << shift_val) | (f >> (32 - shift_val));
    rol     r_f, cl

    ; d = c;
    ; c = b;
    ; b += f;
    mov     r_d, r_c
    mov     r_c, r_b
    add     r_b, r_f

    ; }
    cmp     r_i_l, 64
    %if alternative = 1
    jb      _loop_md5
    %else
    jne     _loop_md5
    %endif

    ; hash[0] += a;
    ; hash[1] += b;
    ; hash[2] += c;
    ; hash[3] += d;
    pop     rax     ; A
    pop     rsi     ; _context
    add     [rsi], eax
    add     [rsi+4], r_b
    add     [rsi+8], r_c
    add     [rsi+12], r_d

    ; PRINT HEX
    ;xor     ecx, ecx  ; 从前面循环里出来,ecx高位还是0
    mov     cl, 16     ; mov ecx, 16
    lea     edi, [rsi+16]

.loop_print_hex:
    mov     al, [rsi]
    shr     eax, 4
    call    R_base      ; call _make_hex
    lodsb
    call    R_base      ; call _make_hex
    loop    .loop_print_hex

    ;rsi is already buffer of hex string
    mov     al, 1       ; mov eax, 1 (write) (eax高位已经是0)
    mov     edi, eax    ; mov edi, 1 (1 = stdout)
    %if alternative = 1
    lea     edx, [rax+31] ; mov edx, 32
                          ; 用lea比mov短一点
    %else
    lea     edx, [rdi+31]
    %endif
    syscall
    ; 返回后eax=32

    ; EXIT
    %if alternative = 1
    mov     al, 231        ; exit_group (eax高位已经是0)
    %elif alternative = 2
    add     al, 231-32     ; 同上
    %elif alternative = 3
    sub     al, 32-231     ; 同上
    %elif alternative = 4
    mov     al, 60         ; exit (eax高位已经是0)
    %elif alternative = 5
    add     al, 60-32      ; 同上
    %else
    sub     al, 32-60      ; 同上
    %endif
    xor     edi, edi
    syscall

%if ($ - $$) % 64 > 64 - 13 - 9
%assign wasted_padding 64 - ($ - $$) % 64
%warning Wasted padding bytes: wasted_padding
    align   64
%endif

; _context 的初始内容由 fill.py 填入
_context:
times 13 db 0  ; 最后三个字节由fill.py保证正好是0x80 0x00 0x00 (和MD5的padding一致)


_end:

filesize   equ     $ - $$
main_loops equ     (filesize + 9 + 63) / 64     ; MD5算法循环次数
paddingsize equ   64 * main_loops - filesize    ; 原始数据后需要附加的字节数

%assign filesize filesize
%warning File size: filesize
光凭这个 asm 还不够,还要配合碰撞的脚本才能编译出来正确的二进制:
README.md:解题描述
build.ninja:编译脚本
main.asm: 主程序
fill.py: 用于碰撞 3 个字节的脚本
fill_helper.cpp: fill.py 的辅助代码(用 C++ 加速)
md5.out: 最终的 299 字节可执行文件
cpp_reference.cpp:C++ 参考实现
最终文件 md5.out 。从源码编译需要先安装 Python 3、ninja、nasm,然后运行 ninja 命令,等 10~20 分钟(取决于机器性能),就能得到 md5.out。
感兴趣的小伙伴,可以在公众号回复“md5”获取完整实现。
大神解法,我是跪着看完了 ,欢迎小伙伴在留言区打上666
 ,膜拜一下大佬,
如果文章给你长见识了,那就一键三连继续支持 ,点赞和在看超过30,我就放另辟蹊径的野路子解法:
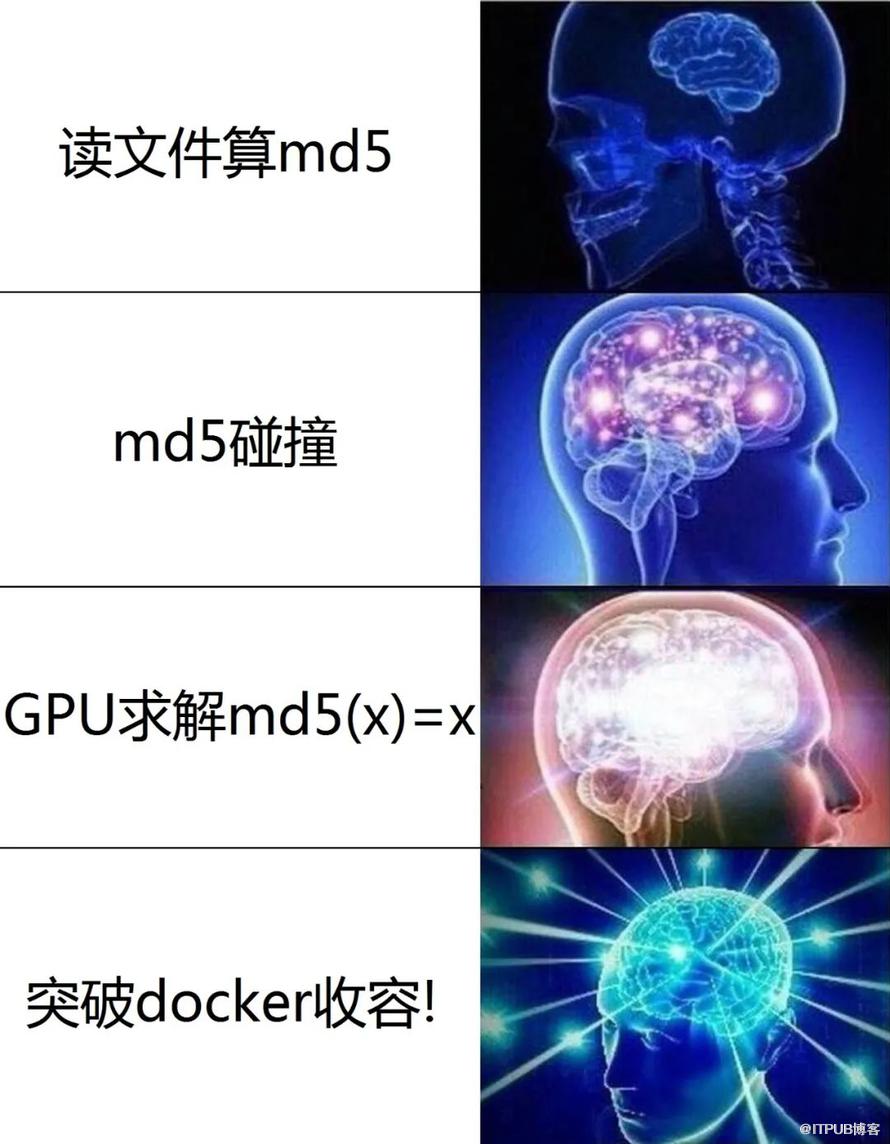
绝对让你感叹脑洞如此之大,让人望其项背。

原文作者:极客重生;如有侵权,请联系管理员删除。

