
有同学在阅读经典书籍《深入理解linux内核》第三版220页时候,产生一个疑问:这个是必须吗 ?为什么?书上有错误吗?
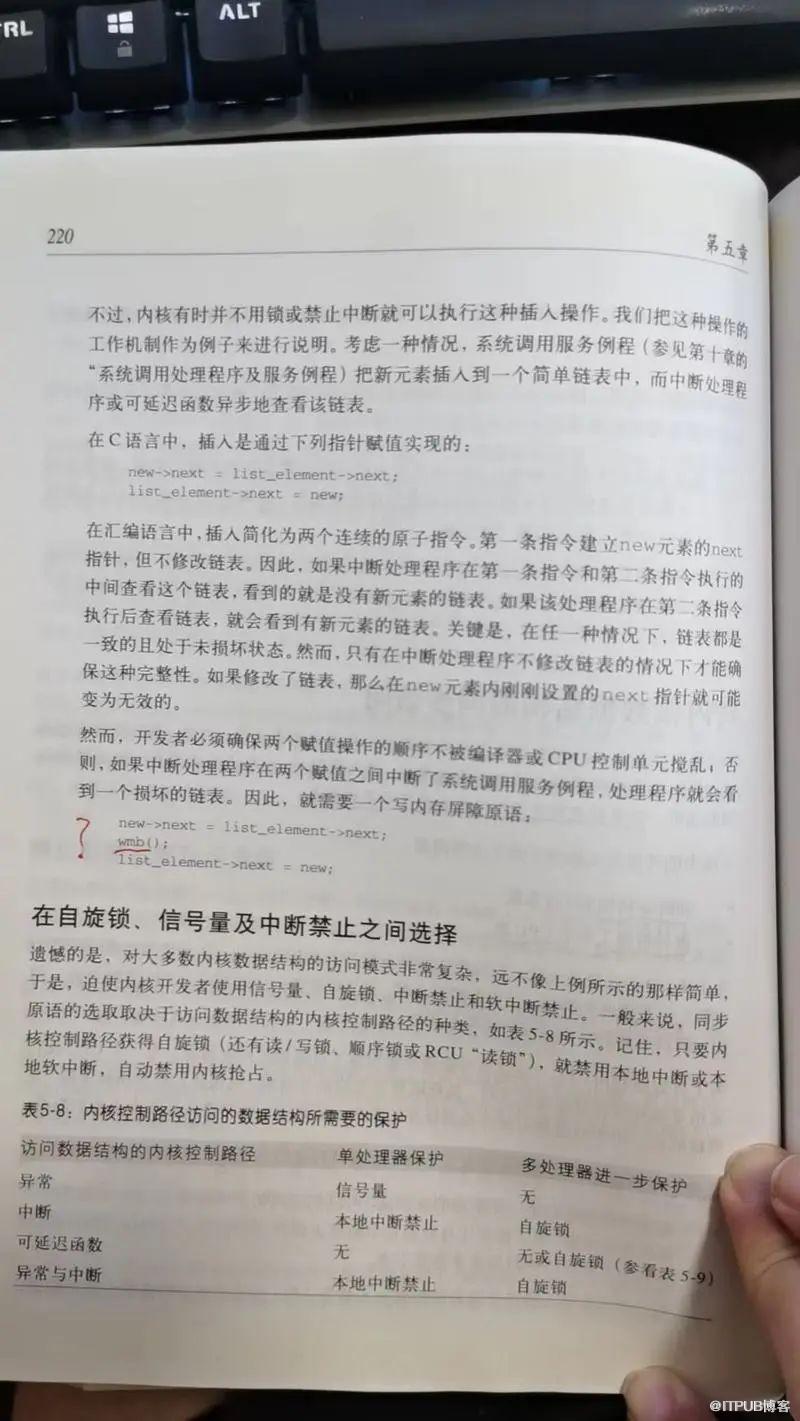
这个问题很有意思,是个好问题,值得思考,第一时间同步到极客星球群里,让感兴趣同学试一试:
第一个问题这里会不会乱序?
new->next = list_element->next;list_element->next = new;
第一眼看上去,我们会认为这个是有数据依赖的,理论上不应该乱序,我们先搞明白什么为什么CPU要乱序执行,什么叫数据依赖等问题。
为什么CPU需要乱序执行?
顺序执行要求指令一条接一条地流过各个流水线,这个过程非常“冯诺依曼”,因为冯诺依曼提出的计算机就是存储指令、一条接一条。这样做有潜在的坏处,如果一条指令被阻塞,那么它后面的指令也被阻塞,即使后面的指令完全可以继续运算而不受被阻塞指令的影响。所以聪明的设计师想到要开几条“近道”,好让后面的指令能绕过恰过前面的指令,从而继续执行。

流水线在按序执行的情况下,一旦遇到指令依赖的情况,流水线就会停滞,这会让流水线的执行效率大大降低。通过乱序执行,合理调整指令的执行顺序,可以提高流水线的运行效率,让指令的执行能够尽可能地并行起来。
当前主流高性能CPU都是超标量多流水线多发射处理器,乱序执行是广泛使用的技术,处理器都想方设法消除依赖,最大化并行执行指令,提升处理器执行效率。
理解指令之间的数据依赖
当我们说两条指令之间存在“依赖关系”时,一般存在下面几种情况:
a = b + c; // 第一条指令d = a + e; // 第二条指令
2、写后读(Write After Read,WAR):第二条指令写入第一条指令读取的数据。例如:
a = b + c; // 第一条指令b = d + e; // 第二条指令
在这个例子中,第一条指令读取b的值,并计算b+c的结果。第二条指令计算d+e的结果并将其写入b。因此,这两条指令之间存在写后读的依赖关系序。
3、写后写(Write After Write,WAW):两条指令都写入同一块数据。例如:
a = b + c; // 第一条指令a = d + e; // 第二条指令
在这个例子中,两条指令都试图将计算结果写入a。因此,这两条指令之间存在写后写的依赖关系。
我们问题场景应该属于“写后读”(Write After Read,WAR):
new->next = list_element->next;list_element->next = new;
抽象一下:
a = b;b = c;
传统意义上依赖关系,如果乱序执行(第二条指令先执行),那a的值可能不一样,这样编译器或者CPU就不能乱序了,毕竟乱序前提是保证结果一致性。那书上说得是不是有问题?这还得了解一下计算机体系结构的发展优化。
计算机体系结构发展
计算机系统是一直在发展演进的,现代的高性能处理器基本都支持多发射和乱序执行,但处理器受数据冒险(处理器专属名称,就是指令间数据依赖)的影响并不能轻易实现乱序,所以业界提出了诸如记分牌和Tomasulo等算法来控制这个过程。简单来说记分牌算法核心思想:

在记分牌算法中,采用ScoreBoard这样的存储、控制单元精确地监控了各条指令之间的三种数据冒险:写后读、读后写、写后写。通过ScoreBoard中的各种tag,可以判断出新发射的指令是否需要读取前序指令的结果(写后读),也可以判断准备写回的指令是否会覆盖掉前序指令将要读取的数据(读后写),还可以判断准备发射的指令是否会和前序指令的目的寄存器重合(写后写)。根据判断结果,SocreBoard采用停滞发射、tag广播和停滞写回机制解决了三种数据冒险,从而在逻辑上支持了乱序执行。
但记分牌算法也存在缺点:
会因为 WAR 和 WAW 冒险而产生阻塞,且一旦产生阻塞,后续相同类型的指令就没办法继续发射
-
如果后续相同类型的指令没法发射,那么更后面的也许可以立马执行的指令也会被阻塞到,这对性能有很大的影响。
要充分发挥乱序执行的性能,就要消除假依赖( WAR 和 WAW ),消除假数据相关的主要方法是寄存器重命名。也就是Tomasulo算法。

三种数据冒险
如果把AND指令的目的寄存器改写成R10,那么冒险就消除了,AND指令可以发射,只不过写回的目的寄存器是R10而不是R3。
“读后写”和“写后写”冒险都可以解决,那“写后读”冒险可以解决吗?实际上“写后读”冒险无法解决,因为后序指令读取的数据由前序指令算得,这个过程有明确的数据依赖,其表现在在数据流图中就是前序指令的计算结果指向了(传送向)后序指令。
这三个冒险的重要差别就出在“数据依赖”上。“读后写”和“写后写”通过改写寄存器名字就可以消除冒险,这表明这两种冒险其实没有数据依赖,即发生冒险的指令之间其实没有数据流动。想要挖掘出指令的乱序潜力,理解这一点非常重要。实际上程序指令的终极目的是运算,假如可以在任意时刻得到截至目前的所有运算结果,那这个结果放在哪里就并不重要。
可以通过改写寄存器名字就可以消除冒险,这表明这两种冒险其实没有数据强依赖,即发生冒险的指令之间其实没有数据流动。只有写后读,才有强数据依赖,这种很难优化,我想说的是,CPU通过寄存器重名解决看起来数据依赖问题(假依赖),这样CPU就可以放心的乱序了,所以这里还是会乱序的。
详细了解可以参考资料:计算机体系结构-Tomasulo算法
如果要乱序,我们应该怎么处理?
这里如果是单核CPU,乱序是不影响结果的,但现在服务器都是多核CPU,在多核环境下,其他CPU可能依赖这个CPU的执行顺序(比如同步),所以需要保证可序性,针对这个问题,为了不让其他CPU访问到这个链表结构是坏的:
1 new->next = list element->next ;//而这行代码不改变存量链表结构,只是修改新增节点结构。2 list_element->next = new;// 这行很关键,这句会改变原来的连接的结构,
这里wrb是怎么让CPU不乱序的呢?
内存屏障 (Memory Barrier)其作用有两个:
防止指令之间的重排序
-
保证数据的可见性
#define wmb() asm volatile("sfence" ::: "memory")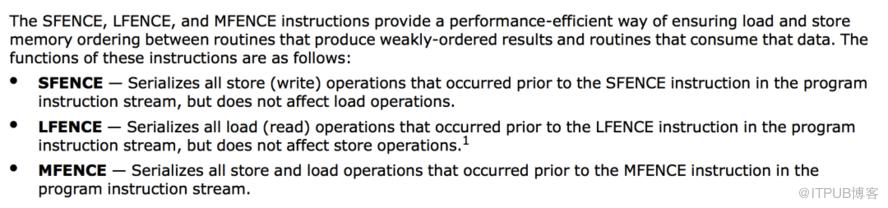
Intel® 64 and IA-32 Architectures Software Developer’s Manual
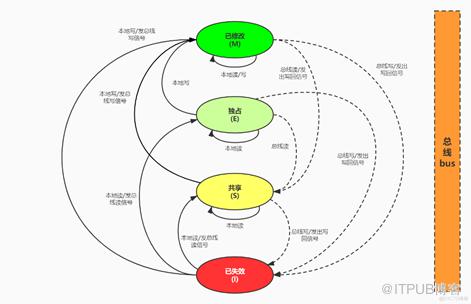
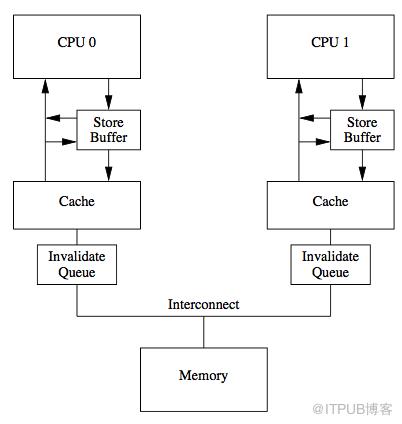
所以CPU通过Store Buffer和Invalidate Queue组件来降低这类操作的延时。详细可以参考:Intel® 64 and IA-32 Architectures Software Developer’s Manual。
加锁当然也可以解决问题,大部分同学第一时间想到的解决方案,比如自旋锁或者RCU锁(读不需要加锁),自旋锁让其他CPU不能并发操作(串行操作)这个链表,这样也可以规避这个问题。但是加锁代价通常要比内存屏障要大(自旋锁会锁总线或者缓存),而RCU链表底层也是加内存屏障实现的,链表操作在内核里面属于高频操作,内存屏障已经可以保证其正确性,内核都会尽量采用代价最小的方案来保证其正确性和高性能。
中断处理有什么特殊地方吗?
这里书中说的执行两行代码之间插入一个中断,CPU会优先处理中断,如果中断程序也访问这个链表,此刻如果之前是乱序执行(没有加内存屏障),链表就是破坏的,中断程序可能就会执行异常,很多人可能说能否加一个中断锁(屏蔽中断),加中断锁可能是可以的,防止中断抢占并发,但这个代价太大(如果中断比较频繁,会导致中断丢失),如果要加其他锁,中断上下文还不能用阻塞锁,自旋锁是可以在中断上下文的使用的。
这里可以使用无锁操作吗?
无锁操作(原子操作)通常不会导致任务阻塞,底层采用CPU的CAS指令,CAS指令要么锁总线要么锁缓存,但内存屏障并没有新增指令,只是不让CPU乱序执行,通常情况下,代价更小一些。
加锁一定比内存屏障更差吗?
有同学就有这个疑问,上面都说的通常情况,有没有加锁性能比内存屏障要好的情况,我想应该是有这种场景的。内存屏障导致CPU不能乱序执行,就看乱序带来收益和加锁的消耗谁更大,这个是需要看具体例子的,就上面两行代码例子,内存屏障更好。
最后,这个问题很意思, 涉及处理器体系架构 ,编译器优化 ,内存屏障,操作系统实现和CPU实现,cache一致性实现和优化,多核并发原理,中断执行原理,锁原理等等,大家可以检验一下自己,是否需要查缺补漏,认认真真解决一个好问题可能比随便解决100个问题更有大收获,成长更快。
上面很多东西在之前深入理解并发技术有分享过:
10.24 欢迎加入极客星球,修炼自己,每天进步一点点,厚积薄发:
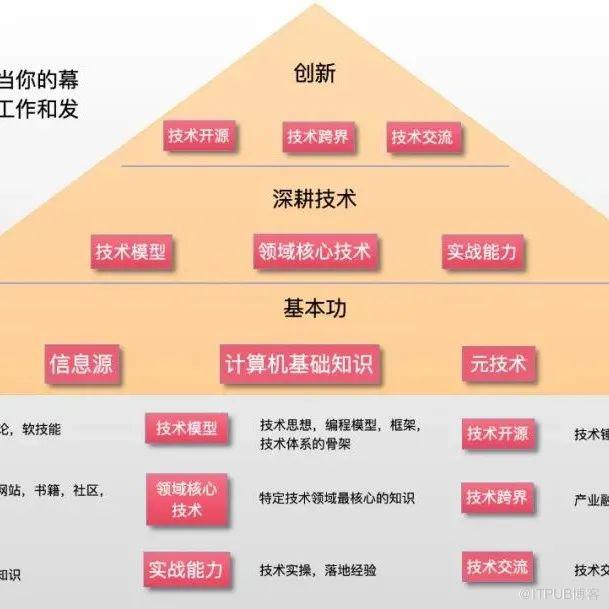
修炼基本功,打好高薪基础:分享基础技术(CS基础)深度理解,基础概念深度解析,经典书籍推荐和读书分享,经典源码阅读分享,分享经典问题,不定期直播分享;
扩展技术深度和技术视野:分享当前热门技术理解,主流技术发展情况,国内外大厂技术内幕,业界技术方案思考和落地经验等等;
校招/社招就业指导:模拟面试,简历修改,面试题分析,学习路线就业指导,面试指导等;
职场普升/升级技术专家:分享宝贵的职场普升经验,技术方向选择,各种类型公司的工作经验,优秀员工经验,技术专家成长经验,让你少走一些弯路;
专属交流群:共享技术理解心得,共享成长经历,如何解决成长困难,学习问题讨论,技术学习心得交流;
10.24大额优惠劵放送,大家可以扫码可以加入。

定个目标|建立自己的技术知识体系
大厂后台开发基本功修炼路线和经典资料
难走的路,从不拥挤

原文作者:极客重生;如有侵权,请联系管理员删除。

