这两天在极客星球群分享了一篇仲夏的梦幻17对阿里云最近大故障一些思考,大家讨论比较激烈,文章角度比较刁钻,不管这样,能激发大家思考,值得探讨一下。
先看文章原文:
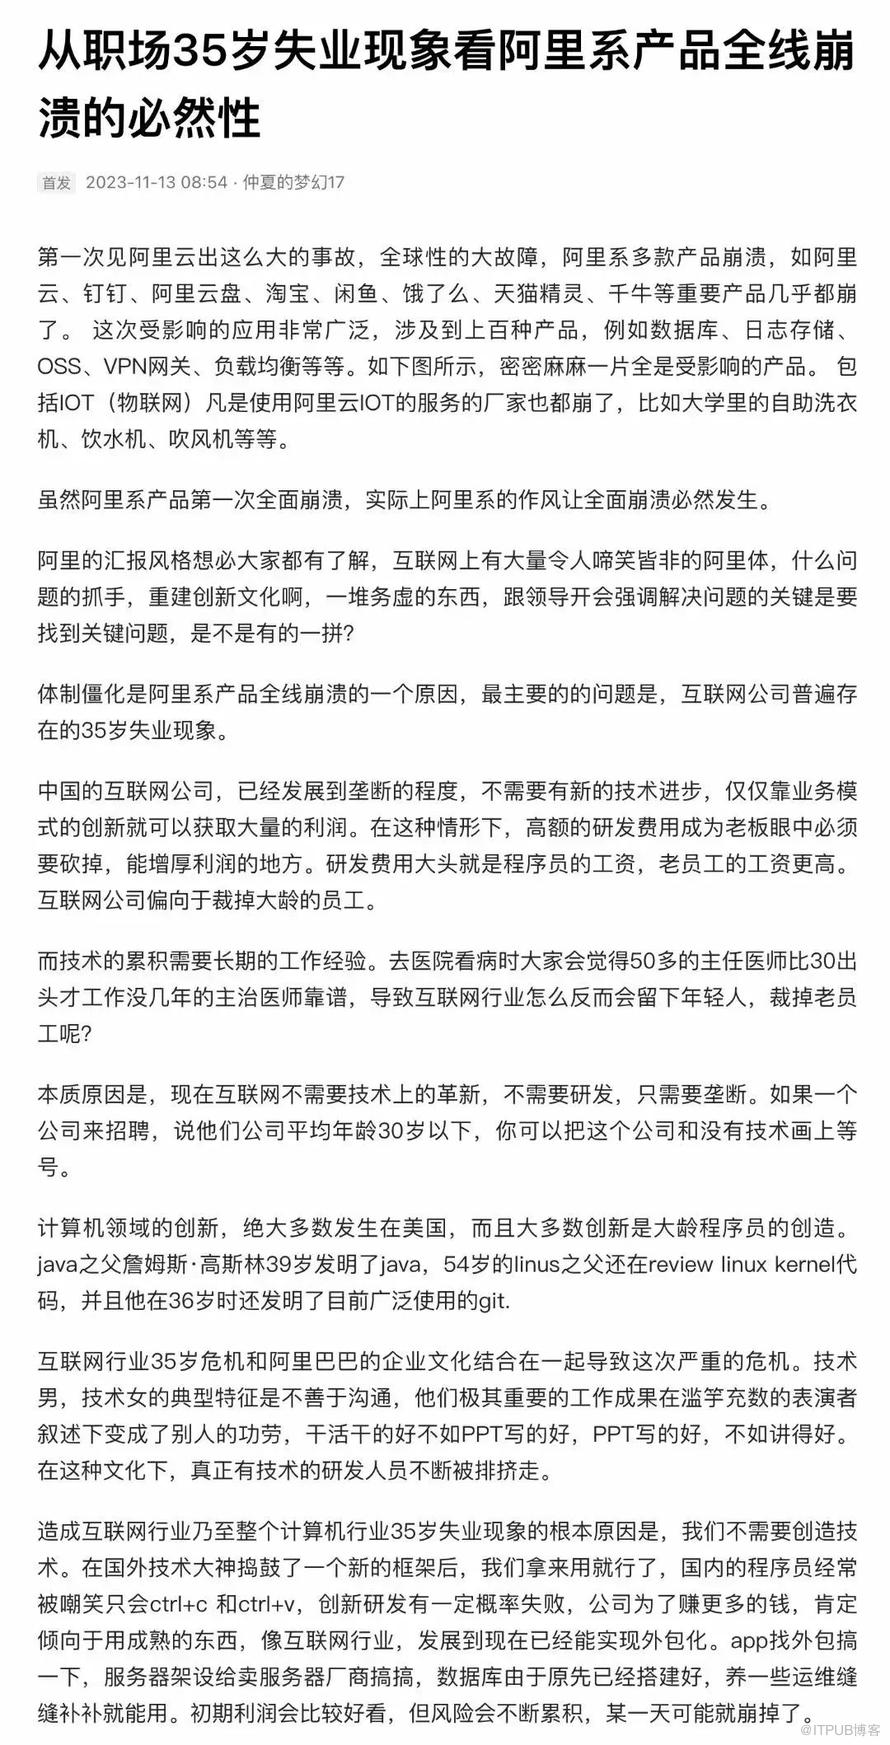
我理解作者想表达核心观点,国内大公司确实存在不太注重技术长期积累现象,因为当初那个风口钱太好挣,看着别人在地上疯狂捡钱,你还还能静下心慢慢发展吗?导致大家都不愿意沉下心做更长期的事情, 就有点像当初随随便便一个网红收入几十万~几千万,普通人的你还能安心读书考大学找工作挣钱吗? 公司也是人组成的,都一样,但这种现象现在已经开始有转变了,红利是短期的,当前红利不在,要想长期发展下去,就必须要注重核心技术突破,技术才是公司的核心竞争力(不被卡脖子)。
就单从此次事故来讲,当云的盘子大了,业务都是海量业务,每个组件都是“成千上万"台服务器集群,组件之间由于历史原因可能存在错综复杂的关系,导致产品的整体系统是非常复杂的,如果前期没有做好长期设计,其系统是非常脆弱的,任何一个组件变动(变更操作),都有产生故障的可能(蝴蝶效应),不稳定性越积越多,每天都如覆薄冰,加之人员变动,这个系统风险性太大,常住河边走,哪有不湿鞋,如果底盘不稳,那故障便是家常便饭,不仅阿里会这样,国内外大公司都出现过大故障,只是次数多少而已,大部分大厂都想出各种办法来控制系统的复杂性,降低系统性风险,尽量减少故障出现的机会和降低故障的影响面。
我们必须承认人类的技术水平还是在初级阶段,我们很难开发出没有bug的软件,就连linux内核,这种世界TOP级重要的软件,都有一堆bug,不光是软件,硬件也会出现故障,比如磁盘,CPU(芯片),内存,显卡,网卡,主板等等都可能出现异常,成千上万硬件,基本上大厂的数据中心每天都有硬件故障出现,同时人也是故障源,很多操作都是人工操作导致的,这些成千上万的软件,硬件,人,工具组成的系统,随着时间推移,风险会越来越大,而大部分大公司都在极限拉扯:一边上线各种新业务,想占领更多市场,这样才能挣更多钱,推动公司股价上升,但这种行为又会导致系统变更频繁,开发新业务也会增加存量系统的复杂性,这些都会加大系统风险;一边又会重构系统,提前减少已知的系统风险,但这些都是有代价,高可用也是,系统那么多组件,不可能每个都能保证高可用,这样代价太大,公司是承担不起的,所以只能取舍,才有各种trade-off一说,说不一定某天一个不起眼小组件就会引发下一场血案。所以要保证一个复杂系统不出故障是相当困难的,甚至可以说是不可能的任务(在目前科技技术水平下)。
最后,想要减少故障,公司就得做长期规划和投入,需要雇佣更多有经验的程序员来设计或者重构系统,减少系统的混乱度,让系统的复杂性可控,提升系统稳定性,这个也是未来大厂发展趋势(当前招聘要求越来越高),有经验有能力程序员会越来越吃香,互联网也会回归到正确的道路上来。
看完上面这些思考,大家是否可以理性得看待阿里云这次故障事件,从中可以学到什么呢? 如果你是老板,你怎么解决这个问题?
欢迎加入极客星球,加深技术深度理解和提高工作认知视野,帮助大家快速成长:
修炼基本功(大厂招聘基础):分享多年基础技术深度理解,基础概念深度解析,经典书籍推荐和读书分享,经典源码阅读分享等,不定期直播分享和答疑解惑;
扩展技术和商业视野:分享热门技术发展,国内外大厂技术内幕,业界解决方案;
校招/社招免费就业指导:模拟面试,简历修改,面试题分析,学习路线就业指导,面试高薪工作指导等;
职场普升/技术专家:分享各种不同公司宝贵的职场普升经验,技术方向选择, 大厂普升经验,技术专家成长经验,让你少走几年的弯路;
-
专属高质量交流群:技术趋势,技术热点,分享学习心得,技术学习讨论,交流,每天成长一点,厚积薄发;
深入理解系列: 深入理解计算机系统
深入理解操作系统(调度,内存,网络,IO)
深入理解并发技术全景指南
深入理解编程语言
深入理解算法与数据结构
深入理解网络协议
深入理解网络编程
深入理解性能优化
深入理解分布式技术
深入理解数据库
深入理解代码设计
深入理解架构设计
详细了解:极客星球 ,现在加入超级优惠,早点加入一起学习成长,早点突破成长瓶颈:

扫码加入,加我微信:fr35331508,拉你进极客星球群。一点一点积累,厚积薄发!
求点赞关注,在看,分享三连
原文作者:极客重生;如有侵权,请联系管理员删除。

