▼最近直播超级多,预约保你有收获
近期直播:《基于 LLM 大模型的向量数据库企业级应用实践》
1—
LangChain 是什么?
支持多种模型接口调用:OpenAI、Hugging Face、AzureOpenAI ... 支持多种方式实现缓存记录:In-Mem(内存)、SQLite、Redis、SQL ... 支持流模式(类型打字机的效果)
支持多种自定义模板
支持文档切割 支持 token 向量化 支持向量数据库
链允许我们将多个组件组合在一起,以创建一个单一的、连贯的应用程序。比如:我们可以创建一个链,该链接受用户输入,使用提示模板对其进行格式化,然后将格式化的响应传递给 LLM。
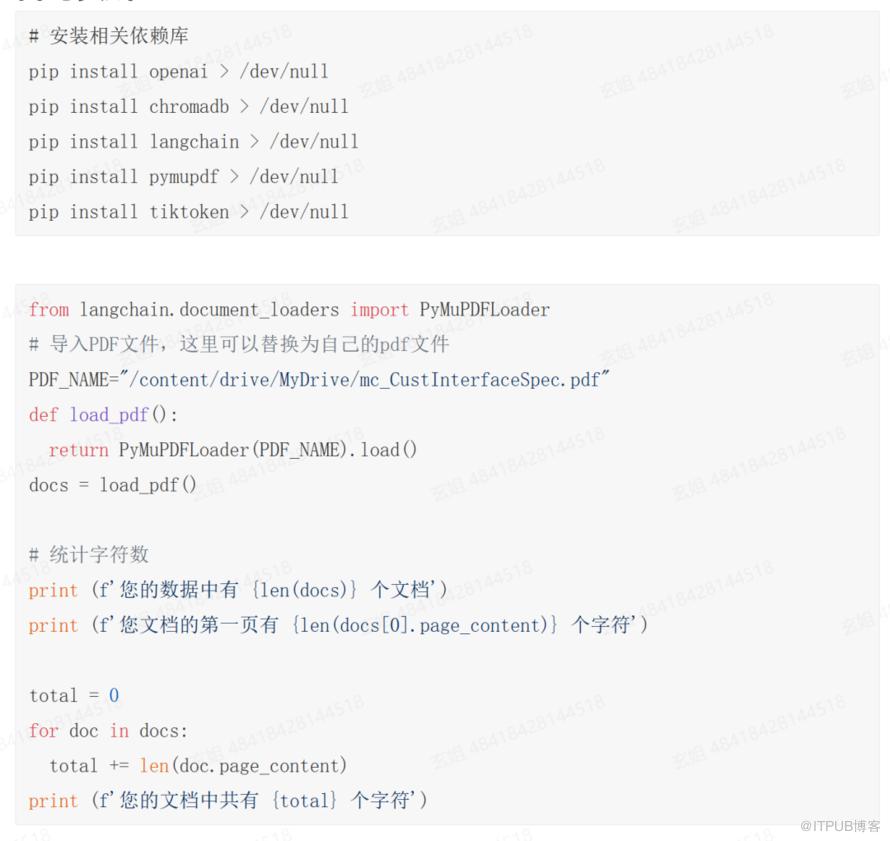
顾名思义,这个就是从指定源进行加载数据的, 比如:
文件夹 DirectoryLoader
Azure 存储 AzureBlobStorageContainerLoader
CSV文件 CSVLoader
印象笔记 EverNoteLoader
Google网盘 GoogleDriveLoader
任意的网页 UnstructuredHTMLLoader
PDF PyPDFLoader
S3 S3DirectoryLoader/S3FileLoader
Youtube YoutubeLoader 等官方文档地址:https://python.langchain.com/en/latest/modules/indexes/document_loaders.html
代码实践如下:
— 2 —
文本切割(Text Splitters)
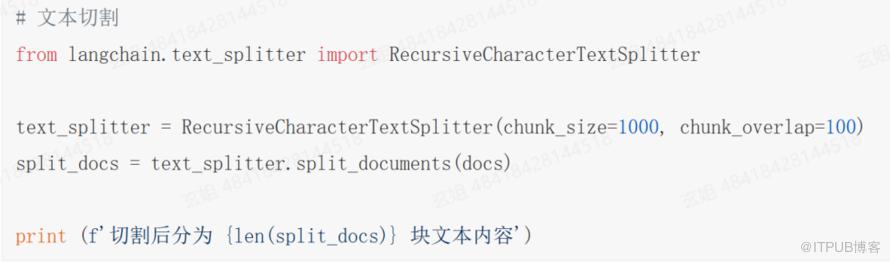
当您想要处理长文本时,有必要将该文本拆分为块。听起来很简单,但这里有很多潜在的复杂性。在理想情况下,我们希望将语义相关的文本片段放在一起。“语义相关”的含义可能取决于文本的类型。文本切割器的工作方式:
将文本拆分为语义有意义的小块(通常是句子) 开始将这些小块组合成一个较大的块,直到达到一定的大小(由某个函数测量) 达到一定大小后,将该块设置为自己的文本段,然后开始创建一个具有一些重叠的新文本块(以保持块之间的上下文)
—3 —
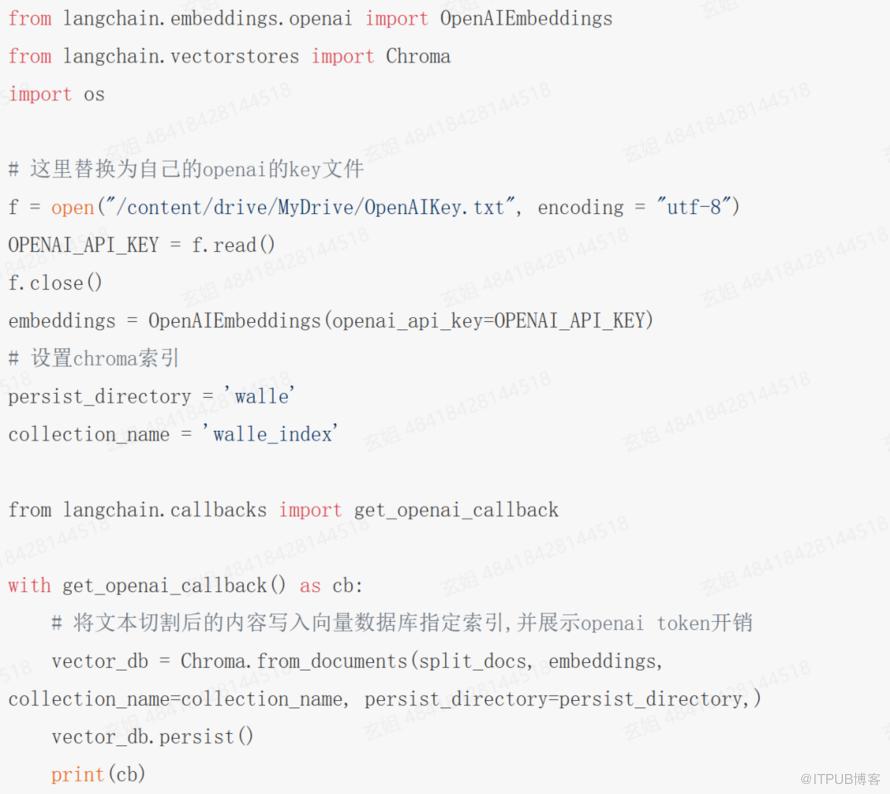
向量化(向量数据库)
Chroma(开源本地文件向量数据库) Milvus(开源分布式高性能数据库) Pinecone(商业化分布式高性能数据库)
— 4 —
链(Chain)
LLMChain(适用于各种 LLM 链) load_qa_chain( QA 问答) ConversationalRetrievalChain(使用聊天记录在文档上进行聊天)
— 5—
免费超干货 LLM 大模型直播
为了帮助同学们掌握好 LLM 大模型的向量数据库企业级应用实战,明晚8点,我和陈东老师会开一场直播和同学们深度聊聊大模型的向量化、向量数据库的应用实战,请同学点击下方按钮预约直播,咱们明晚8点不见不散哦~~
END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

