▼最近直播超级多,预约保你有收获
今晚直播:《向量数据库应用案例实战》
—1—
Self Attention 自注意力机制剖析
这种 Embedding 嵌入是我们提供给大模型的输入。
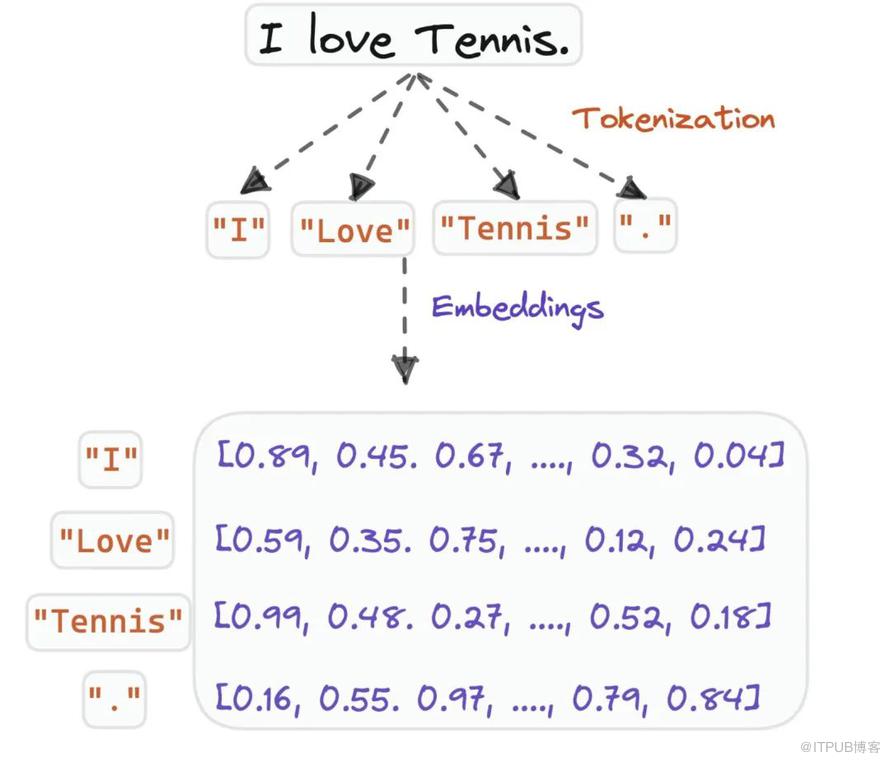
大模型预训练的核心思想是理解语言内部的结构和模式。通过学习句子中单词(Token)之间的关系,大模型可以捕捉到文本的上下文和含义。
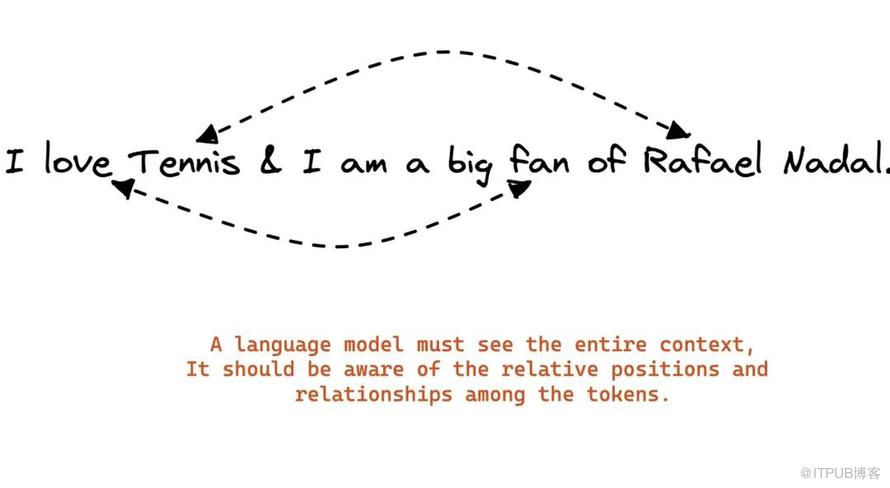
那么自注意力是一种沟通机制,帮助建立这些关系,以概率分数表示。
每个 Token 都给自己分配最高分,并根据其他 Tokens 的相关性分配额外分数。
你可以把它想象成一个有向图,如下:
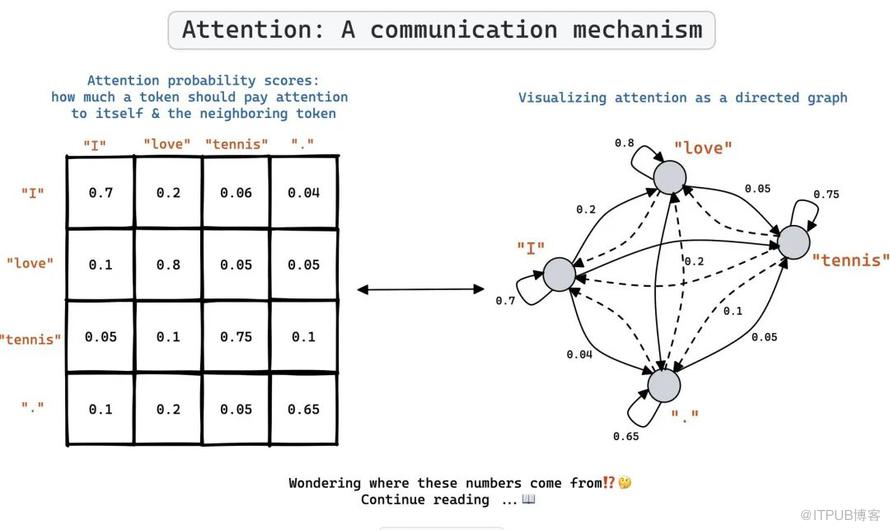
要理解这些概率/注意力分数是如何获得的:我们必须理解3个关键术语:
- 查询向量(Query Vector)
- 键向量(Key Vector)
- 值向量(Value Vector)
这些向量是通过将输入嵌入乘以三个可训练的权重矩阵来创建的。
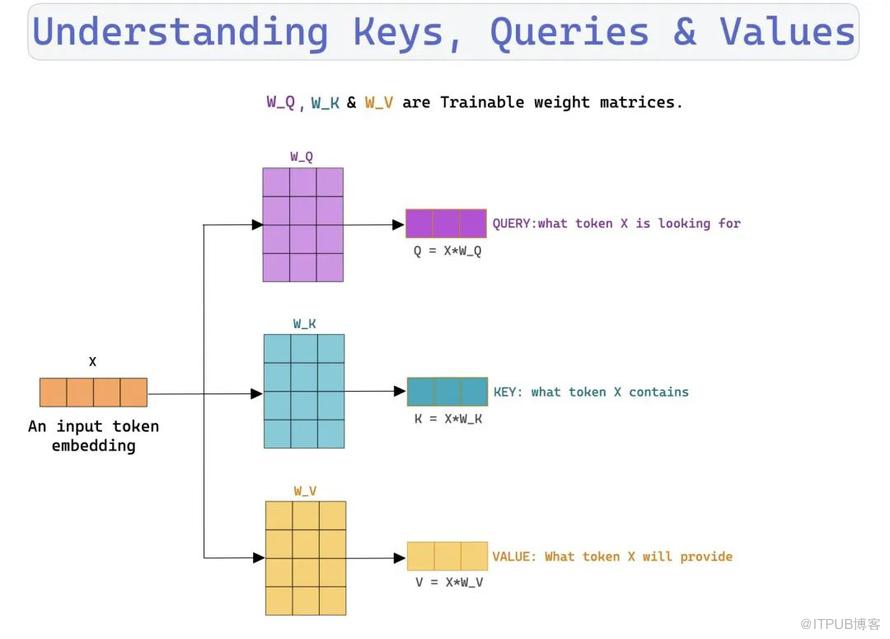
在获取键、查询和值之后,我们将它们合并以创建一组新的、有上下文感知的嵌入。
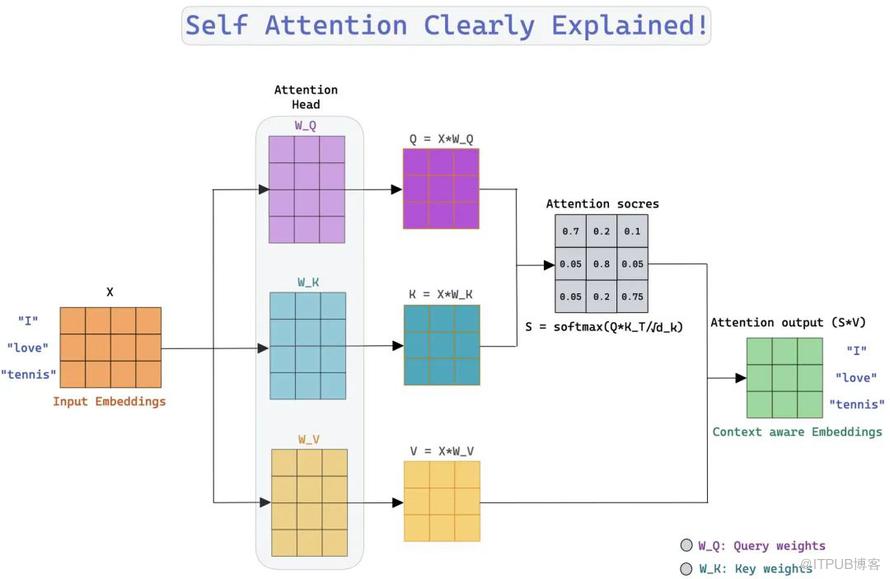
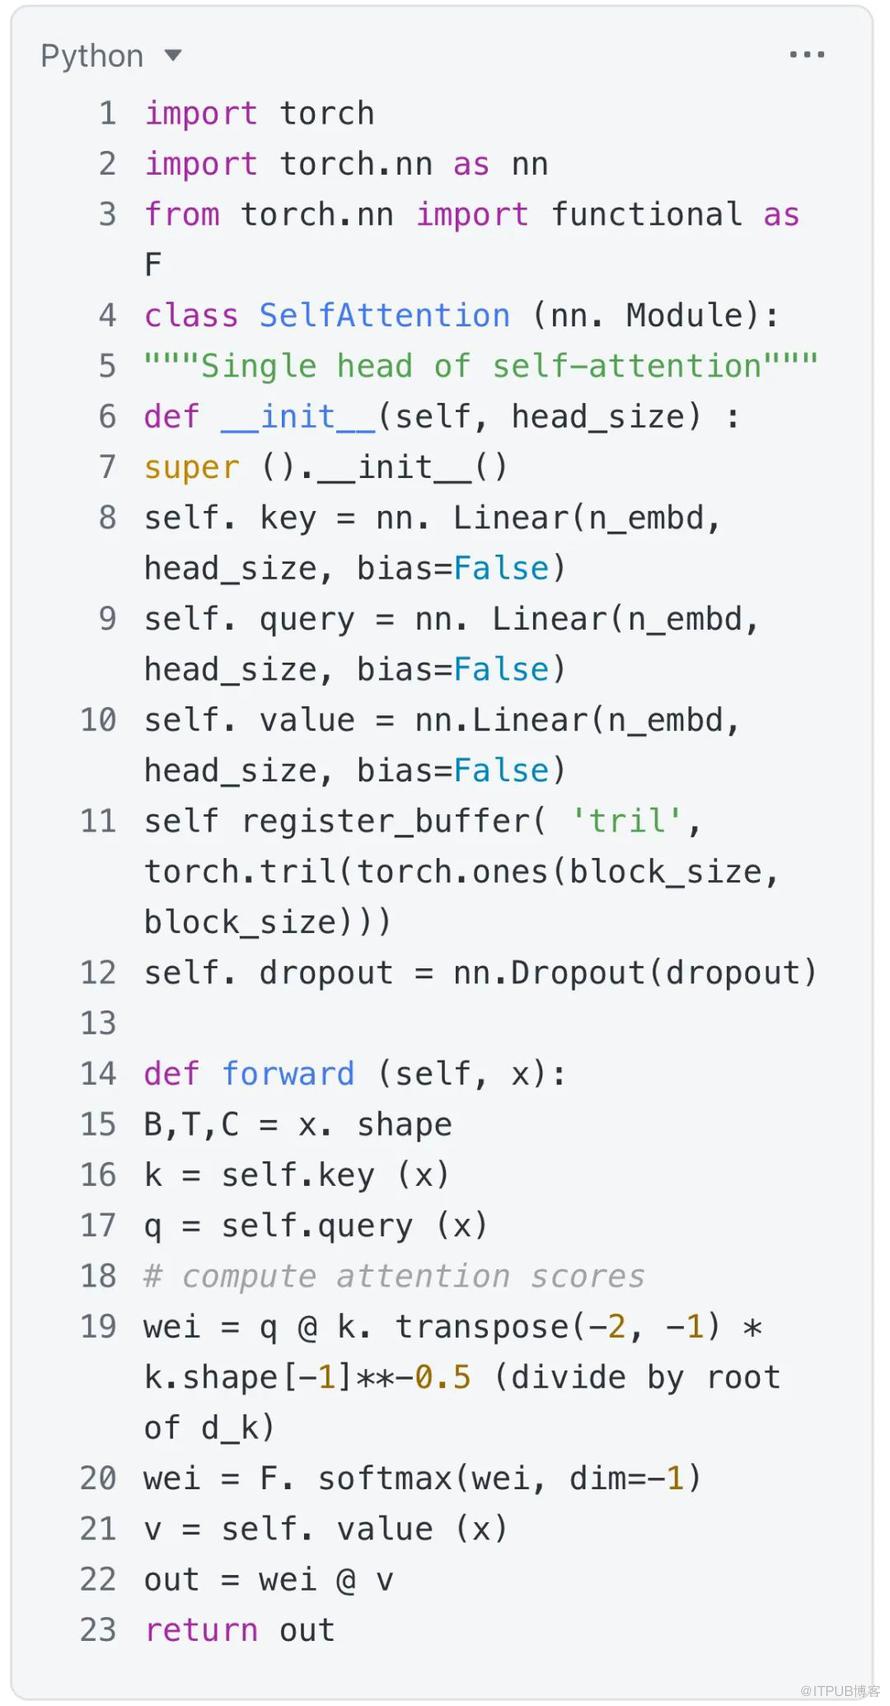
以下 PyTorch 实现自注意力机制,非常简单和直观。
—2—
新年领取《AI 大模型技术知识图谱》
END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
