▼最近直播超级多,预约保你有收获
今天直播:《ChatGLM3架构设计案例实践》
—1—
最强开源大模型 Gemma
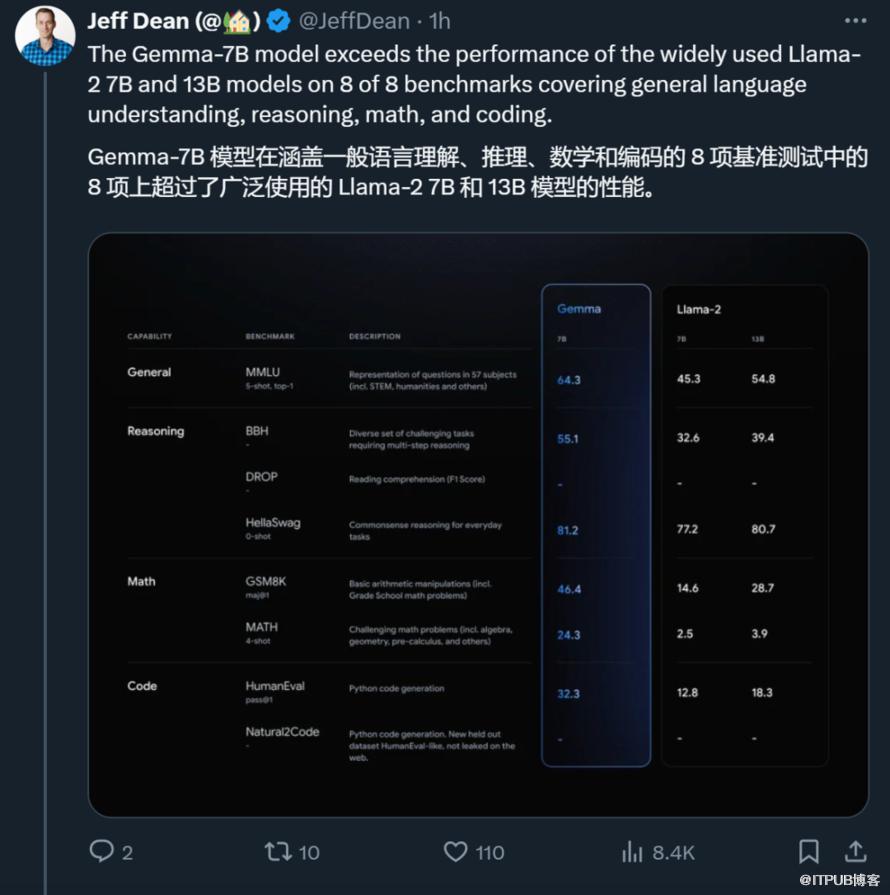
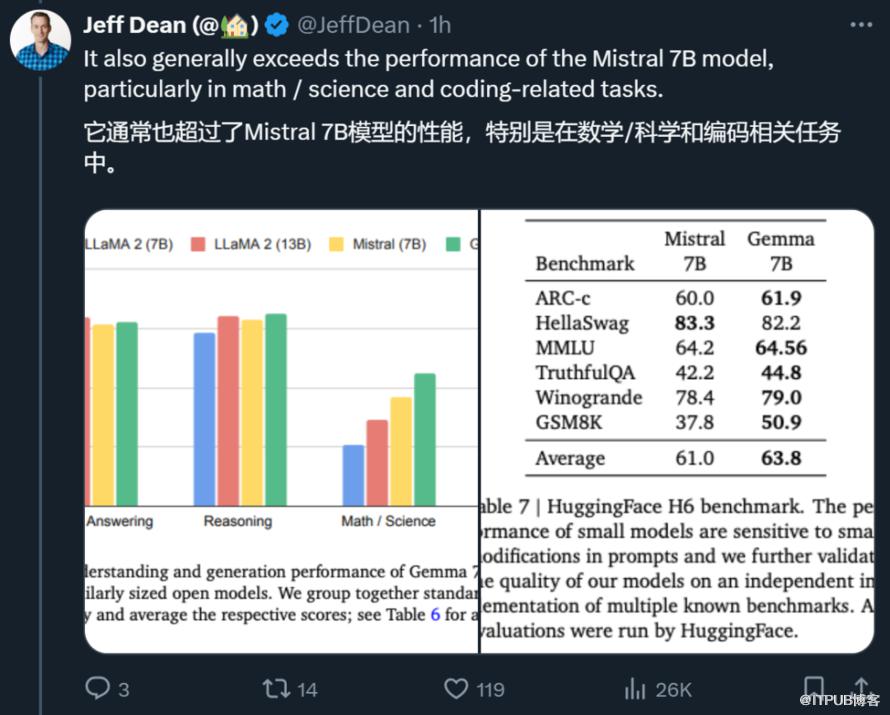
而且 Gemma「能够直接在开发人员的笔记本电脑或台式电脑上运行」。除了轻量级模型之外,谷歌还推出了鼓励协作的工具以及负责任地使用这些模型的指南。
—2—
Gemma 技术细节
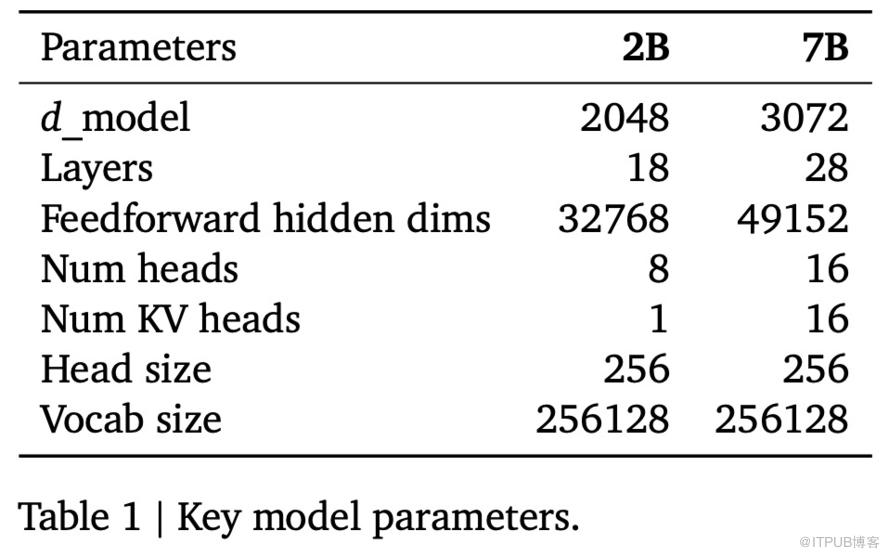
Gemma 模型架构基于 Transformer 解码器,表 1 总结了该架构的核心参数。模型训练的上下文长度为 8192 个 token。
此外,谷歌还在原始 transformer 论文的基础上进行了改进,改进的部分包括:
多查询注意力:7B 模型使用多头注意力,而 2B 检查点使用多查询注意力;
RoPE 嵌入:Gemma 在每一层中使用旋转位置嵌入,而不是使用绝对位置嵌入;此外,Gemma 还在输入和输出之间共享嵌入,以减少模型大小;
GeGLU 激活:标准 ReLU 非线性被 GeGLU 激活函数取代;
-
Normalizer Location:Gemma 对每个 transformer 子层的输入和输出进行归一化,这与仅对其中一个或另一个进行归一化的标准做法有所不同,RMSNorm 作为归一化层。
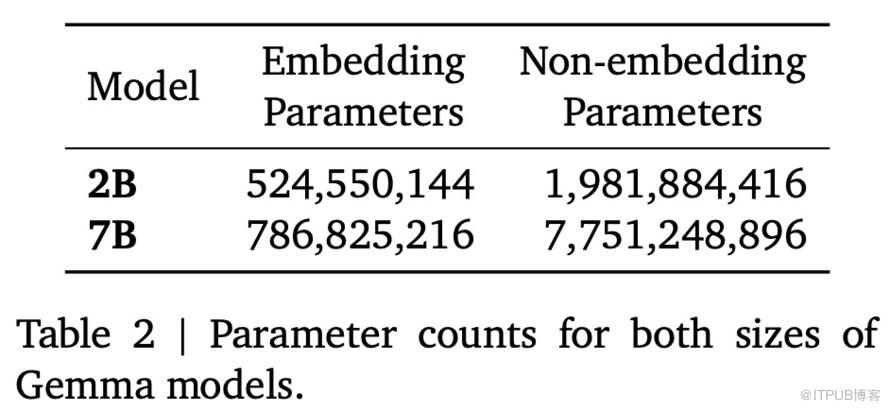
2、预训练
Gemma 2B 和 7B 分别在来自网络文档、数学和代码的 2T 和 6T 主要英语数据上进行训练。与 Gemini 不同的是,这些模型不是多模态的,也不是为了在多语言任务中获得最先进的性能而训练的。
为了兼容,谷歌使用了 Gemini 的 SentencePiece tokenizer 子集(Kudo 和 Richardson,2018 年)。它可以分割数字,不删除多余的空白,并遵循(Chowdhery 等人,2022 年)和(Gemini 团队,2023 年)所使用的技术,对未知 token 进行字节级编码。词汇量为 256k 个 token。
3、指令调优
谷歌通过在仅文本、仅英语合成和人类生成的 prompt 响应对的混合数据上进行监督微调(SFT),以及利用在仅英语标记的偏好数据和基于一系列高质量 prompt 的策略上训练的奖励模型进行人类反馈强化学习(RLHF),对 Gemma 2B 和 Gemma 7B 模型进行微调。
实验发现,监督微调和 RLHF 这两个阶段对于提高下游自动评估和模型输出的人类偏好评估性能都非常重要。
4、监督微调
谷歌根据基于 LM 的并行评估结果来选择自己的混合数据,以进行监督微调。给定一组留出的(heldout) prompt, 谷歌从测试模型中生成响应,并从基线模型中生成相同 prompt 的响应,并要求规模更大的高性能模型来表达这两个响应之间的偏好。
谷歌还构建不同的 prompt 集来突出特定的能力,例如指令遵循、真实性、创造性和安全性等。谷歌使用了不同的自动化 LM「judges」,它们采用了多种技术,比如思维链提示(chain-of-thought prompting)、对齐人类偏好等。
5、人类反馈强化学习(RLHF)
谷歌使用 RLHF 对监督微调模型进一步微调,不仅从人类评分者那里收集了偏好对,还在 Bradley-Terry 模型下训练了奖励函数,这类似于 Gemini。该策略经过训练,使用一个具有针对初始调优模型的 Kullback–Leibler 正则化项的 REINFORCE 变体,对该奖励函数进行优化。
与监督微调(SFT)阶段一样,为了进行超参数调优,并额外减轻奖励黑客行为,谷歌依赖高容量模型作为自动评估器,并计算与基线模型的比较结果。
参考链接:https://mp.weixin.qq.com/s/_iCYfqmXA3enKn3Hm-DwSA
新年领取《AI 大模型技术知识图谱》

END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

