▼最近直播超级多,预约保你有收获
今天直播:《大模型Agent应用落地实战》
—1—
Sora 技术原理解读
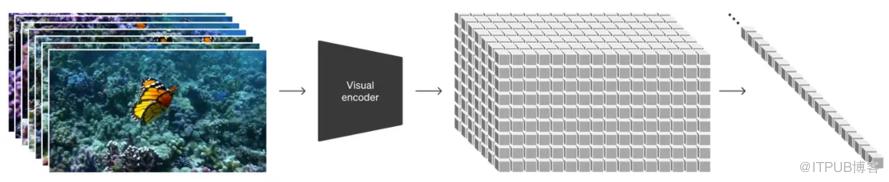
如果用一句话来描述 Sora 训练建模过程,那就是:将原始视频通过一个视觉编码器(visual encoder)编码到隐空间(latent space)形成隐时空块(spacetime latent patches),这些隐时空块(结合 text 信息)通过 transformer 做 diffusion 的训练和生成,将生成的隐时空块再通过视觉解码器(visual decoder)解码到像素空间(pixel space)。
整个过程如下:visual encoding -> latent diffusion with diffusion transformer (DiT) -> visual decoding。
—2—
Sora 算不算世界模型?
世界模型分为广义的和狭义的。
广义的世界模型,就是任何能理解世界潜在物理规律的模型,比如可以预见未来结果的模型,比如:如果一个模型能预测玻璃杯掉下后的状态,说明该模型具备这样的能力;再比如:知道世界中实体或抽象概念之间相互联系的模型,比如:一个模型知道玻璃杯的硬度低于水泥地会导致玻璃破碎。
狭义的世界模型,更强调理解物理世界的动力(dynamics)或者运动等物理规律的模型,了解过强化学习的朋友们一定特别熟悉这些。在强化学习中,一大分支便是 model-based RL,这里的 model,其实就是典型的狭义世界模型。在此模型中,给定某一时刻的状态 s_t 和该时刻做的动作 a_t,模型可以预测出下一个时刻的状态 s_t+1。所以说,狭义的世界模型其实是因果的。回到上面的例子,s_t 可以是刚下落的杯子和干净的水泥地,a_t 则是自由落体这个动作,s_t+1 则是水泥地上碎掉的杯子这样一个状态。
Sora 算广义世界模型,同时也是隐式的狭义世界模型。
—3—
Sora 成功的关键
大规模训练:大力出奇迹,这点毋庸置疑。大模型、大数据量、使用大规模算力,OpenAI 基本操作。 敢于突破常规、不屑于刷点:之前工作基本都采用 SD 预训练的 visual encoder,也知道该 encoder 多少有点不合理(比如只能处理固定size的输入),但没有人真的去重新训练一个更合理的 encoder(当然,更可能是算力不支持)。而 OpenA I发现问题,就用算力来解决问题(大概率重新训练visual encoder)。 实事求是 + 绝对领先的 sense:自回归的建模方式在 LLM 中大获成功,GPT 系列也出自 OpenAI,但这不代表 “Autoregressive is everything”,Sora 告诉大家,生成视频无需采用自回归,直接 3D 建模+ transformer encoder 结构就ok。 -
AGI 理念从上至下传播:Sam Altman 绝对是一个有大格局的人物,其最终目标是实现 AGI,我想整个 OpenAI 应该都会贯彻这样的理念,不管是 ChatGPT 还是 Sora,都能看到 AGI 的影子。
领取《AI 大模型技术直播》


END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

