▼最近直播超级多,预约保你有收获
—1—
大模型知识库架构设计

以上架构本质上解决两大核心问题:如何突破传统 tokens 数量的限制,以及如何更精准地提炼出问题的本质。
📏 Text Splitter:将长文本分解为易于管理的小段或碎片的算法。它的目标是将文本分解成可单独处理的小块,这在处理庞大的文档或数据集时尤为重要。
🔬 Embedding:这个过程可以简单理解为数据的向量化。无论是哪种维度的数据,最终都需要通过归一化和自关联的步骤来转化为向量。目前 ChatGPT 的 text-embedding-ada-002 模型表现尤为突出。实际上,ChatGPT 之所以能在众多大模型中脱颖而出,很大程度上得益于其卓越的 Embedding 结果。
💾 VectorStore:存放那些已经向量化数据的向量数据库。市面上许多向量数据库都能够胜任这项工作,比如:Milvus、Pinecone、腾讯云向量数据库、Redis 等,它们不仅能够存储数据,还能支持语义计算,比如:欧式距离、余弦公式等操作。
知识库架构原理很简单,如果知识库库使用用户数少,比如:公司内部员工使用,在一些基础问题上,它还能回答的差不多,但是在复杂问题上,还没有看到一个非常厉害的知识库出现!
—2—
大模型知识库的落地困境
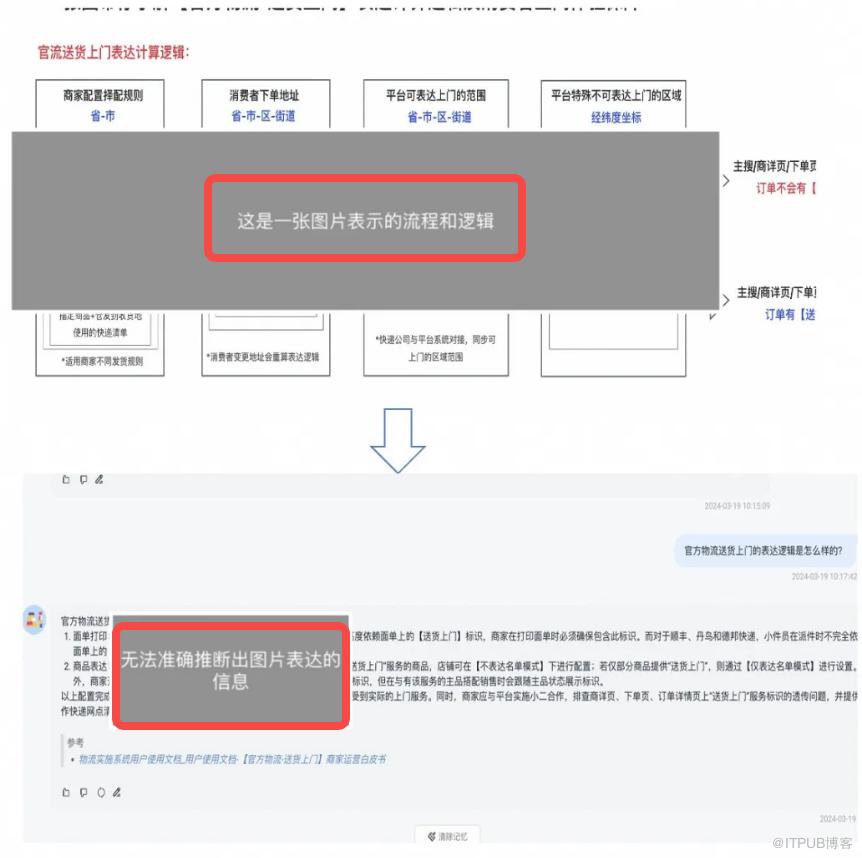
首先,我们面临的第一个挑战是:在进行文档向量化的过程中,文档中常常包含大量图片。这些图片在传递语义信息方面往往更为丰富。但在图片处理过程中,它们可能仅仅被转换成一个简单的链接。更有甚者,一些文档还包含视频内容,这进一步增加了处理的复杂性。
因此,文档处理不能仅仅依赖传统的自然语言处理(NLP)技术,还需要能够支持多模态信息的整合和分析。目前,似乎还没有看到哪个系统能够完全实现这样的能力。正如下图所示,它就是一个典型的例子。
其次,我们面临的第二个挑战是:影响结果的就是文档的大小,如果知识库过于庞大,在分割完成后,召回的数据也会过多,必然存在舍弃导致的信息不全。不过这种情况可以通过尝试多路调用,再整合的思路解决。
再次,如果提出的问题区分度不高,得到的答案可能会过于笼统。知识库的核心优势在于提供的信息必须是准确和有用的。用户并非专家,无法辨别每次得到的信息是否正确,因此,如果知识库时而提供有用信息,时而给出错误信息,用户可能会选择不再使用。这与专家使用助手的方式存在本质区别。
为了帮助同学们彻底掌握大模型的知识库、 Agent 智能体、向量数据库、 RAG、知识图谱的应用开发、部署、生产化,今天我会开两场直播和同学们深度剖析,请同学们点击以下预约按钮免费预约。
—3—
!送!AI大模型开发直播课程
立即扫码,即可免费预约
进入直播,大佬直播在线答疑!
本期名额有限
高度起始于速度(手慢无!!)
—4—
!!再送!!《AI 大模型技术知识图谱》

第二步:扫码后,点击以下关注按钮,就可关注我。


—5—
精选福利《基于RAG实现代码知识库》
以下视频你将学到:
1、基于 RAG 实现代码知识库的流程设计
2、代码知识库的核心工程点剖析
END
原文作者:玄姐聊AGI;如有侵权,请联系管理员删除。

