在 Elasticsearch 中,未分配的分片(shards)可能会导致性能下降和数据不一致。
本文不仅介绍了常见的未分配分片原因及其解决方案,还给出每个步骤的详细 DSL 代码示例,确保初学者可以根据文档直接操作并执行成功。
1. 如何识别未分配的分片
使用 cat shards API 来查看集群中未分配的分片。
示例 DSL:
GET /_cat/shards?v&h=index,shard,prirep,state,unassigned.reason
输出示例:
index    shard prirep state        unassigned.reason
test     0     p      UNASSIGNED   NODE_LEFT
test     1     r      UNASSIGNED   REPLICA_ADDED
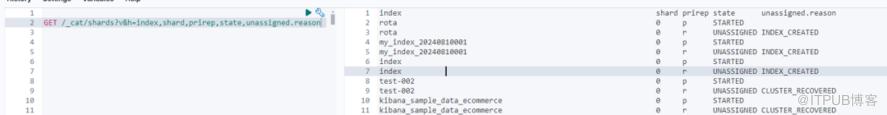
从输出(示例,非截图)中可以看到哪些分片处于 UNASSIGNED 状态,以及未分配的原因(如 NODE_LEFT 表示节点离开,REPLICA_ADDED 表示副本添加后未分配)。
2. 低磁盘水位导致未分配(Low Disk Watermark)
当节点磁盘空间不足时,分片不会分配给该节点。你可以检查每个节点的磁盘空间并调整磁盘水位阈值。
Elasticsearch 磁盘使用率超过警戒水位线,怎么办?
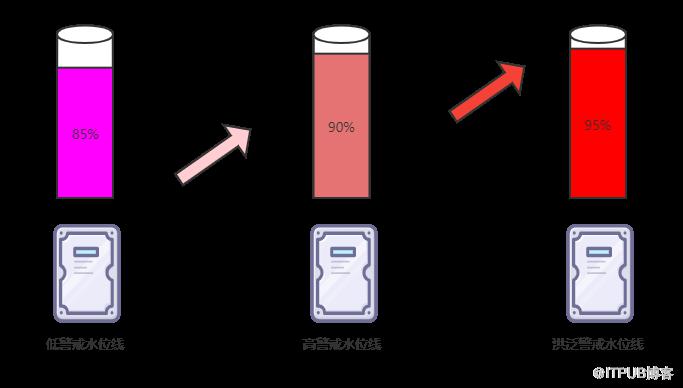
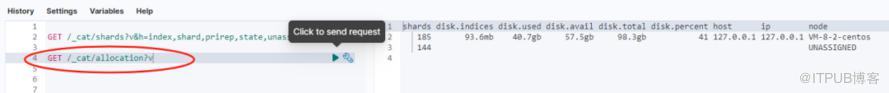
查看磁盘空间:
GET /_cat/allocation?v
调整磁盘水印阈值:如果发现磁盘空间不足,可以调整水位阈值。默认设置下,当磁盘使用率达到 85% 时将停止分配新的分片。
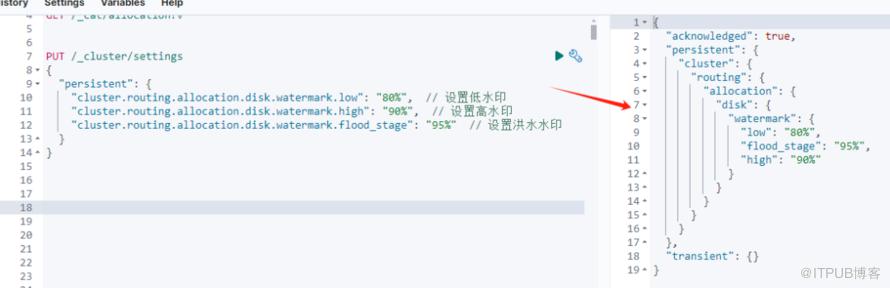
PUT /_cluster/settings
{
  "persistent": {
    "cluster.routing.allocation.disk.watermark.low": "80%",  // 设置低水印
    "cluster.routing.allocation.disk.watermark.high": "90%",  // 设置高水印
    "cluster.routing.allocation.disk.watermark.flood_stage": "95%"  // 设置洪水水印
  }
}
3. 分片过多,节点不足(Too Many Shards, Not Enough Nodes)
当分片数量过多、节点数量不足时,可以通过增加节点或减少副本数来解决。
查看分片状态:
GET /_cat/shards?v
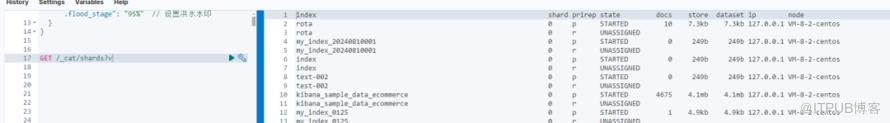
增加节点或减少副本数:
PUT /<index_name>/_settings
{
  "number_of_replicas": 1  // 将副本数减少为 1
}
4. 延迟分片分配(Shard Allocation Delay)
分片重新分配可能因节点离开集群时的暂时性延迟而发生。你可以通过调整 allocation_delay 来加快分片重新分配。
查看分片分配延迟:
GET /_cluster/settings
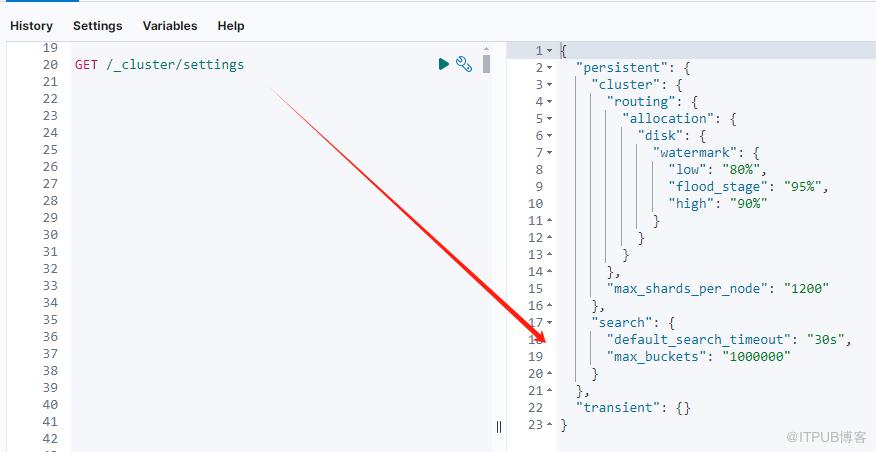
调整延迟时间:
PUT /_cluster/settings
{
  "persistent": {
    "cluster.routing.allocation.node_concurrent_recoveries": 2,  // 设置每个节点并发恢复的最大数量
    "cluster.routing.allocation.node_initial_primaries_recoveries": 4  // 设置每个节点并发的主分片恢复数
  }
}
5. 重新启用分片分配(Re-enabling Shard Allocation)
如果分片分配被禁用,可以使用以下命令重新启用。
查看分片分配状态:
GET /_cluster/settings
重新启用分片分配:
PUT /_cluster/settings
{
  "persistent": {
    "cluster.routing.allocation.enable": "all"  // 重新启用分片分配
  }
}
6. 分片数据丢失导致未分配(Shard Data No Longer Exists)
当分片数据丢失时,可能需要使用 Cluster Reroute API 强制分配分片并重新索引丢失的数据。
强制分配未分配的分片:
POST /_cluster/reroute
{
  "commands": [
    {
      "allocate_stale_primary": {
        "index": "<index_name>",
        "shard": 0,
        "node": "<node_name>",
        "accept_data_loss": true
      }
    }
  ]
}
重新索引丢失的数据:
如果需要重新索引,可以使用 Elasticsearch 的 Reindex API。
POST /_reindex
{
  "source": {
    "index": "<source_index>"
  },
  "dest": {
    "index": "<target_index>"
  }
}
7. Elasticsearch 版本不兼容(Multiple Elasticsearch Versions)
当集群中运行多个版本的 Elasticsearch 时,主分片的副本可能无法分配到旧版本的节点上。
Elastic 官方提供了版本兼容性矩阵,可以查阅具体的版本兼容性(如下图所示)。
https://www.elastic.co/cn/support/matrix#matrix_compatibility
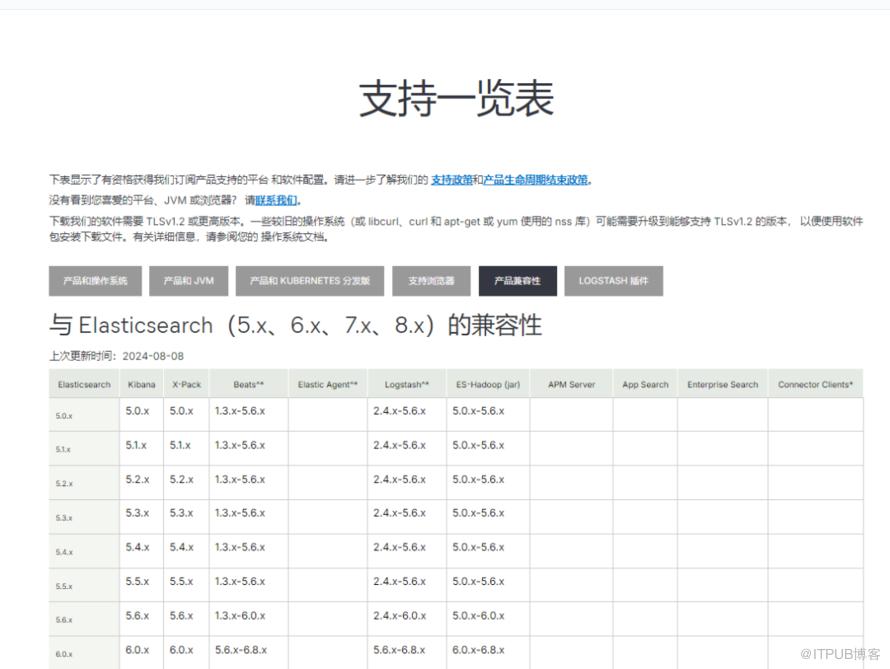
查看 Elasticsearch 版本:
GET /_cat/nodes?v&h=name,version
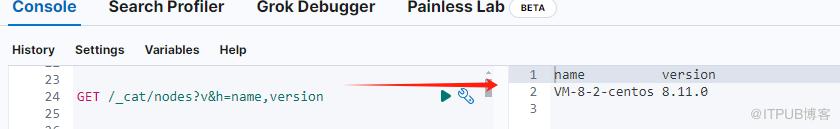
升级节点版本:
根据需要升级那些运行旧版本的 Elasticsearch 节点,以确保所有节点运行相同的版本。
8. 网络问题(Network Issues)
网络配置错误可能导致分片未能分配到某个节点。
检查网络配置:
GET /_cat/nodes?v

确保所有节点都正确连接到集群并处于健康状态。
9. 硬件故障(Hardware Failures)
检查节点硬件状态:
使用 /_cat/nodes 查看每个节点的 CPU 和内存使用情况:
GET /_cat/nodes?v&h=name,heap.percent,cpu,load_1m,disk.avail
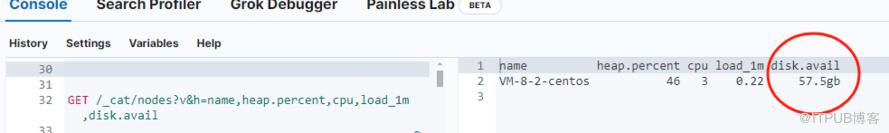
根据结果,修复硬件问题或增加更多的资源。
10. 索引损坏(Corrupted Indices)
如果分片所在的索引因磁盘故障或其他原因损坏,可能需要修复索引或从备份中恢复。
检查索引损坏情况:
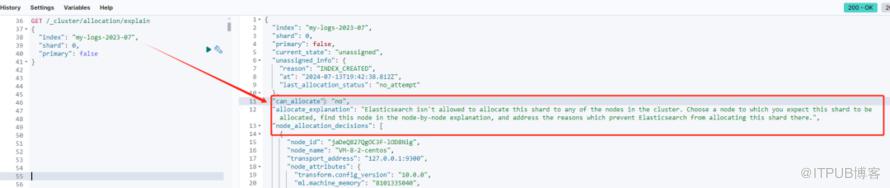
GET /_cluster/allocation/explain
{
  "index": "my-logs-2023-07",
  "shard": 0,
  "primary": false
}
 "deciders": [
        {
          "decider": "same_shard",
          "decision": "NO",
          "explanation": "a copy of this shard is already allocated to this node [[my-logs-2023-07][0], node[jaDeQ827QgOC3F-lOD8Nig], [P], s[STARTED], a[id=I-8--HrnQwW-08R469TaHQ], failed_attempts[0]]"
        }
      ]
    }
细看发现:
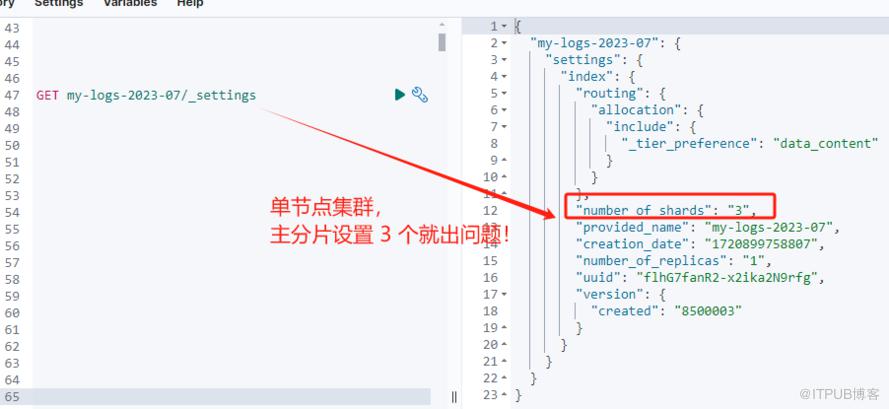
修复或恢复索引:
如果索引已损坏,可以通过删除索引并从备份中恢复数据。
DELETE /<index_name>
11. 结论
本文介绍了如何处理 Elasticsearch 集群中未分配的分片问题,并为每个场景提供了详细的 DSL 示例。通过正确识别问题并应用适当的解决方案,你可以保持 Elasticsearch 集群的健康和性能。
对于初学者,通过使用本文中的代码示例,可以快速解决未分配分片问题,确保集群正常运行。如果有更复杂的情况,可以参考 Elasticsearch 官方文档中的高级内容。
12. 参考文档:
https://www.elastic.co/guide/en/elasticsearch/reference/current/cluster-health.html
https://www.elastic.co/guide/en/elasticsearch/reference/current/cluster-update-settings.html
https://www.elastic.co/guide/en/elasticsearch/reference/current/cluster-reroute.html
https://www.elastic.co/guide/en/elasticsearch/reference/current/cat-shards.html
更多推荐

更短时间更快习得更多干货!
和全球超2000+ Elastic 爱好者一起精进!
elastic6.cn——ElasticStack进阶助手
原文作者:铭毅天下Elasticsearch;如有侵权,请联系管理员删除。

最新文章
- Elasticsearch 使用误区之六——富文本内容写入前不清洗
- 《一本书讲透 Elasticsearch》被清华、北大等多所知名高校图书馆收录
- 经验贴:终于,通过了 Elastic 官方认证考试!!!
- 直播回放:如何系统化的备战 Elastic 认证专家考试?
- Elasticsearch 完整格式的 URL 进行分词,有什么好的解决方案吗?
- Elasticsearch 使用误区之五——单次请求获取大量数据
- 深入解密 Elasticsearch 查询优化:巧用 Profile 工具/API 提升性能
- Elasticsearch 又更改开源协议了?为啥?对企业有什么影响?
- 探究:Elasticsearch 文档的 _id 是 Lucene 的 docid 吗?
- 道阻且长,行则将至——记累计跑步1000公里
