前言
文章会同步到个人网站,方便阅读:https://xiaoflyfish.cn/
网站最近丰富了很多内容,都是满满的干货!
微信搜索:月伴飞鱼,交个朋友,进面试交流群!
公众号后台回复666,可以获得免费电子书籍!
觉得不错,希望点赞,在看,转发支持一下,谢谢
背景介绍
在互联网的时代下,绝大部分数据都是通过网络来进行获取的。
在服务端的架构中,绝大部分数据也是通过网络来进行交互的。
而且作为服务端的开发工程师来说,都会进行一系列服务设计、开发以及能力开放,而服务能力开放也是需要通过网络来完成的,因此对网络编程以及网络IO模型都不会太陌生。
由于有很多优秀的框架(比如Netty、HSF、Dubbo、Thrift等)已经把底层网络IO给封装了,通过提供的API能力或者配置就能完成想要的服务能力开发,因此大部分工程师对网络IO模型的底层不够了解。
本文系统的讲解了Linux内核的IO模型、Java网络IO模型以及两者之间的关系!
什么是IO
我们都知道在Linux的世界,一切皆文件。
而文件就是一串二进制流,不管Socket、FIFO、管道还是终端,对我们来说,一切都是流。
在信息的交换过程中,我们都是对这些流进行数据收发操作,简称为I/O操作。
往流中读取数据,系统调用Read,写入数据,系统调用Write。
通常用户进程的一个完整的IO分为两个阶段:
磁盘IO:
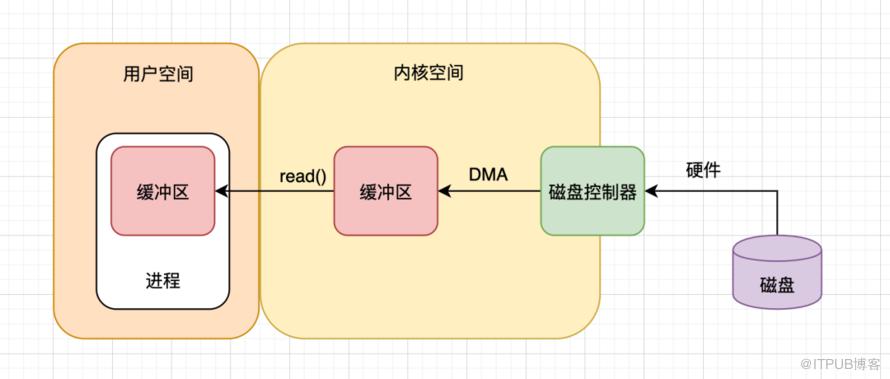
网络IO:

操作系统和驱动程序运行在内核空间,应用程序运行在用户空间,两者不能使用指针传递数据,因为Linux使用的虚拟内存机制,必须通过系统调用请求内核来完成IO动作。
IO有内存IO、网络IO和磁盘IO三种,通常我们说的IO指的是后两者!
为什么需要IO模型
如果使用同步的方式来通信的话,所有的操作都在一个线程内顺序执行完成,这么做缺点是很明显的:
因为同步的通信操作会阻塞同一个线程的其他任何操作,只有这个操作完成了之后,后续的操作才可以完成,所以出现了同步阻塞+多线程(每个Socket都创建一个线程对应),但是系统内线程数量是有限制的,同时线程切换很浪费时间,适合Socket少的情况。
因该需要出现IO模型。
Linux的IO模型
在描述Linux IO模型之前,我们先来了解一下Linux系统数据读取的过程:
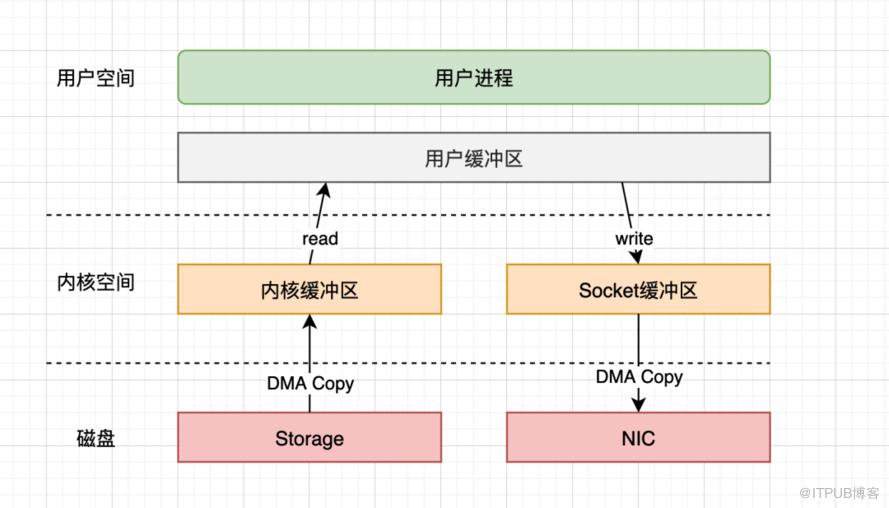
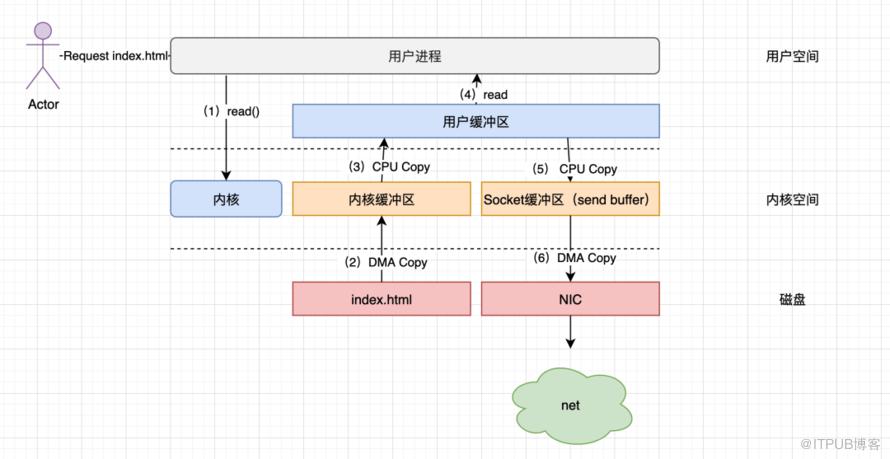
以用户请求index.html文件为例子说明
基本概念
用户空间和内核空间
操作系统的核心是内核,独立于普通的应用程序,可以访问受保护的内存空间,也有访问底层硬件设备的所有权限。
为了保证内核的安全,用户进程不能直接操作内核,操作系统将虚拟空间划分为两部分,一部分为内核空间,一部分为用户空间。
进程切换
为了控制进程的执行,内核必须有能力挂起正在CPU上运行的进程,并恢复以前挂起的某个进程的执行。
这种行为被称为进程切换。
因此可以说,任何进程都是在操作系统内核的支持下运行的,是与内核紧密相关的。
进程的阻塞
正在执行的进程,由于期待的某些事件未发生,如请求系统资源失败、等待某种操作的完成、新数据尚未到达或无新工作做等,则由系统自动执行阻塞原语(Block),使自己由运行状态变为阻塞状态。
可见,进程的阻塞是进程自身的一种主动行为,也因此只有处于运行态的进程(获得CPU),才可能将其转为阻塞状态。
当进程进入阻塞状态,是不占用CPU资源的。
文件描述符
文件描述符(File Descriptor)是计算机科学中的一个术语,是一个用于表述指向文件的引用的抽象化概念。
文件描述符在形式上是一个非负整数,实际上,它是一个索引值,指向内核为每一个进程所维护的该进程打开文件的记录表。
当程序打开一个现有文件或者创建一个新文件时,内核向进程返回一个文件描述符。
缓存IO
大多数文件系统的默认 IO 操作都是缓存 IO。
其读写过程如下:
读操作:操作系统检查内核的缓冲区有没有需要的数据,如果已经缓存了,那么就直接从缓存中返回;否则从磁盘、网卡等中读取,然后缓存在操作系统的缓存中; 写操作:将数据从用户空间复制到内核空间的缓存中。这时对用户程序来说写操作就已经完成,至于什么时候再写到磁盘、网卡等中由操作系统决定,除非显示地调用了 sync 同步命令。
假设内核空间缓存无需要的数据,用户进程从磁盘或网络读数据分两个阶段:
阶段一: 内核程序从磁盘、网卡等读取数据到内核空间缓存区; 阶段二: 用户程序从内核空间缓存拷贝数据到用户空间。
缓存 IO 的缺点:
数据在传输过程中需要在应用程序地址空间和内核空间进行多次数据拷贝操作,这些数据拷贝操作所带来的CPU以及内存开销非常大。
同步阻塞
用户空间的应用程序执行一个系统调用,这会导致应用程序阻塞,什么也不干,直到数据准备好,并且将数据从内核复制到用户进程,最后进程再处理数据,在等待数据到处理数据的两个阶段,整个进程都被阻塞,不能处理别的网络IO。
调用应用程序处于一种不再消费 CPU 而只是简单等待响应的状态,因此从处理的角度来看,这是非常有效的。
这也是最简单的IO模型,在通常FD较少、就绪很快的情况下使用是没有问题的。

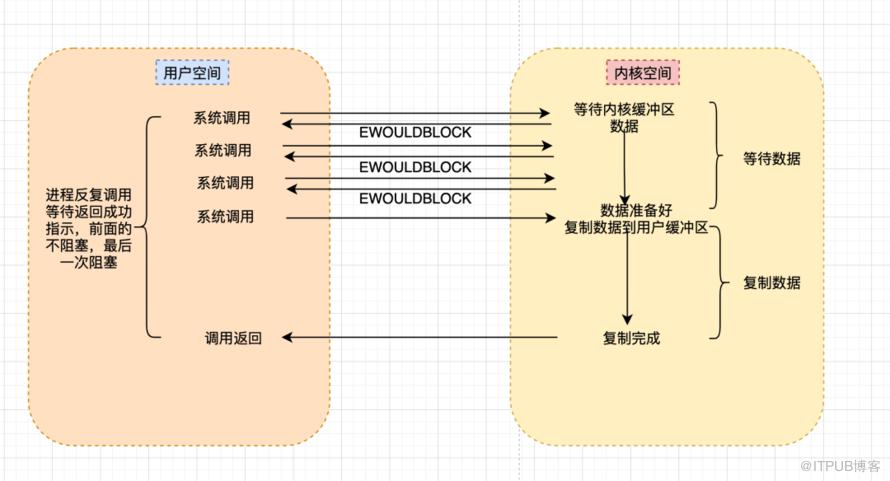
同步非阻塞
非阻塞的系统调用调用之后,进程并没有被阻塞,内核马上返回给进程,如果数据还没准备好,此时会返回一个error。
进程在返回之后,可以干点别的事情,然后再发起系统调用。
重复上面的过程,循环往复的进行系统调用。这个过程通常被称之为轮询。
轮询检查内核数据,直到数据准备好,再拷贝数据到进程,进行数据处理。
需要注意,拷贝数据整个过程,进程仍然是属于阻塞的状态。
这种方式在编程中对Socket设置
O_NONBLOCK即可。
IO多路复用
IO多路复用,这是一种进程预先告知内核的能力,让内核发现进程指定的一个或多个IO条件就绪了,就通知进程。
使得一个进程能在一连串的事件上等待。
IO复用的实现方式目前主要有Select、Poll和Epoll。
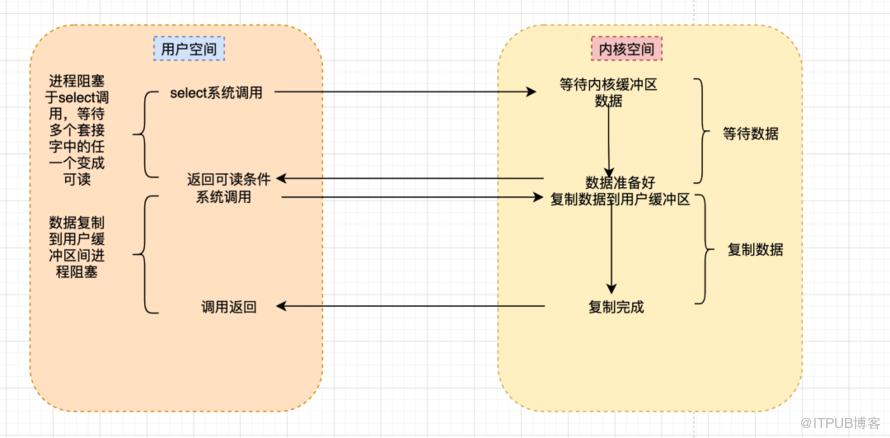
伪代码描述IO多路复用:
while(status == OK) { // 不断轮询
 ready_fd_list = io_wait(fd_list); //内核缓冲区是否有准备好的数据
 for(fd in ready_fd_list) {
  data = read(fd) // 有准备好的数据读取到用户缓冲区
  process(data)
 }
}
信号驱动
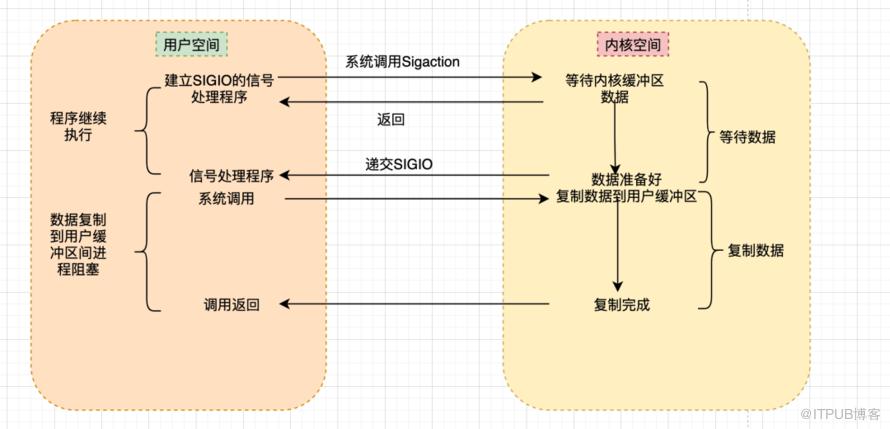
首先我们允许Socket进行信号驱动IO,并安装一个信号处理函数,进程继续运行并不阻塞。
当数据准备好时,进程会收到一个SIGIO信号,可以在信号处理函数中调用I/O操作函数处理数据。
流程如下:
开启套接字信号驱动IO功能 系统调用Sigaction执行信号处理函数(非阻塞,立刻返回) 数据就绪,生成Sigio信号,通过信号回调通知应用来读取数据
此种IO方式存在的一个很大的问题:Linux中信号队列是有限制的,如果超过这个数字问题就无法读取数据
异步非阻塞
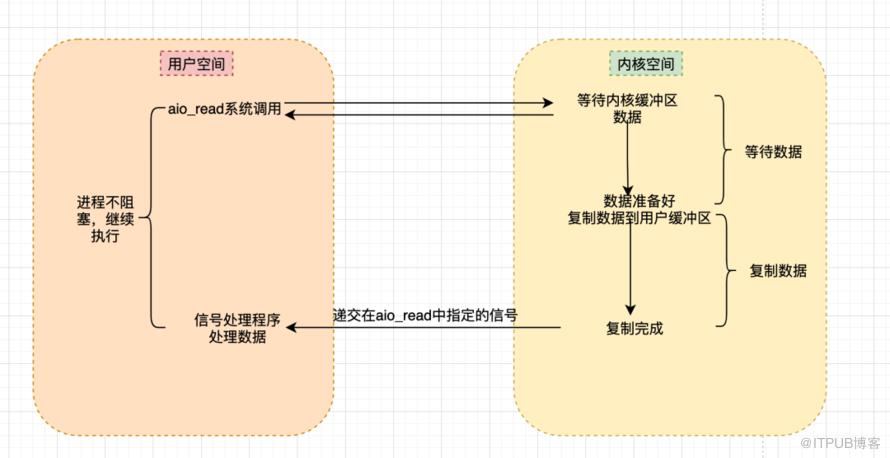
异步IO流程如下所示:
当用户线程调用了 aio_read系统调用,立刻就可以开始去做其它的事,用户线程不阻塞内核就开始了IO的第一个阶段:准备数据。当内核一直等到数据准备好了,它就会将数据从内核内核缓冲区,拷贝到用户缓冲区 内核会给用户线程发送一个信号,或者回调用户线程注册的回调接口,告诉用户线程Read操作完成了 用户线程读取用户缓冲区的数据,完成后续的业务操作
相对于同步IO,异步IO不是顺序执行。
用户进程进行aio_read系统调用之后,无论内核数据是否准备好,都会直接返回给用户进程,然后用户态进程可以去做别的事情。
等到数据准备好了,内核直接复制数据给进程,然后从内核向进程发送通知。
对比信号驱动IO,异步IO的主要区别在于:
信号驱动由内核告诉我们何时可以开始一个IO操作(数据在内核缓冲区中),而异步IO则由内核通知IO操作何时已经完成(数据已经在用户空间中)。
异步IO又叫做事件驱动IO,在Unix中,为异步方式访问文件定义了一套库函数,定义了AIO的一系列接口。
使用 aio_read或者aio_write发起异步IO操作,使用aio_error检查正在运行的IO操作的状态。
目前Linux中AIO的内核实现只对文件IO有效,如果要实现真正的AIO,需要用户自己来实现。
目前有很多开源的异步IO库,例如libevent、libev、libuv。
Java网络IO模型
BIO
BIO是一个典型的网络编程模型,是通常我们实现一个服务端程序的方法,对应Linux内核的同步阻塞IO模型,发送数据和接收数据的过程如下所示:
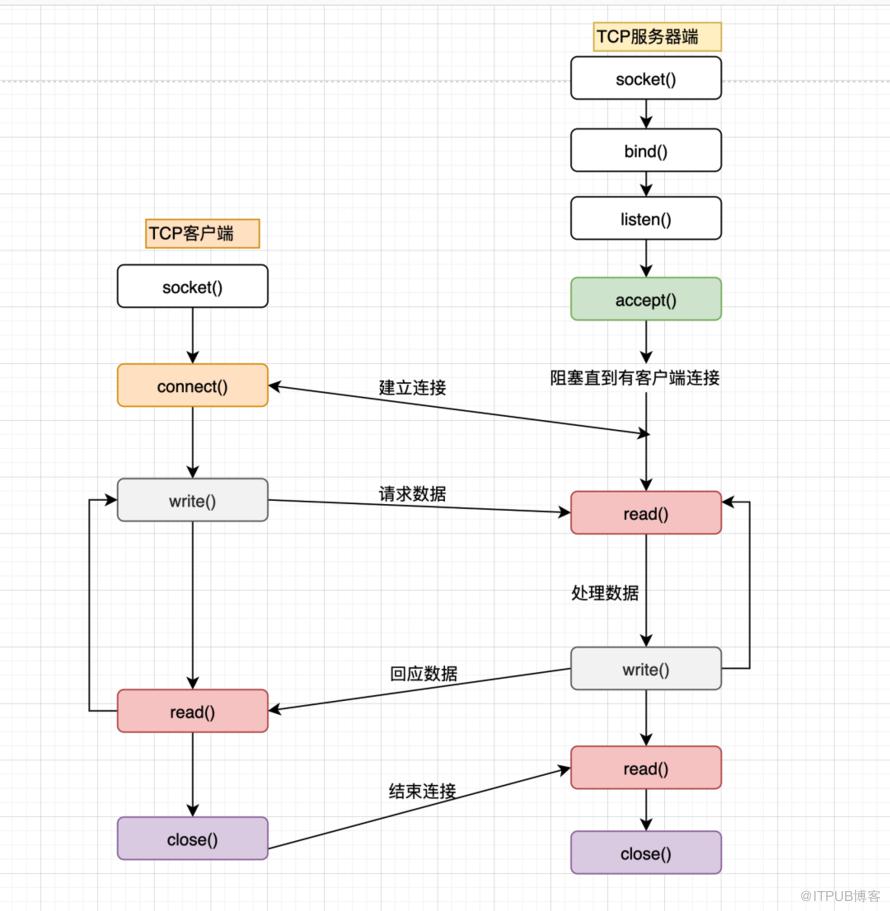
步骤如下:
主线程accept请求 请求到达,创建新的线程来处理这个套接字,完成对客户端的响应 主线程继续accept下一个请求
服务端处理伪代码如下所示:
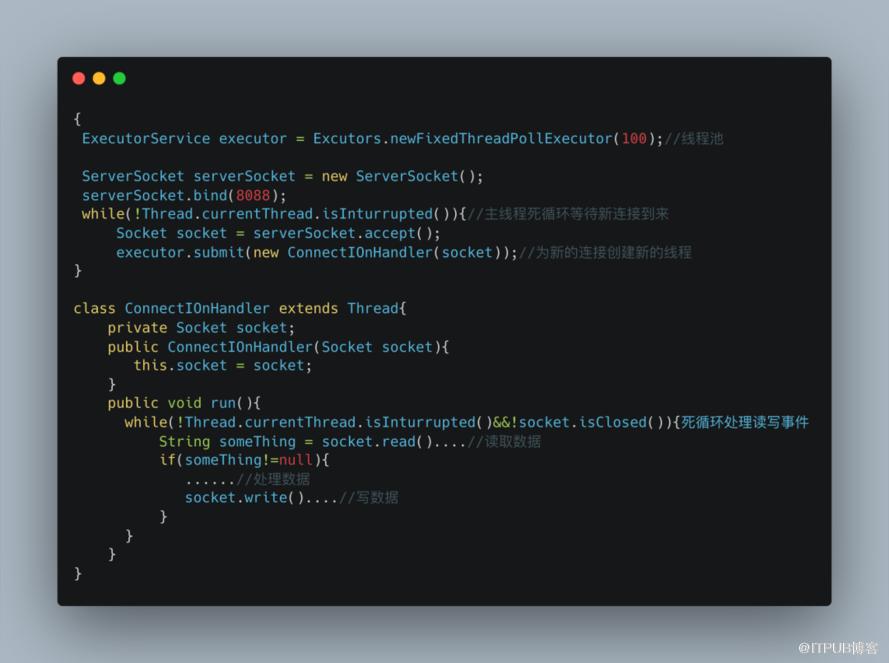
这是经典的一个连接对应一个线程的模型,之所以使用多线程,主要原因在于socket.accept()、socket.read()、socket.write()三个主要函数都是同步阻塞的。
当一个连接在处理I/O的时候,系统是阻塞的,如果是单线程的话必然就阻塞,但CPU是被释放出来的,开启多线程,就可以让CPU去处理更多的事情。
其实这也是所有使用多线程的本质:
利用多核,当I/O阻塞时,但CPU空闲的时候,可以利用多线程使用CPU资源。
当面对十万甚至百万级连接的时候,传统的BIO模型是无能为力的。
随着移动端应用的兴起和各种网络游戏的盛行,百万级长连接日趋普遍,此时,必然需要一种更高效的I/O处理模型。
NIO
JDK1.4开始引入了NIO类库,主要是使用Selector多路复用器来实现。
Selector在Linux等主流操作系统上是通过IO复用Epoll实现的。
NIO的实现流程,类似于Select:
创建ServerSocketChannel监听客户端连接并绑定监听端口,设置为非阻塞模式 创建Reactor线程,创建多路复用器(Selector)并启动线程 将ServerSocketChannel注册到Reactor线程的Selector上,监听Accept事件 Selector在线程run方法中无线循环轮询准备就绪的Key Selector监听到新的客户端接入,处理新的请求,完成TCP三次握手,建立物理连接 将新的客户端连接注册到Selector上,监听读操作,读取客户端发送的网络消息 客户端发送的数据就绪则读取客户端请求,进行处理
简单处理模型是用一个单线程死循环选择就绪的事件,会执行系统调用(Linux 2.6之前是Select、Poll,2.6之后是Epoll,Windows是IOCP),还会阻塞的等待新事件的到来。
新事件到来的时候,会在Selector上注册标记位,标示可读、可写或者有连接到来,简单处理模型的伪代码如下所示:

NIO由原来的阻塞读写(占用线程)变成了单线程轮询事件,找到可以进行读写的网络描述符进行读写。
除了事件的轮询是阻塞的(没有可干的事情必须要阻塞),剩余的I/O操作都是纯CPU操作,没有必要开启多线程。
并且由于线程的节约,连接数大的时候因为线程切换带来的问题也随之解决,进而为处理海量连接提供了可能。
AIO
JDK1.7引入NIO2.0,提供了异步文件通道和异步套接字通道的实现。
其底层在Windows上是通过IOCP实现,在Linux上是通过IO复用Epoll来模拟实现的。
在JAVA NIO框架中,Selector它负责代替应用查询中所有已注册的通道到操作系统中进行IO事件轮询、管理当前注册的通道集合,定位发生事件的通道等操作。
但是在JAVA AIO框架中,由于应用程序不是轮询方式,而是订阅-通知方式,所以不再需要Selector(选择器)了,改由Channel通道直接到操作系统注册监听 。
JAVA AIO框架中,只实现了两种网络IO通道:
AsynchronousServerSocketChannel(服务器监听通道)
AsynchronousSocketChannel(Socket套接字通道)。
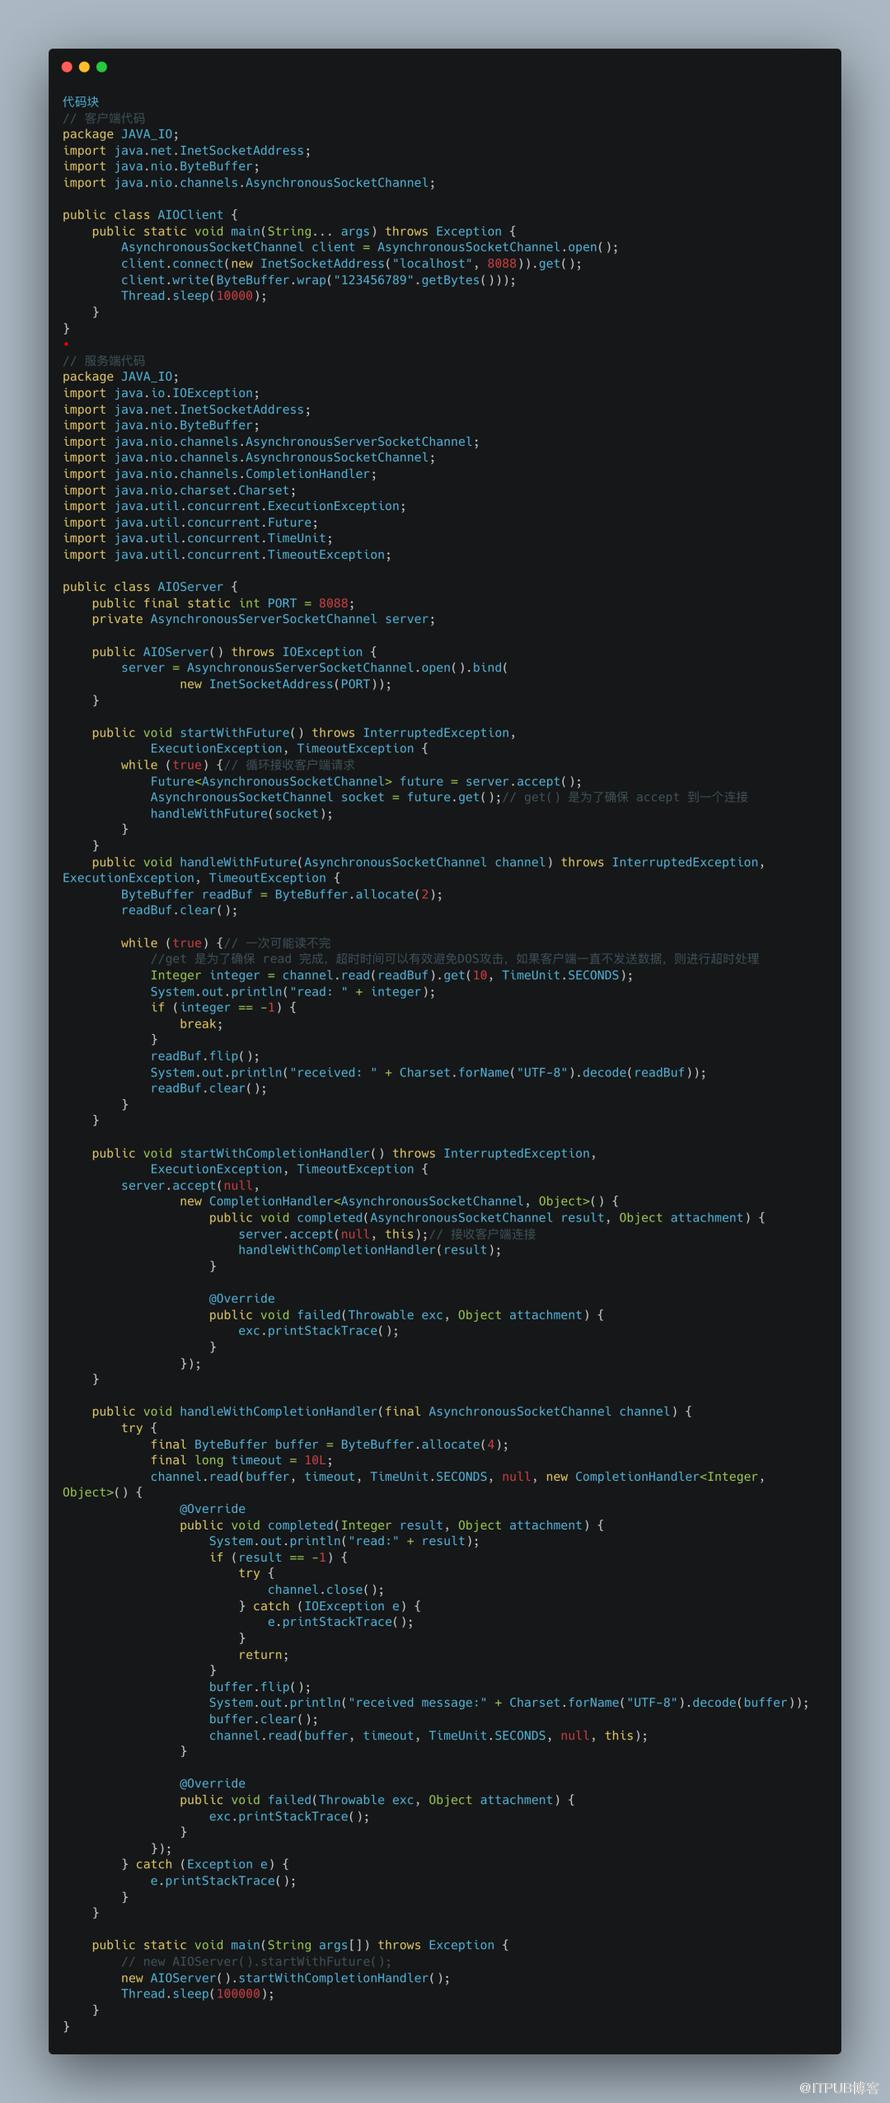
具体过程如下所示:
创建AsynchronousServerSocketChannel,绑定监听端口 调用AsynchronousServerSocketChannel的accpet方法,传入自己实现的CompletionHandler,包括上一步,都是非阻塞的 连接传入,回调CompletionHandler的completed方法,在里面,调用AsynchronousSocketChannel的read方法,传入负责处理数据的CompletionHandler 数据就绪,触发负责处理数据的CompletionHandler的completed方法,继续做下一步处理即可 写入操作类似,也需要传入CompletionHandler
最后
觉得有收获,希望帮忙点赞,转发下哈,谢谢,谢谢
微信搜索:月伴飞鱼,交个朋友
公众号后台回复666,可以获得免费电子书籍
原文作者:月伴飞鱼;如有侵权,请联系管理员删除。

