六语十万小时。这个开源AI语音数据集有点厉害
还记得那个开口就能说多国语言的梦想吗? 想要训练出一个超级AI语音助手,一个能听懂全世界语言的翻译软件?实现这一切的基础,就是一个庞大、高质量的多语言语音数据集。
今天,就来给大家介绍一个重量级选手:Emilia,一个开源、多语言、高质量的语音数据集,它包含了六种语言,总时长超过10万小时。
Emilia究竟有什么过人之处呢?
语言覆盖广: 包含中、英、日、韩、德、法六种语言,打破语言壁垒,为跨语言语音研究提供了宝贵资源。 音质超清晰: 所有音频均为高质量的.mp3文件,并配有精准的文本转录,保证数据的准确性和易用性。 规模超乎想象: 超过10万小时的语音数据,涵盖了脱口秀、访谈、辩论、体育解说、有声书等多种场景,几乎涵盖了你能想到的所有口语表达方式。 开源预处理: Emilia-Pipe预处理管道,让你轻松处理原始音频数据,甚至可以用来处理你自己的语音数据。
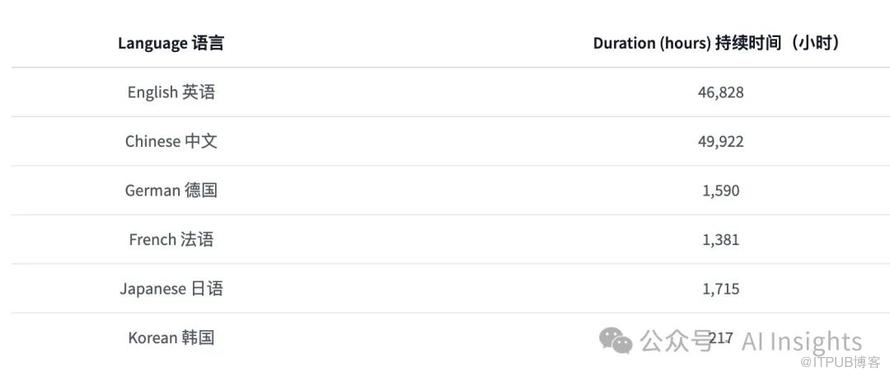
六种语言的时长分别是:
英文: 46,828 小时 中文: 49,922 小时 德文: 1,590 小时 法文: 1,381 小时 日文: 1,715 小时 韩文: 217 小时
想要体验这个宝藏数据集的强大功能吗? 赶紧点击下方链接下载吧。
数据集下载:https://huggingface.co/datasets/amphion/Emilia
相信Emilia的出现,必将推动语音识别、语音合成、机器翻译等领域的快速发展,让我们一起期待未来更智能、更便捷的语音交互体验。
以上就是我的分享,希望你能阅有所获,如果想加入社群可以扫下方的二维码添加我的微信,这里有最新的AI资讯和应用案例,互相交流共同提升,备注交流群,我会拉你入群(为了防止恶意广告营销,让大家有更好的交流氛围,现在进群需要9.9的门槛,希望大家理解)
原文作者:AI Insights;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
最新文章
- 今晚,这是要上天吗?!操纵鼠标键盘,玩转电脑,Claude 新版本来袭,推理评分力压OpenAI O1!
- 深夜惊雷:Adobe新AI让2D变3D,设计师们的饭碗要保不住了?
- 时薪48美元招募“机器人陪练”?特斯拉这波操作,背后真相惊人
- 谷歌AI黑科技:咳嗽一声,就知道你有没有病
- 手机秒变AI大脑!微软开源Phi-3.5-vision,颠覆视觉推理?!
- GPT-4语音开源版?!这个AI竟然还能演戏讲段子!
- 96%老板狂喜,71%员工崩溃!AI究竟是蜜糖还是毒药?
- 缺少爆款笔记?看看这个手机端小红书笔记批量采集工作流
- AI训练卷疯了?Salesforce开源一万亿Token数据集
- AI 竟然能记住你的喜好?Stable Diffusion黑科技,从此告别“撞画”!
