10倍性能!这款手机AI大模型,打败了99%的对手
手机也能跑大模型?Hugging Face 开源 SmolLM,性能炸裂碾压一众竞品。
还在羡慕别人手机里的“贾维斯”吗?还在为体验不到本地运行大模型而苦恼吗? 好消息来了。Hugging Face 刚刚发布了一系列完全开源的小型语言模型 SmolLM,参数量从 135M 到 1.7B 不等,最重要的是,它可以在你的手机上流畅运行。
SmolLM 到底有多强? 它直接对标了市面上最强的几款小型模型,包括微软的 Phi 系列、阿里巴巴的 Qwen2(小于 2B 参数)和 Meta 的 MobileLLM,并在多项测试中取得了全面胜利。更令人惊喜的是,Hugging Face 公开了 SmolLM 的数据策划和训练细节,这在如今的 AI 界简直是一股清流,也为开发者们提供了极大的便利。
那为什么SmolLM 能这么强? 且听我慢慢道来:
模型架构:从小巧玲珑到性能怪兽
SmolLM 系列包含三种规模的模型,每种都针对不同的设备和应用场景进行了优化:
135M 和 360M 参数模型: 专为内存受限的设备设计,例如智能手机和小型嵌入式系统。它们采用了类似 MobileLLM 的架构,并利用分组查询注意力(GQA)机制来提高效率。 1.7B 参数模型: 面向高端智能手机、普通笔记本电脑等性能更强的设备,采用了更传统的架构设计,以追求更强大的性能。
值得一提的是, 所有 SmolLM 模型都拥有 2048 个 token 的上下文长度,并且可以通过长上下文微调进一步扩展,这意味着它们能够处理更长、更复杂的任务。
优质数据集:SmolLM 的秘密武器
俗话说“巧妇难为无米之炊”,强大的模型离不开优质的训练数据集。SmolLM 正是得益于精心策划的 SmolLM-Corpus 数据集,才得以在众多模型中脱颖而出。这个数据集包含三大法宝:
1. Cosmopedia v2: 这是一个由 Hugging Face 利用 llama3-70B-Instruct 和 Qwen1.5-72B-Chat 等强大模型生成的合成数据集,涵盖了 34,000 多个主题,包含了超过 3000 万本合成教科书、博客文章和故事。
2. FineWeb-Edu: 从著名的 FineWeb 数据集中筛选出的精华部分,包含 1.3T 个 token 的教育网页数据,经过了严格的质量控制,确保了数据的可靠性和教育价值。
3. Stack-Edu-Python: 从 The Stack 数据集中精选的 50 万个 Python 代码样本,这些样本都经过了 Llama3 的注释和分类,并筛选出评分最高的样本,保证了模型在代码生成任务上的出色表现。
性能评估:用实力说话,SmolLM 表现如何?
光说不练假把式,Hugging Face 在多个基准测试中对 SmolLM 进行了全方位的评估,结果证明, SmolLM 的性能相当能打。
常识推理与世界知识:
SmolLM-135M: 超越了 MobileLM-125M,成为 200M 参数以下模型中的佼佼者。 SmolLM-360M: 击败了 MobileLM-350M 和 Qwen2-500M 等强劲对手,问鼎 500M 参数以下模型的冠军宝座。 SmolLM-1.7B: 在与 Phi1.5、MobileLM-1.5B 和 Qwen2-1.5B 等 2B 参数以下模型的较量中,SmolLM-1.7B 依然稳稳占据上风。
代码生成性能(Python 编程测试):

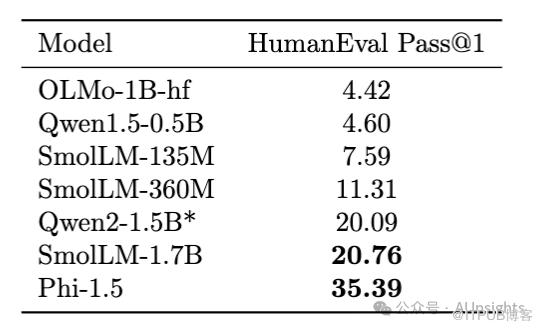
SmolLM-1.7B: 在 Python 编程测试中取得了 24 分的好成绩,展现了其在代码生成任务上的强大实力。
内存占用:
SmolLM 在设计时就考虑到了在各种硬件配置上的运行效率,因此 SmolLM 的内存占用非常低,即使在智能手机上也能流畅运行。
总结:开源、高效、性能强劲,SmolLM 未来可期。
Hugging Face 推出 SmolLM 系列模型,是开源社区的一大盛事,它不仅为开发者提供了一个强大的工具,也为小型语言模型的发展指明了方向。相信在不久的将来,我们会看到 SmolLM 在更多领域发挥作用,为我们带来更多惊喜。
想要了解更多关于 SmolLM 的信息吗? 快来访问官方链接:
SmolLM 模型集合 SmolLM-Corpus 数据集 WebGPU 演示 官方介绍:https://huggingface.co/blog/smollm
以上就是我的分享,希望你能阅有所获,如果想加入社群可以扫下方的二维码添加我的微信,这里有最新的AI资讯和应用案例,互相交流共同提升,备注交流群,我会拉你入群(为了防止恶意广告营销,让大家有更好的交流氛围,现在进群需要9.9的门槛,希望大家理解),如果对加群不感兴趣也欢迎加我微信围观朋友圈,我会经常更新AI领域的好玩的工具。
原文作者:AI Insights;如有侵权,请联系管理员删除。

最新文章
- 今晚,这是要上天吗?!操纵鼠标键盘,玩转电脑,Claude 新版本来袭,推理评分力压OpenAI O1!
- 深夜惊雷:Adobe新AI让2D变3D,设计师们的饭碗要保不住了?
- 时薪48美元招募“机器人陪练”?特斯拉这波操作,背后真相惊人
- 谷歌AI黑科技:咳嗽一声,就知道你有没有病
- 手机秒变AI大脑!微软开源Phi-3.5-vision,颠覆视觉推理?!
- GPT-4语音开源版?!这个AI竟然还能演戏讲段子!
- 96%老板狂喜,71%员工崩溃!AI究竟是蜜糖还是毒药?
- 缺少爆款笔记?看看这个手机端小红书笔记批量采集工作流
- AI训练卷疯了?Salesforce开源一万亿Token数据集
- AI 竟然能记住你的喜好?Stable Diffusion黑科技,从此告别“撞画”!
