苹果放大招:LLM更新不再“翻车”,用户体验提升100%
苹果放大招:LLM更新不再“翻车”,用户体验提升100%。
还在为大型语言模型(LLM)每次更新后的结果不一致而烦恼吗?苹果公司最近推出了一种名为MUSCLE的训练策略,完美解决了这个问题。
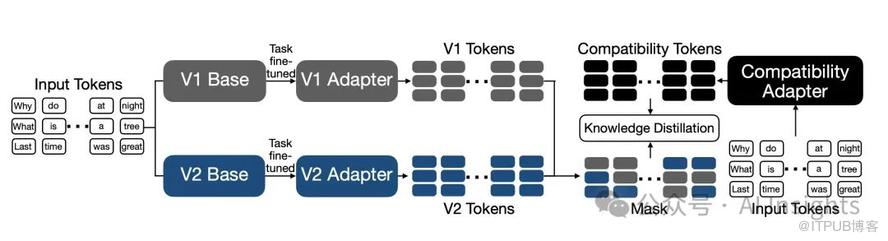
想象一下,你最爱的翻译软件更新后,以前翻译精准的句子现在却频频出错,是不是很抓狂?这就是LLM更新中常见的“负翻转”现象。MUSCLE就像一位经验丰富的“老中医”,通过巧妙的“知识蒸馏”,将旧模型的精髓传授给新模型,让它在性能提升的同时,还能保持“初心”,避免出现“翻车”情况。
具体来说,MUSCLE是怎么做的呢?
训练“兼容性适配器”: MUSCLE的核心是训练一个特殊的适配器,就像给新模型戴上了一副“老花镜”,让它能够更好地理解和继承旧模型的优势。 适配器“模仿秀”: 这个适配器会模仿旧模型的预测行为,确保新模型在学习新知识的同时,不会忘记“老师傅”教过的东西。 “知识蒸馏”大法: MUSCLE还采用了一种叫做“知识蒸馏”的技术,将旧模型的知识精华提炼出来,直接传授给新模型,让它在起跑线上就领先一步。 “掩码策略”加持: 为了避免新模型“学歪”,MUSCLE还引入了一种“掩码策略”,就像一位严厉的“教导主任”,时刻监督新模型的学习过程,一旦发现它犯了错误,就会及时纠正。
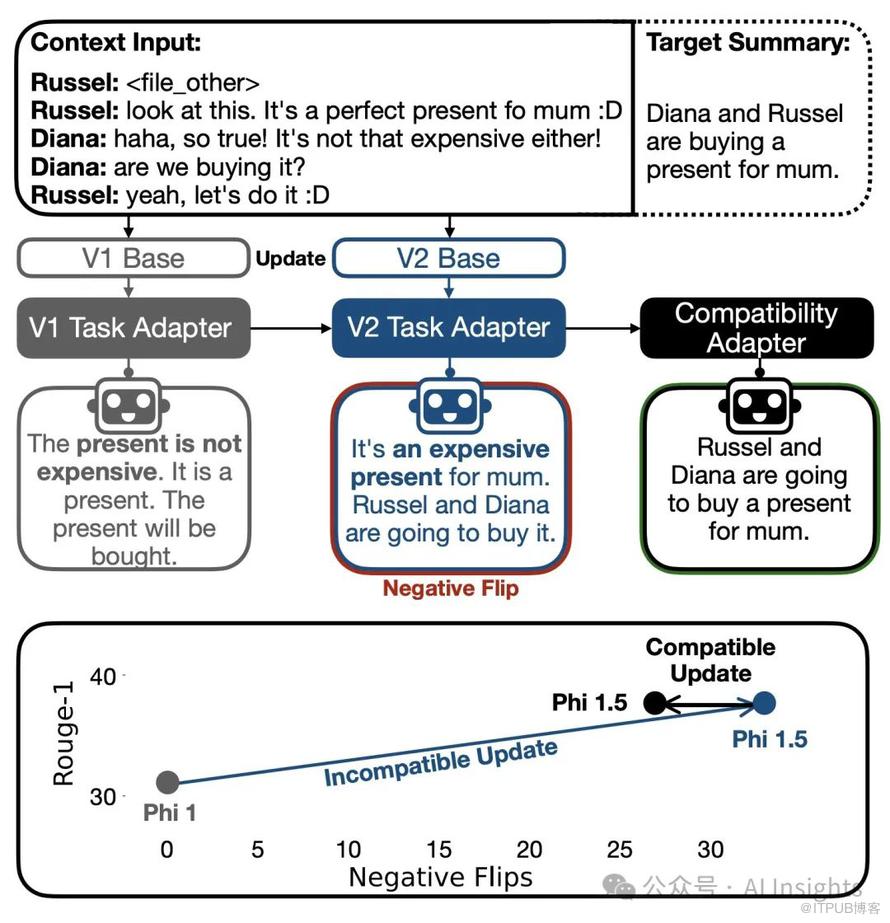
上图展示了一个真实的“负翻转”案例:在对话摘要任务中,旧模型生成的摘要在新模型中却出现了错误。
MUSCLE究竟解决了哪些用户痛点?
彻底告别“负翻转”: 有了MUSCLE,LLM更新后,你再也不用担心模型“失忆”或者“学坏”了。 降低用户适应成本: 每次更新后,你都得花时间重新熟悉模型的新变化,有了MUSCLE,你可以将这些时间节省下来去做更多有意义的事情。 提升模型更新一致性: MUSCLE确保了模型更新前后的一致性,让你使用起来更加得心应手。
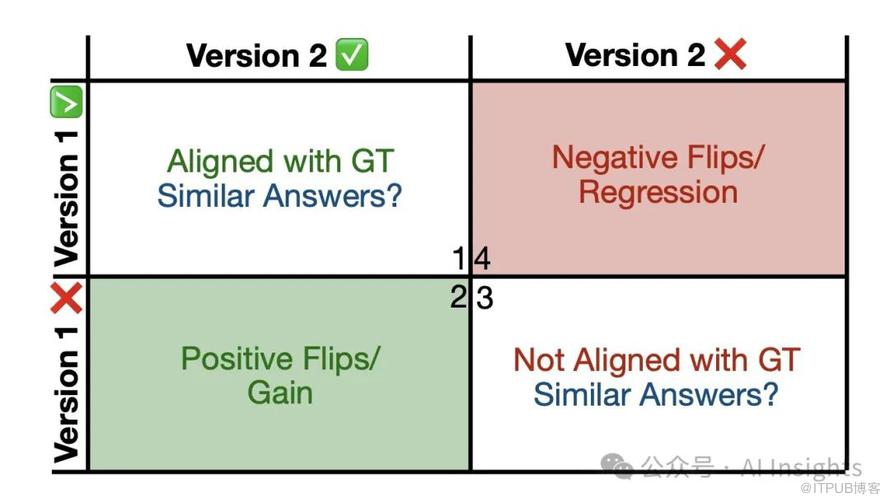
为了更直观地评估MUSCLE的效果,研究人员将模型更新后的样本分成了四种情况:
象限 1: 新旧模型都正确,皆大欢喜。 象限 2: 旧模型错误,新模型正确,这就是进步的体现。 象限 3: 新旧模型都错误,但至少保持了一致性,用户更容易接受。 象限 4: 旧模型正确,新模型错误,这就是令人头疼的“负翻转”。
MUSCLE的目标就是让象限 2 的样本尽可能多,象限 4 的样本尽可能少。
实验结果证明,MUSCLE真的做到了。
负翻转现象大幅减少: 在多个任务中,MUSCLE成功将负翻转率降低了10%至40%,用户体验大幅提升。
模型性能稳步提升: MUSCLE不仅减少了负翻转,还让模型的整体性能更上一层楼。
模型行为更加一致: MUSCLE让模型更新前后的行为更加一致,用户使用起来更加顺畅自然。
MUSCLE的出现,标志着LLM更新进入了一个全新的时代,用户体验将得到前所未有的提升。
以上就是我的分享,希望你能阅有所获,如果想加入社群可以扫下方的二维码添加我的微信,这里有最新的AI资讯和应用案例,互相交流共同提升,备注交流群,我会拉你入群(为了防止恶意广告营销,让大家有更好的交流氛围,现在进群需要9.9的门槛,希望大家理解),如果对加群不感兴趣也欢迎加我微信围观朋友圈,我会经常更新AI领域的好玩的工具。
原文作者:AI Insights;如有侵权,请联系管理员删除。

请登录后发表评论
登录
全部评论
最新文章
- 今晚,这是要上天吗?!操纵鼠标键盘,玩转电脑,Claude 新版本来袭,推理评分力压OpenAI O1!
- 深夜惊雷:Adobe新AI让2D变3D,设计师们的饭碗要保不住了?
- 时薪48美元招募“机器人陪练”?特斯拉这波操作,背后真相惊人
- 谷歌AI黑科技:咳嗽一声,就知道你有没有病
- 手机秒变AI大脑!微软开源Phi-3.5-vision,颠覆视觉推理?!
- GPT-4语音开源版?!这个AI竟然还能演戏讲段子!
- 96%老板狂喜,71%员工崩溃!AI究竟是蜜糖还是毒药?
- 缺少爆款笔记?看看这个手机端小红书笔记批量采集工作流
- AI训练卷疯了?Salesforce开源一万亿Token数据集
- AI 竟然能记住你的喜好?Stable Diffusion黑科技,从此告别“撞画”!
