paper:https://arxiv.org/pdf/1805.04174.pdf
code:https://github.com/guoyinwang/LEAM
文本分类是NLP领域的基础任务之一,主要是对给定文本指定一个或者多个合理的标签。目前主要是做法是对文本text的表示,比如传统的机器学习,先进行特征工程,比如n-gram,然后使用分类器,比如SVM、朴素贝叶斯;然而深度学习更多的是使用CNN、RNN以及RNN的变种LSTM来进行文本表示,有时会加入Attention机制来捕获文本中的word的依赖和重要度从而更好的学习文本的representation。作者创新性的提出了基于label embedding的注意力模型Label- Embedding Attentive Model (LEAM) 充分学习word与label的关系,该模型学习word和label在同一空间内的embedding,利用text和label的相关性构建文本表示。
然而label embedding技术很早就应用在图像领域了,比如图像分类,图像文本多模态学习,也同样使用与小样本学习zero-shot,想了解的朋友可以参考我之前分享的FSL(Few-Shot Learning)小样本学习,在小样本学习中可以采用这种方式来学习训练数据中未出现过的类别。
虽然label embedding在NLP中也有一些研究,但是目前很少有利用label embedding来设计更有效的attention模型的工作。作者则利用word和label embedding来构建attention模型,这对于目标task也是更为直接。
LEAM模型介绍:
1、数学符号
首先介绍文中的符号表示。用 表示向量或者矩阵的element-wise的除法,◦表示函数组件,训练集为
 ,其中
 为文本序列,
 为对应标记。在本文中,针对单标记任务,
 是一个one-hot vector,而针对多标记任务,
 是一个二值向量。举个例子,假设有5个类别,分别是1,2,3,4,5。如果某个样本对应类别3,在单标记中
 为(0,0,1,0,0)。如果某个样本同时属于类别2和4,则
 为(0,1,0,1,0)。模型的目标是学习一个从
 到
 的映射,使得下式最小
 其中
 是损失函数。
 中的每个word都是一个one-hot vector
 ,D是字典的大小。而word embedding就是做一个
 到
 的映射,P是embedding的维度,用
 表示第
 个word的embedding。作者将文本分类看作三个函数的组合,
 ,
 是word embedding的函数,
 是将word embedding进行聚合得到文本表示的函数,
 是利用文本表示进行分类的函数。设计
 的方法分为两大类,其中一类是将该过程看作一个黑盒,利用各种深度模型学习映射,而另一个是利用简单的max pooling或者mean pooling。但无论怎样,这两类都只利用了文本word的信息。可以看出,只有
 利用了类别信息,而类别的影响对于
 和
 都是间接的。因此,作者提出在每个过程中都使用标记信息,
2、LEAM模型
模型结构如下图所示:
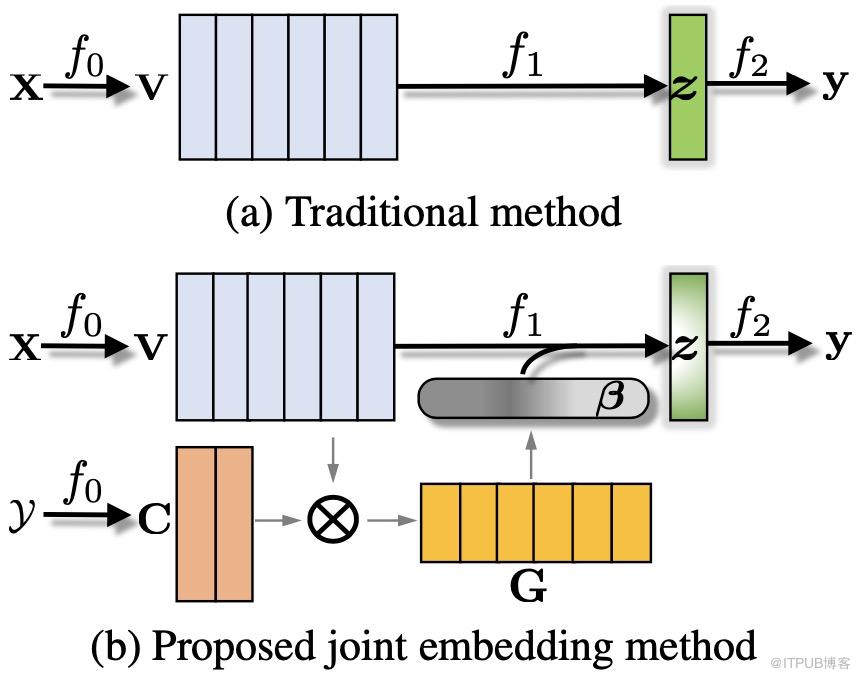
 中,学习label的embedding作为“anchor points”来影响word embedding,在
 中,利用label和word之间的相关性进行word embedding的聚合。具体的,用
 表示第
 个类别的label embedding,
 为label embedding的矩阵,假设共有K个类别,利用cosine 相似度计算每个label-word之间的相似度
 其中
 是大小为
 的归一化矩阵,
 中的每个元素为
 。为了更好的获取连续word之间的空间信息,作者在相似度中引入非线性,而非线性可以用卷积和激活函数得到。用
 衡量中心在
 长度为
 的label-phrase的相关性,第
 个phrase和K个label的相似度向量为
 其中
 ,之后利用max-pooling,可以得到最大相关的系数,即
 。
 是长度为L的向量
 中的第
 个元素。有了m,经过一个softmax之后就可以得到attention的系数,也就是上图中的
 。最终的文本表示为
 对于单标记问题,训练目标为
 其中
 是两个概率向量的交叉熵。对于多标记问题,可以将其拆解为K个单标记问题,目标函数为下公式
 同时,我们也希望label embedding能起到“anchor point”的作用,也就是相同类别的文本表示之间的距离小于不同类别的文本表示之间的距离。因此作者加入了一个正则化项
 在具体的数据集中,如果label也是用word表示,那么可以直接用word embedding来初始化label embedding,比如在
 数据集中,类别被描述为“Computer&Internet”等等。如果不是这种情况,那么label embedding可以用高斯分布初始化。在测试时,由于我们已知所有的类别,因此可以直接将label embedding作为输入,也可以把G离线训练好,以加快推断速度。
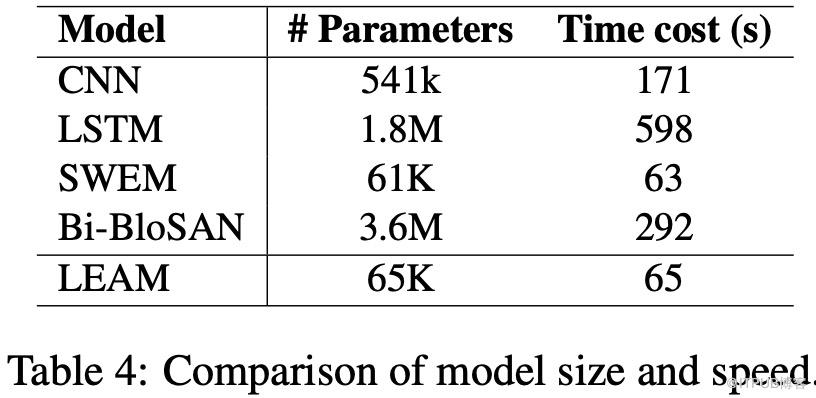
1、模型的复杂度与参数量

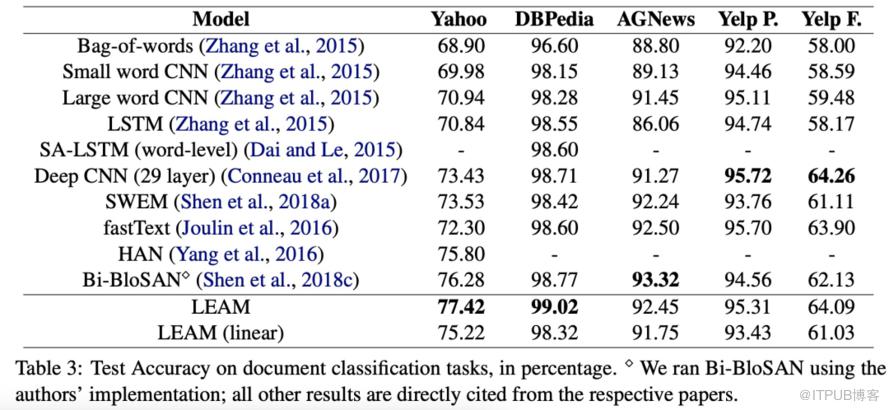
2、实验结果
参考文献:
https://zhuanlan.zhihu.com/p/54734708
https://arxiv.org/pdf/1805.04174.pdf
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
