
一、文本分类介绍
文本分类是NLP比较基础和常用的任务之一,是给指定的输入文本打标签的过程。根据任务不同输入内容主要有query、Sentence、paragraph和document。主要的应用场景有问答系统、语义分析、新闻打标、用户意图理解等等。本论文的贡献主要体现在如下几方面:
(1)展示了150多个深度学习文本分类模型;
(2)梳理了40多个文本分类数据集;
(3)分析了16个benchmark的模型性能;
二、文本分类任务
(1)语义分析sentiment analysis:从文本中抽取用户的态度,比如情感分析,通常可以理解为二分类(比如好评或者差评)和多分类(1-5分);
(2)主题分析或者分类topic analysis:识别文本的主题;
(3)问答question answering:主要有抽取式和生成式两种,抽取式根据问题来匹配候选答案;生成式是根据问题描述自动生成答案;
(4)自然语言推断natural language inference:根据一个文档的含义来推断另一个文档的含义。
三、文本分类深度学习模型
下面根据文本分类使用的深度学习模型不同进行分类:比如FFN、RNN-based、CNN-based、Capsule网络、Attention机制、Memory-augment网络、GNN、孪生网络、混合模型等等。
3.1、FFN
前馈神经网络Feed-forward network是文本分类中最简单的深度学习模型,这些模型会把文本看出是词袋模型,使用word2vec或者glove学习词向量,然后把每个词的词向量进行平均或者求和来表示文本向量,然后使用逻辑回归、朴素贝叶斯或者SVM等传统机器学习算法进行分类。典型的例子就是Deep Average Network(DAN),网络结构如下图Fig1所示:
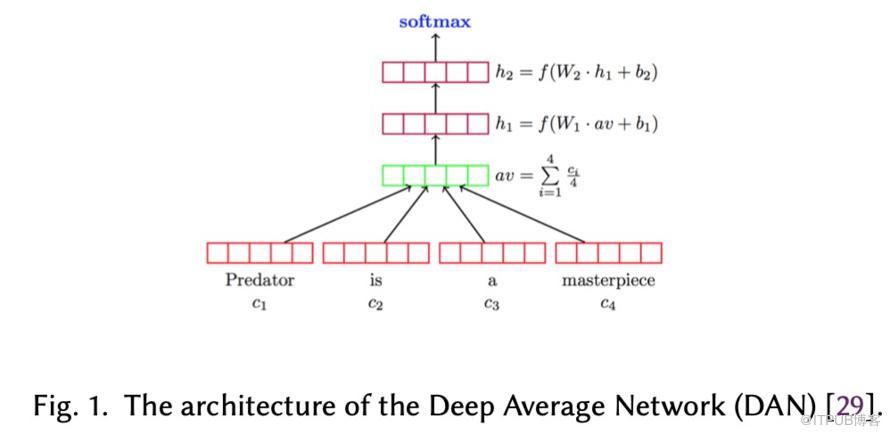
这个模型没有考虑词序信息,Joulin提出的fastText加入了n-gram来捕获局部词序信息,后来的模型更是说明了文本词序的重要性。
Le和Mikolov提出了doc2vec,相信很多人也都使用过,它使用无监督学习算法把文本表示成一个固定长度的向量。模型结构如下图Fig2所示:

doc2vec模型类似word2vec的CBOW,唯一的区别是doc2vec模型把段落token加入到模型中进行训练,学习段落向量D,这点类似bert模型的CLS作用。
3.2、RNN-based模型
RNN-based模型把文本表示为词序列,但是由于Vanilla RNN存在严重的梯度消失和爆炸问题,通常性能还不如FFN模型,现在主流的方式是使用其变体LSTM,LSTM引入了记忆单元并且使用三个门(忘记门、输入门和输出门)来控制信息的流转,可以比较好的捕获长依赖。
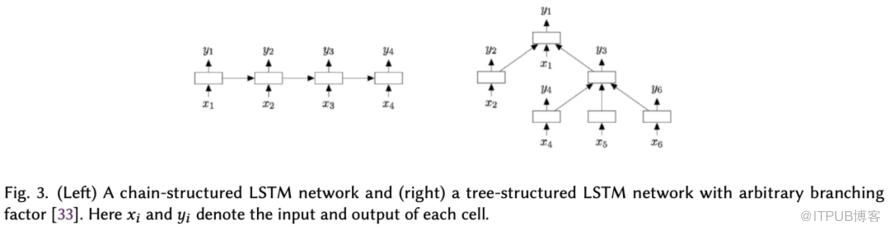
LSTM通常和RNN一样是链式的,Tai提出了Tree-LSTM来抽取词或者短语的句法属性,作者在语义分类任务和预测两句话语义关系任务上证明了其有效性,模型结构如下图Fig3所示:
Multi-Timescale LSTM(MT-LSTM)把标准LSTM的隐藏状态分成了多个组,每个组在不同的时间步被激活和更新,这样模型就可以对非常长的文本进行建模。
RNN可以抽取词序的局部特征,捕获长依赖比较困难;而主题模型可以获取全局语义结构,Dieng结合这两个的优点提出了TopicRNN模型,在语义分析认为上超过RNN baseline模型。
3.3、CNN-based模型
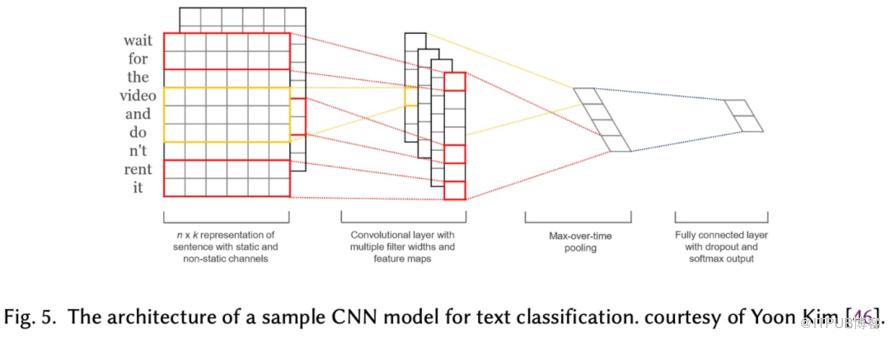
CNN-based模型最经典的就是Kim提出的TextCNN,模型结构如下图Fig5所示。后来Liu对TextCNN模型做了如下两点改进,首先,采用动态最大池策略从文档的不同区域获取更细粒度的特征。第二,在池层和输出层之间插入一个隐藏的瓶颈层,学习紧凑的文档表示,以减小模型大小并提高模型性能。
3.4、胶囊网络文本分类
在CNN中通常采用池化操作来减少卷积操作的计算复杂度,然而池化操作会损失空间关系信息,会导致实体方向和比例进行错误分类。为了解决这个问题,Hinton提出了胶囊网络,胶囊是一组神经元,其活动向量表示特定类型实体(如对象或对象部分)的不同属性。向量的长度表示实体存在的概率,向量的方向表示实体的属性。与CNNs的max-pooling不同的是,它选择一些信息并丢弃其余的信息,胶囊将下层的每个胶囊“路由”到上层的最佳父胶囊,使用网络中的所有可用信息直到最后一层进行分类。路由可以使用不同的算法来实现,例如协议动态路由或EM算法。想了解胶囊网络的读者,可以看一下CapsNet的结构和实现方式。
胶囊网络也可以应用于文本分类中,每个胶囊可以学习句子或者文档的向量表示。这里介绍其中的一个应用,网络结构有四层,分别是: (1) an n-gram convolutional layer, (2) a capsule layer, (3) a convolutional capsule layer, and (4) a fully connected capsule layer.如图Fig7所示:
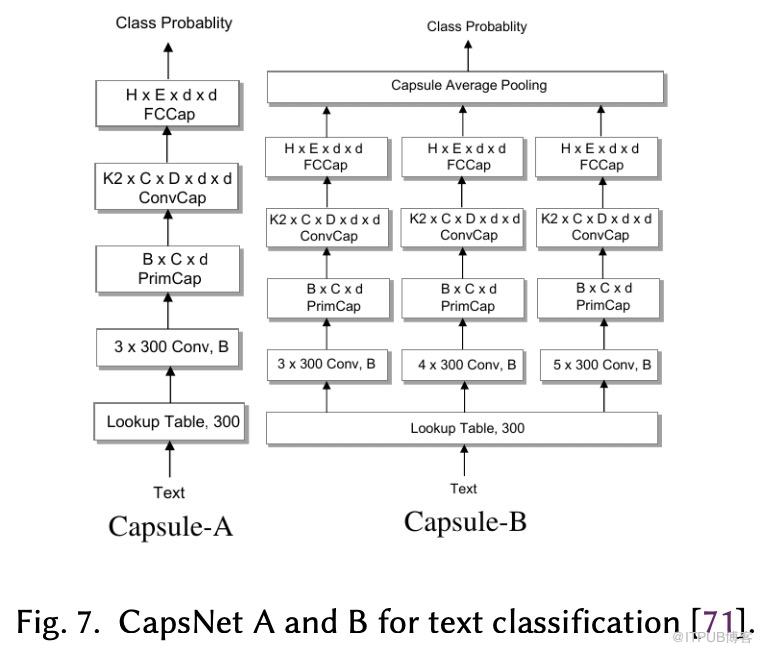
Kim提出了一个更简单的结构,模型包括(1) 输入层:把输入文本表示为词向量序列an input layer that takes a document as a sequence of word embeddings; (2) 卷积层:生成特征图并且使用选通线性单元来保留空间信息a convolutional layer that generates feature maps and uses a gated-linear unit to retain spatial information; (3) 卷积胶囊层:通过聚集由卷积层检测到的局部特征来形成全局特征a convolutional capsule layer to form global features by aggregating local features detected by the convolutional layer; and (4)输出层:预测文本分类标签 a text capsule layer to predict class labels。该模型在语句交换位置后依然可以保持相同的语义。Aly又提出了层次多标签分类Hierachical Multilabel Classification(HMC)可以对父子关系进行编码,进一步提升模型性能。
3.5、注意力机制
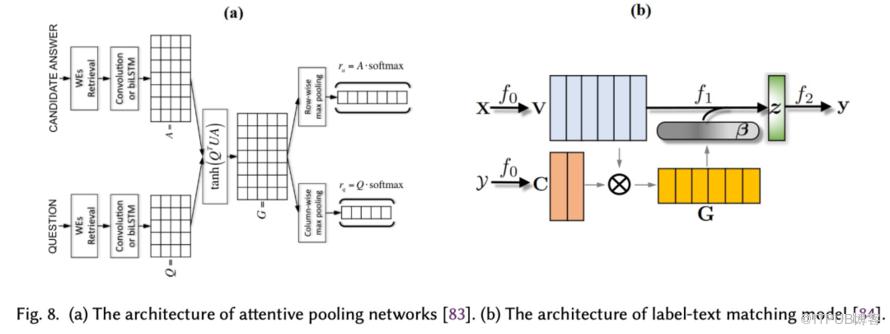
3.6、记忆增强网络Memory-Augmented Network
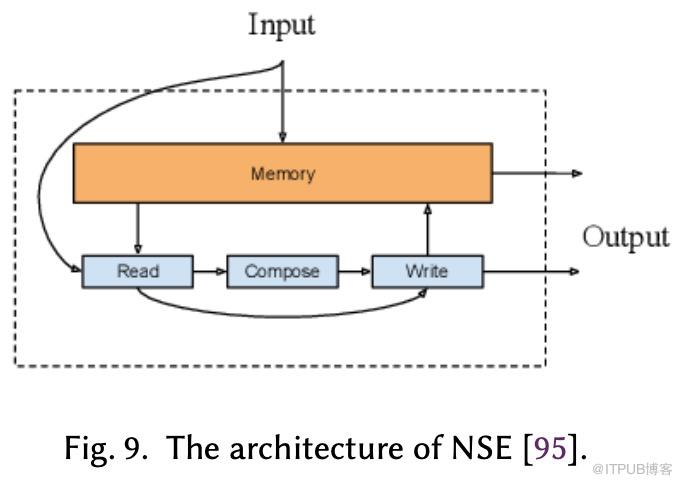
注意模型在编码过程中存储的隐藏向量可以看作是模型内部记忆,记忆增强网络将神经网络与一种形式的外部记忆相结合,模型可以读取和写入外部记忆。
Munkhdalai针对文本分类任务和QA系统提出一种记忆增强网络,称为Neural Semantic Encoder(NSE),NSE有一个随着时间推移而变化的可变大小的编码存储器,通过read、compose和write来理解输入数据。
3.7、GNN

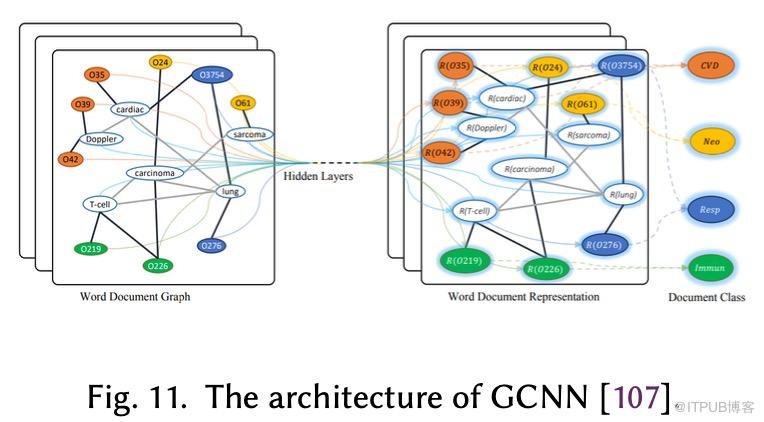
3.8、孪生网络
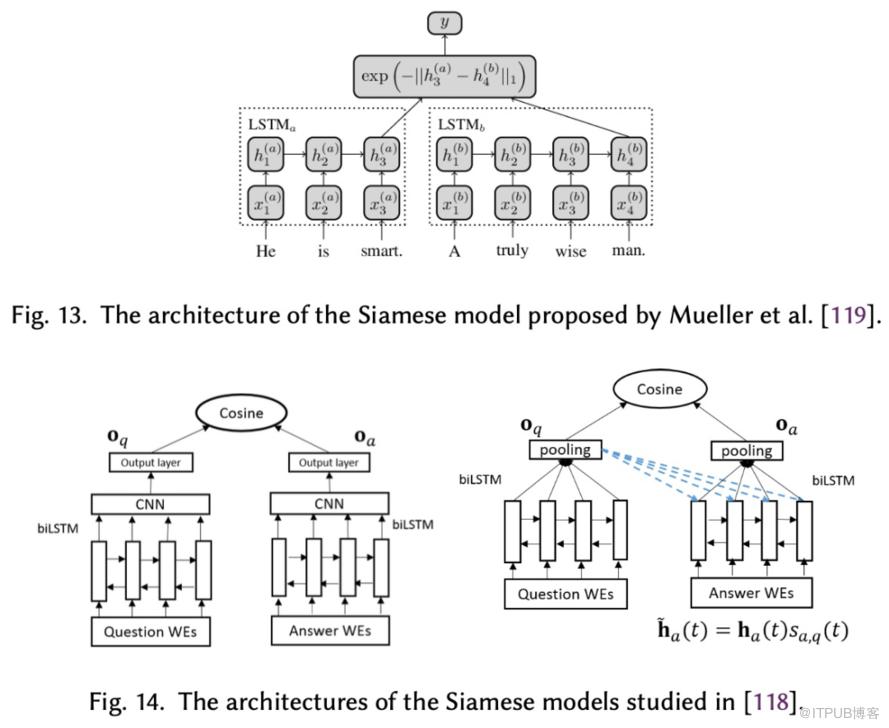
孪生网络和他们的变种被称为Deep Structured Semantic Model(DSSM),主要应用于文本匹配场景,比如query-document排序、抽取式QA系统的答案选择,网络结构一般是把两部分输入分别进行编码,然后再计算相似度,如下图Fig12-14所示:

3.9、混合模型hybrid model
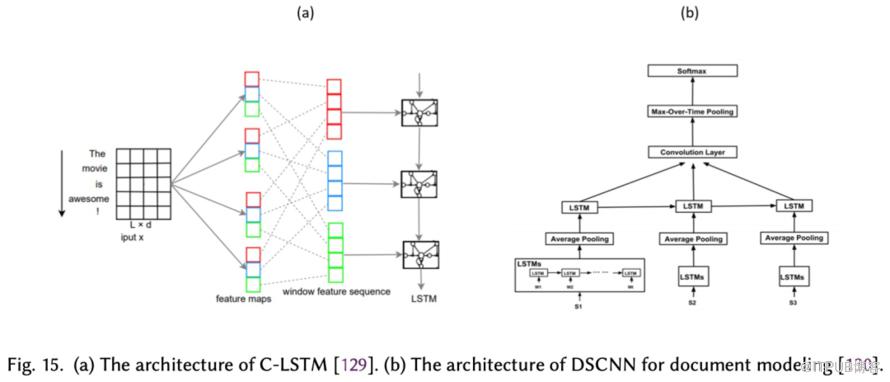
许多混合模型会把LSTM和CNN结合使用,这样既可以抽取全局特征也可以抽取局部特征。Zhu提出的Convolution LSTM(C-LSTM),如下图Fig15(a),使用CNN来抽取high-level表示(比如n-gram),然后再喂给LSTM;Zhang提出了Dependency Sensitive(DSCNN)对文档进行建模,如下图Fig15(b),DSCNN是一个层级模型,LSTM学习句子向量表示,然后再输入到卷积层和池化层来生成文档表示。
3.10、Transformer预训练模型
Transformer借助self-attention并行机制在预训练模型大放异彩,预训练模型可分为自回归和自编码两种方式。预训练模型可以阅读我之前写的PTM[1](pre-trained models)综述
3.11、强化学习
强化学习训练一个代理根据策略来学习动作,使得最终的汇报最大化。那么强化学习是如何应用在文本中呢?Shen提出使用强化学习来决定哪些输入文本token参与模型输入进行分类任务。Zhang提出另一个方案来应用强化学习于文本分类中,他使用两个LSTM来实现,第一个LSTM是从文本中选择和任务相关重要的词,另一个LSTM是学习句子结构的。策略网络每一步决定使用哪个模型,策略网络使用策略梯度来进行更新。模型结构如下图所示:

3.12、小节
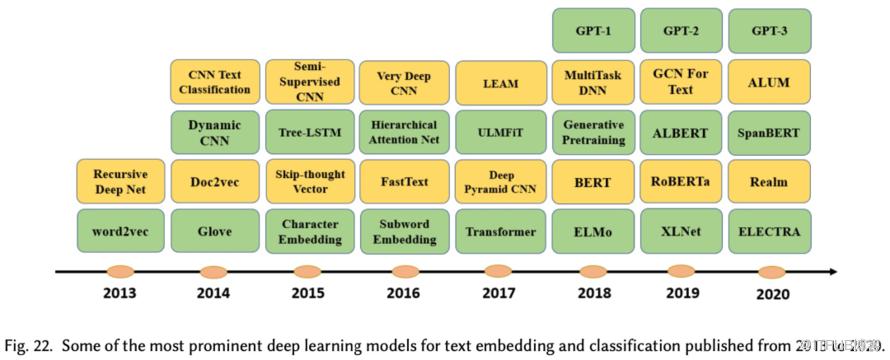
按时间顺序展示深度学习应用于文本分类的模型:
四、文本分类模型选择
上述分析了很多文本分类的模型,那么实际中应该如何选择模型呢?这取决于目标任务和域的性质、域内标签的可用性、应用程序的延迟和容量限制等。尽管毫无疑问,开发文本分类器是一个反复试验的过程,但通过分析公共基准测试(如GLUE)的最新结果,作者给出了如下五个步骤作为参考:
(1) PLM选择。使用PLMs可以显著改进所有流行的文本分类任务,并且自动编码PLMs(例如BERT或RoBERTa)通常比自回归PLMs(例如OpenAI-GPT)工作得更好。HuggingFace3维护着为各种任务和设置开发的PLM的丰富存储库。
(2) 域自适应。大多数plm都是在通用领域文本语料库(如Web)上训练的。如果目标域与一般域显著不同,我们可以考虑通过在所选择的通用域PLM中进行连续预训练来适应PLM在域数据中的使用。对于有大量未标记文本的领域,如生物医学,从头开始的预训练语言模型可能也是一个不错的选择。
(3) 任务特定模型设计。给定输入文本,PLM在上下文表示中产生一系列向量。然后,在顶部添加一个或多个特定于任务的层,以生成目标任务的最终输出。任务特定层结构的选择取决于任务的性质,例如,需要捕获文本的语言结构。如第2节所述,前馈神经网络将文本视为一个词包,RNN可以捕获词序,CNN擅长识别关键短语等模式,注意机制可以有效识别文本中的相关词,暹罗神经网络用于文本匹配任务,如果自然语言的图形结构(如解析树)对目标任务有用,GNNs是一个很好的选择。
(4) 特定于任务的微调。根据域内标签的可用性,任务特定层可以单独与PLM一起训练,也可以与PLM一起训练。如果需要构建多个相似的文本分类器(例如,不同域的新闻分类器),多任务微调是利用相似域的标记数据的好选择。
(5) 模型压缩。PLM的服务成本很高。为了满足实际应用中的延迟和容量限制,通常需要通过知识提取对它们进行压缩。
五、文本分类公开数据集
| sentiment alalysis |
News Classification |
Topic Classification |
QA |
NLI |
| Yelp |
AG News |
DBpedia |
SQuAD |
SNLI |
| IMDB |
20 Newsgroups |
Ohsumed |
MS MARCO |
Multi-NLI |
| Movie Review |
Sogou News |
EUR-Lex |
TREC-QA |
SICK |
| SST |
Reuters news |
WOS |
WikiQA |
MSRP |
| MPQA |
PubMed |
Quora |
||
| Amazon |
六、文本分类的挑战
6.1、更有挑战任务
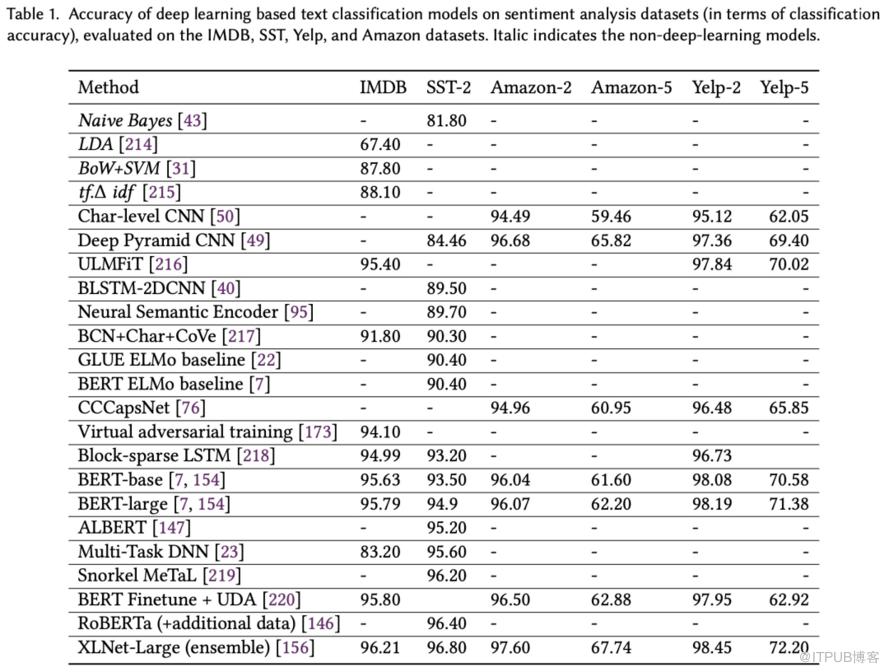
目前已经收集了大规模的通用的文本分类数据集,但是对于QA多步推理、多语言文本分类以及长文本的处理仍然不太理想,下面介绍一下不同模型在sentiment analysis数据集上的表现:
6.2、模型融入常识
将常识知识融入DL模型有可能显著提高模型性能,这与人类利用常识知识执行不同任务的方式几乎相同。例如,有常识知识库的QA系统可以回答关于真实世界的问题。常识也有助于解决信息不完整的问题。人工智能系统利用人们对日常事物或概念的广泛信仰,可以基于对未知事物的“默认”假设进行推理,就像人们所做的那样。尽管这一观点已被用于情感分类,在DL模型中如何有效地建模和使用常识知识,还需要进一步的研究。
6.3、可解释深度学习模型
深度学习模型在许多benchmark上表现都比较好,但是大部分的深度学习模型是不可解释的。例如:在一个数据集上,为什么这个模型超过一个模型,而没有超过另一个模型?深度学习模型学习到了什么?给定数据集,如何设计最小的神经网络来达到相关准确率?现在注意力机制表现比较好,但是依然缺少理论证实。
6.4、内存优化
大部分深度学习模型都需要大量的内存进行模型训练和推断,为了减少内存消耗,知识蒸馏技术被广泛应用,其实还有一些,比如量化、剪枝等等。
6.5、小样本学习
大部分的深度学习模型参数量都比较多,需要大量的数据来训练才有可能避免过拟合,但是有的任务获取标注样本的代价比较大。预训练模型在大规模数据上进行无监督学习后,再在任务上小数据集上fine-tuning是一种方案,其实我们可以考虑直接在小数据集上进行建模,这就是小样本学习。我之前写过一个小博客介绍过小样本学习,FSL(Few-Shot Learning)小样本学习
七、总结
作者对深度学习模型应用于文本分类任务上做了算法的分类,使得后续研究者有比较清晰的思路,更难得的是作者给出了做文本分类任务上模型选择的五步骤法则。作者提到的文本分类五个挑战,其实是整个人工智能的挑战,现在各个挑战都有所突破,我是非常看好的。
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
