百度提出跨模态文档理解模型 ERNIE-Layout,首次将布局知识增强技术融入跨模态文档预训练,在 4 项文档理解任务上刷新世界最好效果,登顶 DocVQA 榜首。同时,ERNIE-Layout 已集成至百度智能文档分析平台 TextMind,助力企业数字化升级。
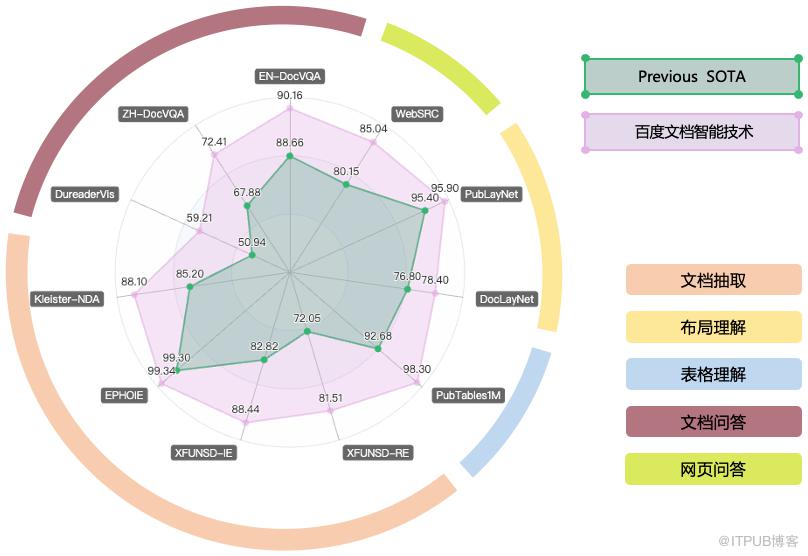
github地址:https://github.com/PaddlePaddle/PaddleNLP/tree/develop/applications/document_intelligence
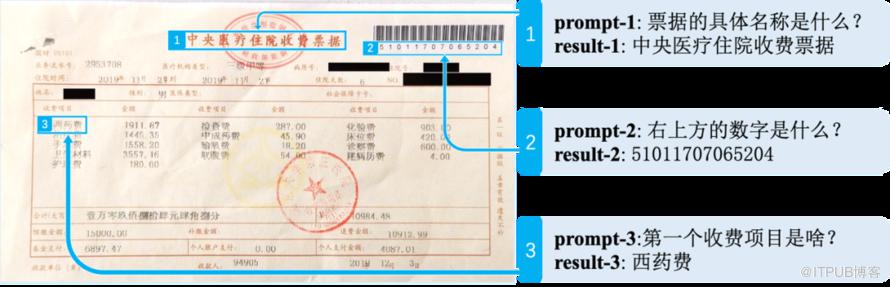
百度基于ERNIE-Layout开发了docPrompt,可以通过PaddleNLP Taskflow三行代码即可体验功能,如下所示:
from paddlenlp import Taskflowdocprompt = Taskflow("document_intelligence", model='docprompt')docprompt({"doc": "./invoice.jpg", "prompts": ["票据的具体名称是什么?", "右上方的数字是什么?", "第一个收费项目是啥?"]})
核心创新点:
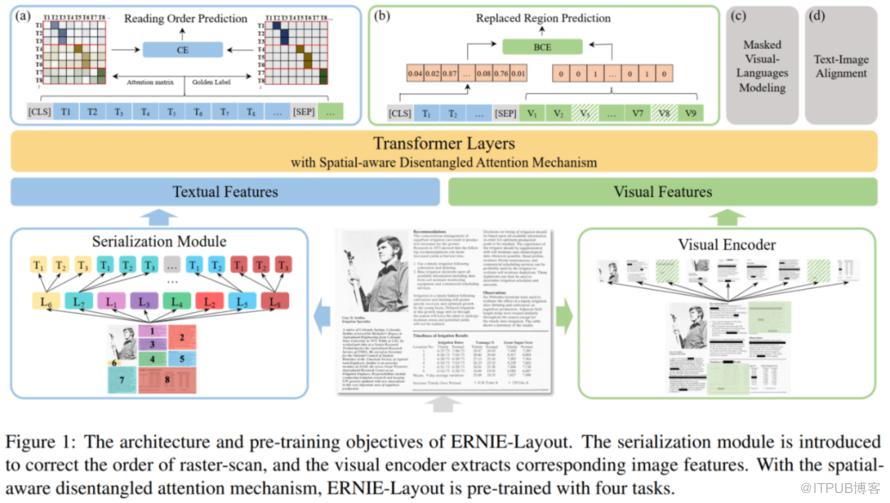
引入了布局知识增强,融合文本、图像、布局等信息进行跨模态联合建模;
提出阅读顺序预测、细粒度图文匹配等自监督预训练任务,升级空间解耦注意力机制;
ERNIE-Layout架构图如下所示:
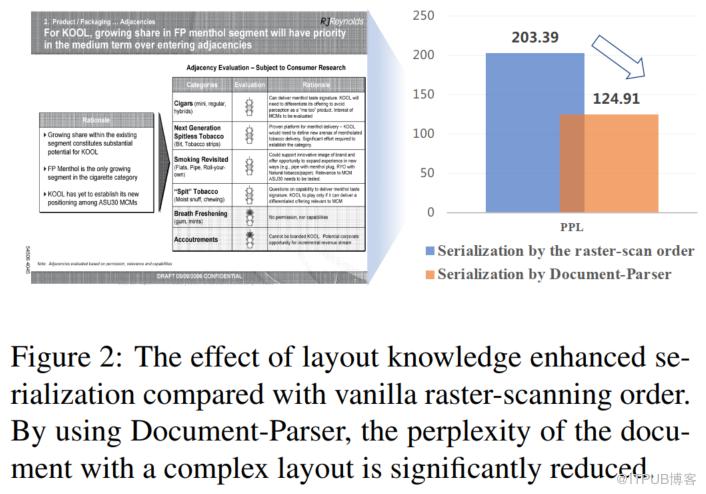
创新性的使用了Layout-Parser(https://github.com/Layout-Parser/layout-parser)进行文档解析,从Figure2可以看出,效果由于OCR tools的识别结果
模型输入:
Text Embedding
在输入文本前后分别加入特殊token [CLS]和[SEP],文本的embedding主要有token embedding,1D position embedding和token type embedding求和得到
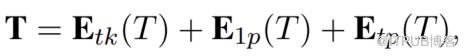
Visual Embedding
视觉部分使用Faster-RCNN作为backbone,文档图像大小归一化到224x224,输出一个固定大小的feature map,然后通过线性转换成与text embedding大小一样,最终visual embedding,1D position embedding和token type embedding求和
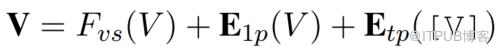
Layout Embedding
使用OCR tools得到每个token的坐标位置,包括横坐标和纵坐标,然后分别进行embedding提取,如下
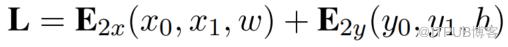
最终的embedding是Text embedding和Visual embedding分别加上自己的Layout embedding再concate起来
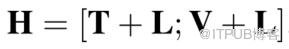
预训练任务:
Reading Order Prediction(ROP): 阅读顺序任务主要是在注意力矩阵的基础上增加了一个0-1矩阵G,该0-1矩阵主要是说明书前后两个token是否符合阅读顺序,损失函数如下所示:
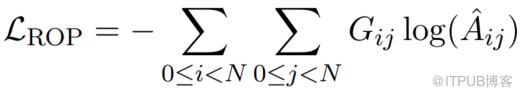
Replaced Region Prediction(RRP): 图像中10%的patch被随机删除或者被其他patch进行替换,然后进行预测是否被替换,损失函数如下所示:
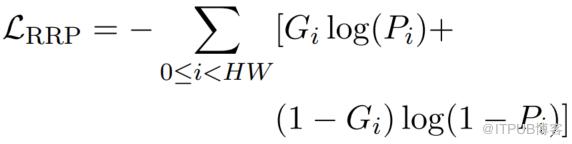
G表示golden label,P表示predict label
Masked Visual-Language Modeling(MVLM): 这个类似BERT中的MLM;
Text-Image Alignment(TIA): 该任务主要解决图文细粒度匹配问题,随机选择几行文本,然后把他们对应的图像遮挡,最后增加一个分类layer来判断每个文本token是否被遮挡
最终损失函数对上述四种预训练任务进行求和,公式如下:
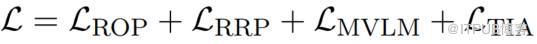
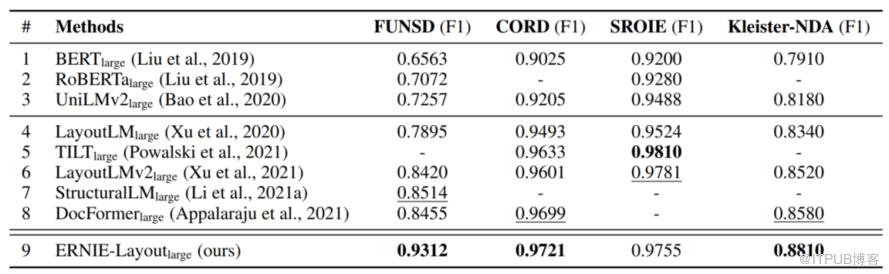
从以上实验看出,效果非常nice
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
