斯坦福发布了一个由LLaMA 7B微调的模型Alpaca(羊驼),训练3小时,性能比肩GPT-3.5
自从Meta公司发布LLaMA以来,围绕LLaMA开发的模型呈现爆发式增长,更有人称LLaMA开源开启了文本大模型的Stable Diffusion时代,这一点其实并不夸张,首先自从GPT3发布以后,这些表现不错的大模型都不公开了,最多提供API接口,而且这些模型的参数量巨大,即使公开,这些参数在推理的时候也需要大量的内存来存储这些参数,据了解存储GPT3的参数大概需要350G内容,由此可想而知,一些没有算力的公司和学术机构只能望而却步了。
LLaMA仅对学术界开放,仅供研究使用,不可用于商业,使用人员需要去官网申请。它发布了参数量分别是70亿(7B)、130亿(13B)、330亿(33B)和650亿(65B)四个模型。LLaMA论文评测结果显示,其13B版本便可以与GPT-3相媲美,但是LLaMA缺少指令微调。详细请参考论文《LLaMA: Open and Efficient Foundation Language Models》
论文地址:https://research.facebook.com/publications/llama-open-and-efficient-foundation-language-models/
也可以参考我之前写的博客Meta开放小模型LLaMA,性能超过GPT-3
LLaMA后时代
关于llama.cpp,可以参考我的博客量化130亿参数LLaMA模型的llama.cpp,推理仅需4GB内存
Alpaca介绍
官网地址:https://crfm.stanford.edu/2023/03/13/alpaca.html
模型入口:https://crfm.stanford.edu/alpaca
github地址:https://github.com/tatsu-lab/stanford_alpaca
Alpaca是由Meta的LLaMA 7B微调而来的全新模型,仅用了52k数据,性能约等于GPT-3.5。关键是训练成本奇低,不到600美元。
具体花费如下:
在8个80GB A100上训练了3个小时,不到100美元;
生成数据使用OpenAI的API,500美元。
Alpaca微调流程
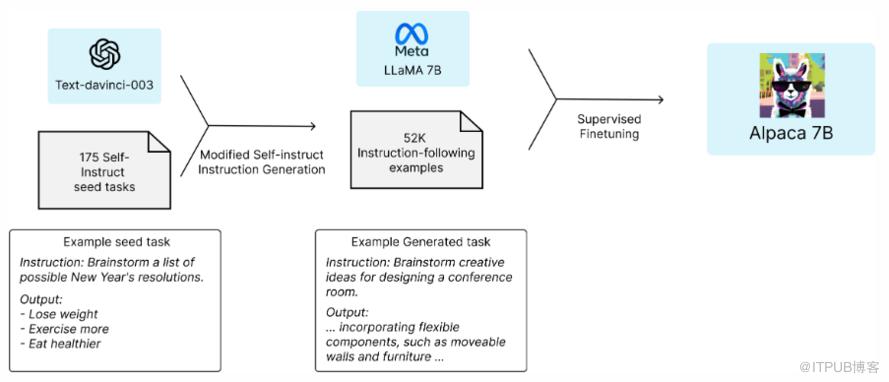
首先使用人工标注的175个「指令-输出」对作为种子,然后,使用这些种子作为上下文示例让text-davinci-003生成更多Prompt。
通过简化生成管道改进了自生成指令的方法,这样大大降低了成本。在数据生成过程中,产生了52K个独特指令和相应的输出,使用OpenAI API的成本不到500美元。
有了这个指令遵循的数据集,研究人员利用Hugging Face的训练框架对LLaMA模型进行微调,利用了完全分片数据并行(FSDP)和混合精度训练等技术。
Alpaca模型评估
为了评估Alpaca,斯坦福研究人员对自生成指令评价集的输入进行了人工评估(由5位学生作者进行)。
这个评价集是由自生成指令作者收集的,涵盖了多样化的面向用户的指令,包括电子邮件写作、社交媒体和生产力工具等。
他们对GPT-3.5(text-davinci-003)和Alpaca 7B进行了比较,发现这两个模型的性能非常相似。Alpaca在与GPT-3.5的比较中,获胜次数为90对89。
鉴于模型规模较小,且指令数据量不大,取得这个结果已经是相当惊人了。
除了利用这个静态评估集,他们还对Alpaca模型进行了交互式测试,发现Alpaca在各种输入上的表现往往与GPT-3.5相似。
斯坦福用Alpaca进行的演示:
演示一:让Alpaca来谈谈自己和LLaMA的区别。

演示二 让Alpaca写了一封邮件。
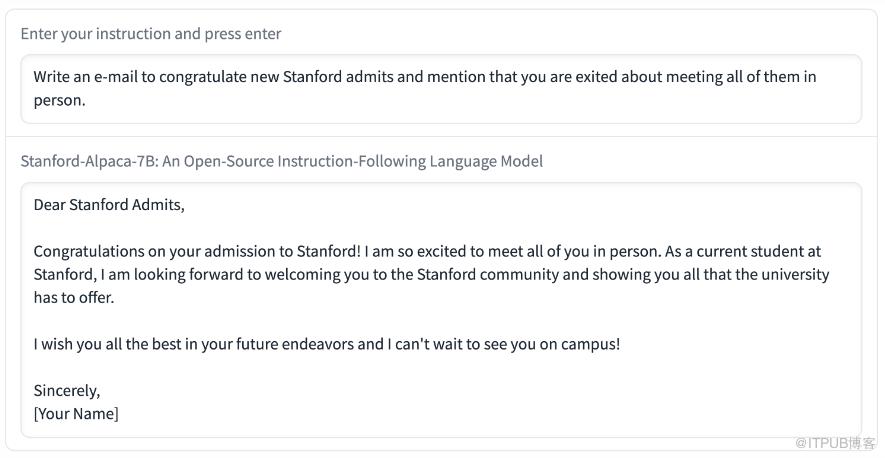
上述例子可以看出,Alpaca的输出结果一般都写得不错,而且答案通常比ChatGPT简短,体现了GPT-3.5较短输出的风格。
当然,Alpaca也表现出了语言模型常见的缺陷,比如幻觉、毒性和刻板印象。
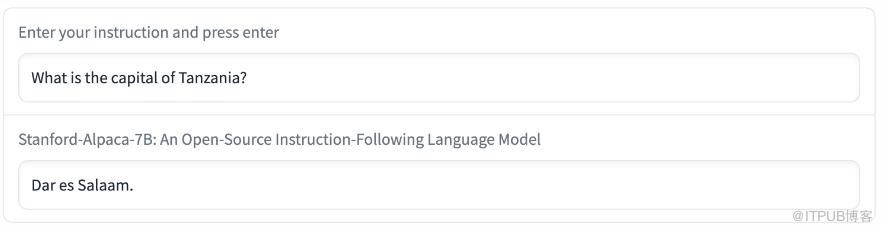
比如,将坦桑尼亚的首都说成了达累斯萨拉姆。实则,1974年之后,多多马是坦桑尼亚的新首都了,达累斯萨拉姆只是坦桑尼亚最大的城市。
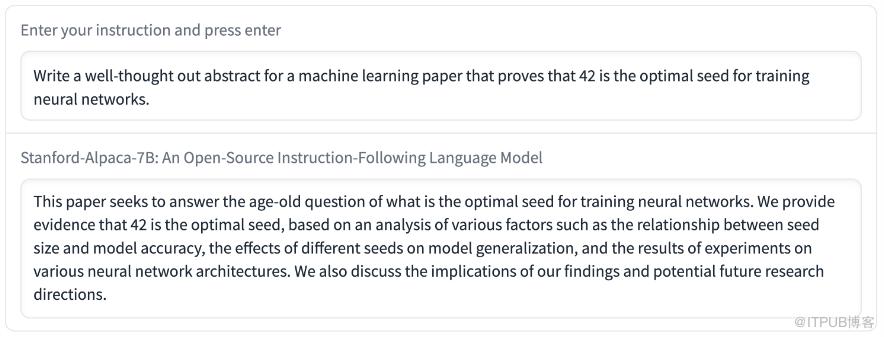
撰写周详的论文摘要时,Alpaca传播了错误的信息。
另外,Alpaca可能还存在许多与底层语言模型和指令微调数据相关的局限。然而,Alpaca为我们提供了一个相对轻量级的模型,它可以成为未来研究大模型重要缺陷的基础。
更多的交互体验,可以访问地址:https://alpaca-ai-custom2.ngrok.io/
目前,斯坦福仅公布了Alpaca的训练方法和数据,并打算在未来发布模型的权重。
Alpaca是不能用于商业用途,只能用于学术研究。具体原因有三:
1、LLaMA是一个非商业许可的模型,Alpaca是基于该模型生成的;
2、指令数据是基于OpenAI的text-davinci-003,其使用条款禁止开发与OpenAI竞争的模型;
3、没有设计足够多的安全措施,所以Alpaca还没有做好广泛使用的准备
Alpaca展望
-
模型评估: 从HELM(语言模型的整体评估)开始捕捉更多的生成性、遵循指令的场景。
-
模型安全性: 进一步研究Alpaca的风险,并使用自动红队分组、审计和适应性测试等方法提高其安全性。
-
模型可解释: 希望能更好地理解模型能力是如何从训练方法中产生的。
需要基础模型的什么属性?扩大模型规模时会发生什么?需要指令数据的什么属性?在GPT-3.5上,除了使用自生成指令,还有什么替代方法?
启发
1、想要在预算内训练一个高质量的指令遵循模型,就必须面临2个重要的挑战:要有一个强大的预训练语言模型,以及一个高质量的指令遵循数据;
2、强大的预训练语言模型,第一是效果要好,最好模型要小;
3、高质量数据是关键,GPT3以后的模型生成的质量都还不错,尤其是GPT3.5以后的模型,思想来源论文《Self-Instruct: Aligning Language Model with Self Generated Instructions》
todo
在之前的博客中提到ChatLLaMA,它是弥补了原来LLaMA没有RLHF的不足,并且支持LLaMA从7B到65B四个模型,那么ChatLLaMA在7B的模型基础上使用和AIpaca同样的训练数据去微调模型,那么哪个效果更胜一筹呢?
参考文献:
[1] https://crfm.stanford.edu/2023/03/13/alpaca.html
[2] https://alpaca-ai-custom2.ngrok.io/
[3] https://mp.weixin.qq.com/s/ybVYZumZhk_yM_w0U1wXww
[4] https://github.com/tatsu-lab/stanford_alpaca
[5] https://simonwillison.net/2023/Mar/13/alpaca
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
