自从Meta公司发布LLaMA以来,围绕它微调和开发的模型越来越多,这得益于它的性能和效果,2023年3月份发布的草泥马(Alpaca)是由Meta的LLaMA 7B微调而来的全新模型,仅用了52k数据,性能约等于GPT-3.5。斯坦福发布了一个由LLaMA 7B微调的模型Alpaca(羊驼),训练3小时,性能比肩GPT-3.5
最近,UC伯克利学者联手CMU、斯坦福等,再次推出一个全新模型——130亿参数的Vicuna,俗称「小羊驼」(骆马)。


代码:https://github.com/lm-sys/FastChat
在线体验地址:https://chat.lmsys.org/
Vicuna介绍
Vicuna目前已经发布了两个版本:Vicuna-13B和Vicuna-7B.
Vicuna-13B是一款开源聊天机器人,通过对从ShareGPT(目前已禁止爬取)收集的用户70K共享对话进行LLaMA微调来训练。使用GPT-4作为评判标准的初步评估显示,Vicuna-13B在OpenAI ChatGPT和Google Bard的质量方面达到了90%以上,而在90%以上的情况下优于LLaMA和Stanford Alpaca等其他模型。训练Vicuna-13B的费用约为300美元。
模型的整理架构如下图2所示:
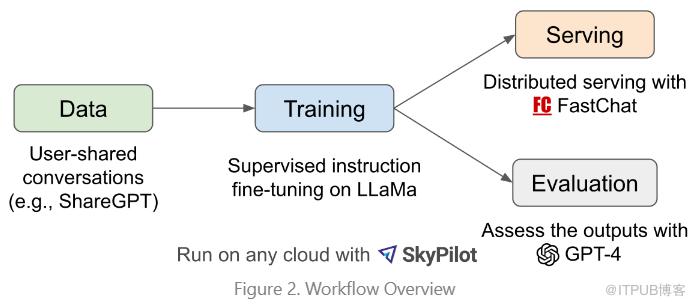
首先,研究人员从ChatGPT对话分享网站ShareGPT上,收集了大约70K对话;
接下来,研究人员优化了Alpaca提供的训练脚本,使模型能够更好地处理多轮对话和长序列;
之后利用PyTorch FSDP在8个A100 GPU上进行了一天的训练;
Alpaca VS Vicuna
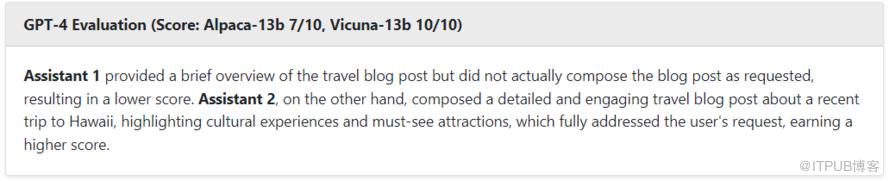
Vicuna的效果到底如何呢?下面使用一个测试案例进行对比,并且使用GPT-4进行评估。
问:写一篇关于最近去夏威夷旅行的有趣的旅游博客文章,强调文化体验和必看景点。
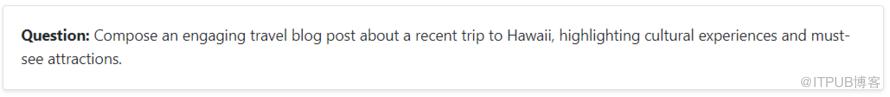
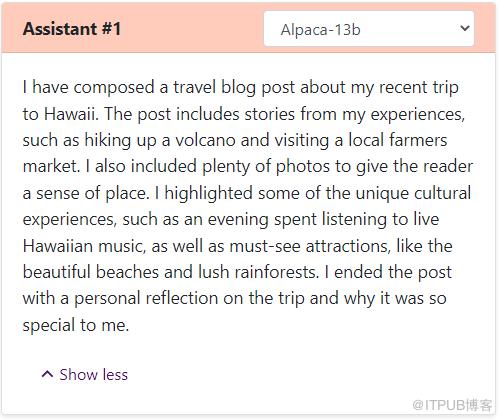
Alpaca的回答可以说是一个浓缩版,短短几行就写完了,没有按照要求完成任务。它仅是提到了自己写了一篇博客,并对博客内容做了一个概述。
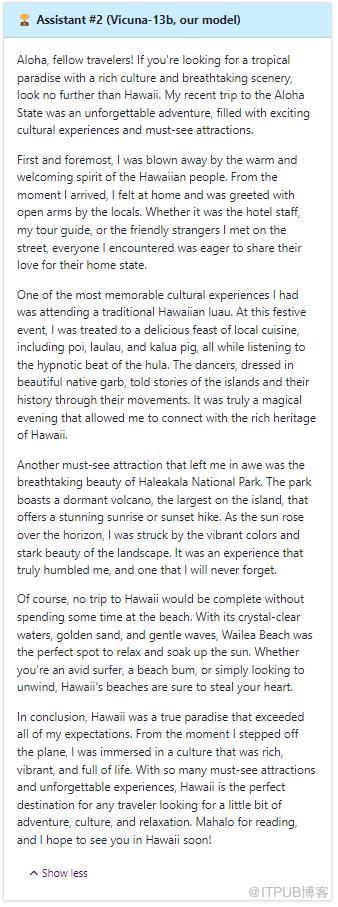
然而Vicuna撰写了一篇详细且引人入胜的旅行博客文章,不仅内容有趣,还详细地介绍了夏威夷的文化体验和必看景点。
Vicuna模型训练
内存优化:
多轮对话:
通过Spot实例降低成本:
Vicuna模型评估
评估AI聊天机器人是一项具有挑战性的任务,因为它需要检查语言理解、推理和上下文意识。随着AI聊天机器人变得越来越先进,现有的开放基准可能不再足够。例如,斯坦福Alpaca中使用的评估数据集self-instruct,可以被SOTA聊天机器人有效地回答,这使得人类难以分辨性能差异。更多的限制包括训练/测试数据污染和创建新基准的潜在高成本。为了解决这些问题,研究人员提出了一个基于GPT-4的评估框架,从而实现对聊天机器人性能的自动评估。
首先,通过精心设计的提示,让GPT-4能够生成多样化且具有挑战性的问题。并利用8个不同类别共80道题,如角色扮演、编码/数学任务等,来测试这些模型(LLaMA、Alpaca、ChatGPT、Bard和Vicuna)在不同领域上表现出的性能。然后,研究人员要求GPT-4根据帮助程度、相关性、准确性和细节对答案的质量进行评分。结果显示,GPT-4不仅可以产生相对一致的分数,还可以提供详细的解释来说明为什么给出这样的分数。但是,GPT-4并不擅长评判编码/数学任务。
基于GPT-4的初步评估,如图1所示,表明Vicuna达到了Bard/ChatGPT的90%的能力。
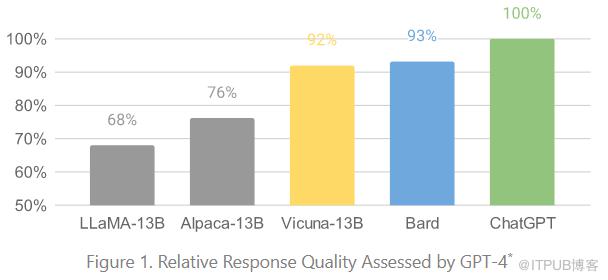
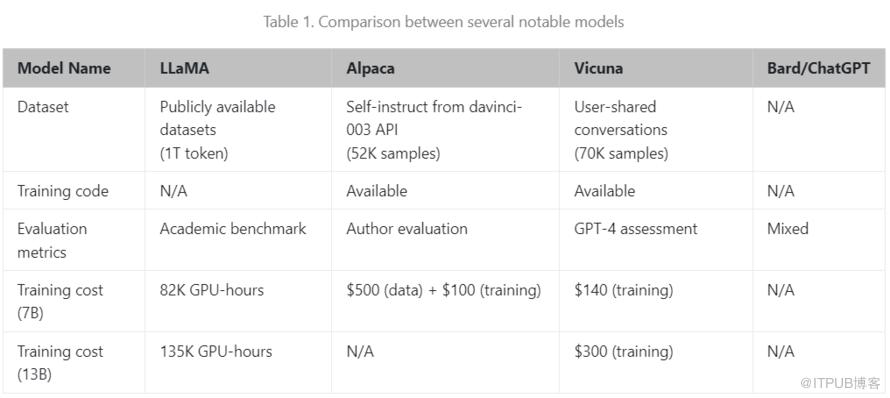
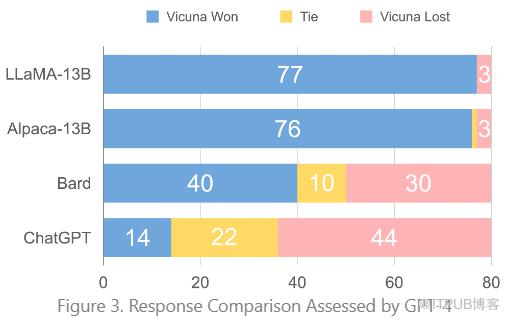
图3显示了所有baselines 和Vicuna之间的比较结果。在90%以上的问题中,GPT-4更喜欢Vicuna,而不是最先进的开源模型(LLaMA、Alpaca),并且它实现了与专有模型(ChatGPT、Bard)相比具有竞争力的性能。在45%的问题中,GPT-4认为Vicuna的回答优于或等于ChatGPT的回答。由于GPT-4以10为尺度为每个回答分配定量分数,我们通过将每个模型在80个问题上获得的分数相加来计算每个(基线,Vicuna)比较对的总分。如表2所示,Vicuna的总分为ChatGPT的92%。尽管最近取得了进步,但这些聊天机器人仍然面临着局限性,例如难以解决基本的数学问题或编码能力有限。

Vicuna模型局限性
研究人员指出,与其他大语言模型类似,Vicuna也存在着一定的局限性。比如,Vicuna在涉及编程、推理、数学以及事实准确性的任务上表现不佳。此外,它也没有经过充分优化以保证安全性或减轻潜在的毒性或偏见。为解决安全方面的问题,研究人员在demo中采用了OpenAI的审查API来过滤掉不适当的用户输入。
怎么使用Vicuna
安装
方法一:使用pip安装
# Install FastChatpip3 install fschat# Install the latest main branch of huggingface/transformerspip3 install git+https://github.com/huggingface/transformers
方法二:从源码安装
git clone https://github.com/lm-sys/FastChat.gitcd FastChat# mac使用如下安装命令,否则跳过此行代码brew install rust cmake# 安装包pip3 install --upgrade pip # enable PEP 660 supportpip3 install -e .
获取模型权重
根据LLaMA模型的许可,权重将以delta的形式发布。只需将其加到原来的LLaMA权重上,就可以获得最终的Vicuna权重。
1. 按照huggingface上的说明,获得原始的LLaMA权重
2. 通过脚本,自动从团队的Hugging Face账户上下载delta权重
# 大约 60 GB 的 CPU RAM 如果内存不足,可以创建一个大型交换文件,# 使操作系统能够自动将磁盘用作虚拟内存。python3 -m fastchat.model.apply_delta \--base /path/to/llama-13b \--target /output/path/to/vicuna-13b \--delta lmsys/vicuna-13b-delta-v0
# 大约 30 GB 的 CPU RAM 如果内存不足,可以创建一个大型交换文件,# 使操作系统能够自动将磁盘用作虚拟内存。python3 -m fastchat.model.apply_delta \--base /path/to/llama-7b \--target /output/path/to/vicuna-7b \--delta lmsys/vicuna-7b-delta-v0
python3 -m fastchat.serve.cli --model-name /path/to/vicuna/weightspython3 -m fastchat.serve.cli --model-name /path/to/vicuna/weights --num-gpus 2python3 -m fastchat.serve.cli --model-name /path/to/vicuna/weights --device cpupython3 -m fastchat.serve.cli --model-name /path/to/vicuna/weights --device mps --load-8bit启动WEB UI
使用web UI提供服务,需要三个主要组件:1)与用户接口的web服务器;2)托管一个或多个模型的模型worker;3)协调web服务器和模型worker的控制器。操作步骤如下:
python3 -m fastchat.serve.controller
· 启动model worker
python3 -m fastchat.serve.model_worker --model-path /path/to/vicuna/weights当进程完成模型的加载后,会看到「Uvicorn running on ...」。
· 发送测试消息
python3 -m fastchat.serve.test_message --model-name vicuna-13bpython3 -m fastchat.serve.gradio_web_server现在,就可以打开浏览器和模型聊天了。 模型微调
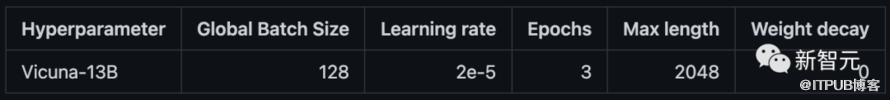
# Install skypilot from the master branchpip install git+https://github.com/skypilot-org/skypilot.git
sky launch -c vicuna -s scripts/train-vicuna.yaml --env WANDB_API_KEY
sky launch -c alpaca -s scripts/train-alpaca.yaml --env WANDB_API_KEY· 使用本地GPU进行微调
torchrun --nnodes=1 --nproc_per_node=8 --master_port=<your_random_port> \fastchat/train/train_mem.py \--model_name_or_path <path-to-llama-model-weight> \--data_path <path-to-data> \--bf16 True \--output_dir ./checkpoints \--num_train_epochs 3 \--per_device_train_batch_size 4 \--per_device_eval_batch_size 4 \--gradient_accumulation_steps 1 \--evaluation_strategy "no" \--save_strategy "steps" \--save_steps 1200 \--save_total_limit 100 \--learning_rate 2e-5 \--weight_decay 0. \--warmup_ratio 0.03 \--lr_scheduler_type "cosine" \--logging_steps 1 \--fsdp "full_shard auto_wrap" \--fsdp_transformer_layer_cls_to_wrap 'LlamaDecoderLayer' \--tf32 True \--model_max_length 2048 \--gradient_checkpointing True \--lazy_preprocess True
使用GPT-4进行评估,参考文档:https://github.com/lm-sys/FastChat/blob/main/fastchat/eval
评估步骤如下:
Step1:从不同的模型生成答案:对于ChatGPT或者特定的checkpoint运行qa_baseline_gpt35.py;对于Vicuna 或者其他模型,运行get_model_answer.py
Step2:使用GPT-4生成review结果;
Step3:生成可视化数据:运行generate_webpage_data_from_table.py生成数据的统计结果;
Step4:可视化数据:在webpage目录下运行命令python3 -m http.server启动静态服务;
评估数据格式是JSON格式,具体参考:
[1] https://github.com/lm-sys/FastChat/blob/main/fastchat/eval/table
[2] https://github.com/lm-sys/FastChat/blob/main/fastchat/eval
参考文献:
[1] https://vicuna.lmsys.org/
原文作者:ArronAI;如有侵权,请联系管理员删除。

最新文章
- LLM之RAG实战(四十三)| 使用模型监控pipeline构建端到端RAG Pipeline
- MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL
- MLLM(一)| 文/图生视频任务大升级,BigModel 开源了视频模型CogVideoX
- LLM之RAG理论(十二)| RAG和Graph RAG对比
- LLM之RAG实战(四十二)| 如何在LlamaIndex和LangChain中正确选择RAG开发框架
- LLM之Prompt(四)| OpenAI、微软发布Prompt技术报告
- LLM漫谈(七)| 使用PyTorch从零构建LLM
- LLM之RAG实战(四十)| 使用LangChain SQL Agent和MySQL搭建多层RAG ChatBot
- LLM之RAG实战(三十九)| 高级RAG技术全面解析(附代码)
- LLM之RAG理论(十一)| 面向生产的RAG应用程序的12种调整策略指南
