虾皮(Shopee)商品详情数据接口详解
虾皮(Shopee)是东南亚及台湾地区领先的电子商务平台,为卖家和买家提供了一个充满活力的市场。对于希望自动化商品信息获取、进行数据分析或集成到自身系统的开发者来说,虾皮提供的商品详情数据接口是一项关键功能。本文将介绍如何使用虾皮提供的API(如果可用)或通过网页爬虫技术来获取商品详情数据,并附上示例代码。
注意:虾皮官方API可能受到访问限制、认证要求及商业协议的影响,且并非所有功能都通过公开API提供。以下示例将侧重于网页爬虫技术,因为这在没有直接API访问权限时是一种常见的解决方案。然而,使用爬虫技术需要遵守虾皮的爬虫政策和服务条款。
网页爬虫方法
由于虾皮可能不提供直接的商品详情数据接口(API),我们可以使用网页爬虫技术从虾皮的网页版中提取所需信息。这里将使用Python的requests和BeautifulSoup库来演示。
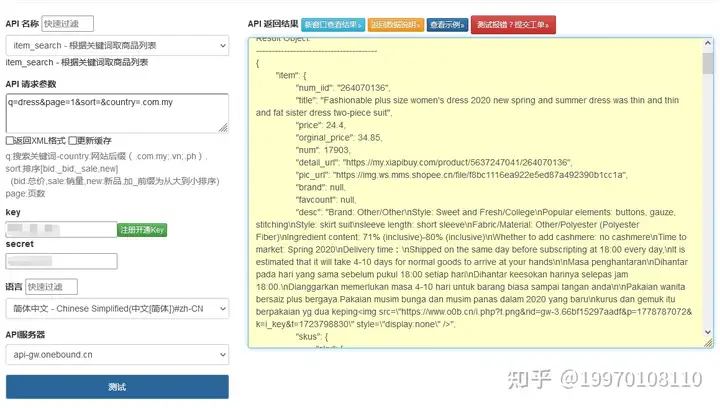
准备工作
首先,你需要安装requests和beautifulsoup4库。可以使用pip来安装:
bash
pip install requests beautifulsoup4
示例代码
以下是一个使用Python爬虫获取虾皮商品详情的示例代码。请注意,由于虾皮网页结构的动态性和可能的变化,以下代码可能需要根据实际情况进行调整。
python
import requests
from bs4 import BeautifulSoup
def fetch_shopee_product_details(product_url):
# 发送HTTP GET请求
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
}
response = requests.get(product_url, headers=headers)
# 检查请求是否成功
if response.status_code == 200:
# 使用BeautifulSoup解析HTML
soup = BeautifulSoup(response.text, 'html.parser')
# 这里假设商品名称位于<title>标签中,实际情况可能不同
title_tag = soup.title
product_name = title_tag.string if title_tag.string else "商品名称未找到"
# 假设商品价格位于特定的class中,如"price"
# 注意:实际类名可能不同,需要查看网页源码确定
price_tag = soup.find('div', class_='price') # 示例类名,实际可能不同
product_price = price_tag.text.strip() if price_tag else "价格未找到"
# 打印商品名称和价格
print(f"商品名称: {product_name}")
print(f"商品价格: {product_price}")
# 可以继续解析其他商品详情信息
else:
print(f"请求失败,状态码:{response.status_code}")
# 示例商品URL(请替换为实际商品URL)
product_url = " It looks like something is missing!"
# 调用函数
fetch_shopee_product_details(product_url)
注意事项
遵守爬虫政策:在使用爬虫技术时,请确保遵守虾皮的爬虫政策和服务条款,避免对虾皮服务器造成不必要的负担或数据滥用。
动态内容处理:虾皮网页可能包含大量动态加载的内容,这可能需要使用如Selenium等工具来模拟浏览器行为。
反爬虫机制:虾皮可能采取了反爬虫机制,如验证码、请求频率限制等,需要开发者进行相应的处理。
数据解析:由于网页结构可能随时变化,因此数据解析部分(如使用BeautifulSoup查找特定元素)可能需要频繁更新。
结论
虽然本文没有直接提供虾皮官方的商品详情数据接口API,但展示了如何使用网页爬虫技术来获取所需信息。对于需要直接API访问的情况,建议联系虾皮官方或查阅其开发者文档以获取更多信息。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70040568/viewspace-3025246/ ,如需转载,请注明出处,否则将追究法律责任。

