步骤1:准备环境
1.云服务器环境
| 内网IP | 主机名 | 功能 |
| 10.*.*.127 | master |
NameNode secondaryNameNode DataNode |
| 10.*.*.118 | slave1 | DataNode |
| 10.*.*.96 | slave2 | DataNode |
2.配置CentOS
设置主机名称:(三台机器都需要进行操作)
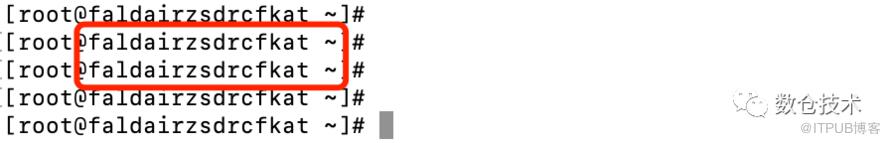
设置主机名称为master,slave1这种名称,不设置不影响使用,但是看起来类似下面这个样子:
在master机器上执行:
hostnamectl set-hostname master执行完成后重新登陆即可看到更新后的主机名
同样在slave1服务器执行:
hostnamectl set-hostname slave1在slave2服务器执行:
hostnamectl set-hostname slave2配置hosts:(三台机器都需要进行操作)
vi /etc/hosts在文件中添加各个服务器内网IP和名称映射:
注意:云服务安装时,一定要使用内网IP,使用外网IPNameNode无法启动!!!
注意:云服务安装时,一定要使用内网IP,使用外网IPNameNode无法启动!!!
注意:云服务安装时,一定要使用内网IP,使用外网IPNameNode无法启动!!!
10.*.*.127 master10.*.*.118 slave110.*.*.96 slave2
关闭防火墙(三台机器都需要进行操作)
systemctl status firewalld.service //检查防火墙状态systemctl stop firewalld.service //关闭防火墙systemctl disable firewalld.service //禁止开机启动防火墙
3.安装JDK
安装配置 JDK(master操作)
下载jdk包(免费的,注册一个oracle账号即可)
官方地址:https://www.oracle.com/java/technologies/downloads/#license-lightbox
将JDK安装包放到root目录,新建文件夹,并把jdk解压到新文件夹下。
mkdir /usr/javatar -zxvf jdk-8u361-linux-x64.tar.gz -C /usr/java/rm -rf jdk-8u361-linux-x64.tar.gz
各个主机之间复制 JDK(master操作)
scp -r /usr/java slave1:/usrscp -r /usr/java slave2:/usr
配置各个主机 JDK 环境变量(三台机器都需要进行操作)
vi /etc/profile最下方添加内容
export JAVA_HOME=/usr/java/jdk1.8.0_361export PATH=$JAVA_HOME/bin:$PATHexport CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
保存退出后,更新配置文件
source/etc/profile之后执行下面命令显示Java版本代表安装成功
java -version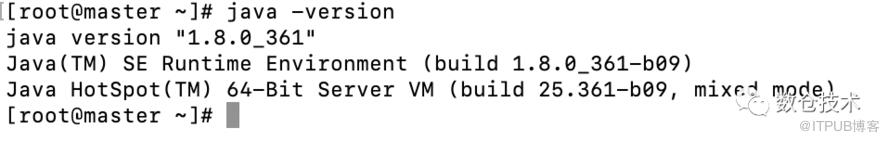
4.配置无秘钥访问
配置SSH无秘钥访问
分别在各个主机上生成密钥(三台机器都需要进行操作):
ssh-keygen -t rsaslave1:
cp ~/.ssh/id_rsa.pub ~/.ssh/slave1.id_rsa.pubscp ~/.ssh/slave1.id_rsa.pub master:~/.ssh
slave2:
cp ~/.ssh/id_rsa.pub ~/.ssh/slave2.id_rsa.pubscp ~/.ssh/slave2.id_rsa.pub master:~/.ssh
master:
cd ~/.sshcat id_rsa.pub >> authorized_keyscat slave1.id_rsa.pub >>authorized_keyscat slave2.id_rsa.pub >>authorized_keysscp authorized_keys slave1:~/.sshscp authorized_keys slave2:~/.sshrm -rf slave1.id_rsa.pubrm -rf slave2.id_rsa.pub
步骤2:安装配置 Hadoop
1.安装hadoop(仅master执行,设置完成后复制到其他服务器)
安装包下载地址:https://dlcdn.apache.org/hadoop/common/hadoop-2.10.2/hadoop-2.10.2.tar.gz
先将安装包上传到root目录下,然后进行解压安装
tar -zxvf hadoop-2.10.2.tar.gz -C /usrrm -rf hadoop-2.10.2.tar.gzmkdir /usr/hadoop-2.10.2/tmpmkdir /usr/hadoop-2.10.2/logsmkdir /usr/hadoop-2.10.2/hdfmkdir /usr/hadoop-2.10.2/hdf/datamkdir /usr/hadoop-2.10.2/hdf/name
2.配置 Hadoop
进入配置文件所在的文件夹
cd /usr/hadoop-2.10.2/etc/hadoopa.修改hadoop-env.sh文件,增加JAVA_HOME配置
export JAVA_HOME=/usr/java/jdk1.8.0_361b.修改 yarn-env.sh,增加JAVA_HOME配置
export JAVA_HOME=/usr/java/jdk1.8.0_361c.修改slaves,删除原来的localhost,改为一下内容:
masterslave1slave2
d.修改core-site.xml
<configuration><property><name>fs.default.name</name><value>hdfs://master:9000</value></property><property><name>hadoop.tmp.dir</name><value>file:/usr/hadoop-2.10.2/tmp</value></property></configuration>
e.修改hdfs-site.xml
<configuration><property><name>dfs.datanode.data.dir</name><value>/usr/hadoop-2.10.2/hdf/data</value><final>true</final></property><property><name>dfs.namenode.name.dir</name><value>/usr/hadoop-2.10.2/hdf/name</value><final>true</final></property></configuration>
f.从mapred-site.xml.template复制一个mapred-site.xml文件,然后修改mapred-site.xml
cp mapred-site.xml.template mapred-site.xml<configuration><property><name>mapreduce.framework.name</name><value>yarn</value></property><property><name>mapreduce.jobhistory.address</name><value>master:10020</value></property><property><name>mapreduce.jobhistory.webapp.address</name><value>master:19888</value></property></configuration>
g.修改yarn-site.xml
<configuration><property><name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name><value>org.apache.mapred.ShuffleHandler</value></property><property><name>yarn.nodemanager.aux-services</name><value>mapreduce_shuffle</value></property><property><name>yarn.resourcemanager.address</name><value>master:8032</value></property><property><name>yarn.resourcemanager.scheduler.address</name><value>master:8030</value></property><property><name>yarn.resourcemanager.resource-tracker.address</name><value>master:8031</value></property><property><name>yarn.resourcemanager.admin.address</name><value>master:8033</value></property><property><name>yarn.resourcemanager.webapp.address</name><value>master:8088</value></property></configuration>
h.各个主机之间复制 Hadoop
scp -r /usr/hadoop-2.10.2 slave1:/usrscp -r /usr/hadoop-2.10.2 slave2:/usr
i.各个主机配置 Hadoop 环境变量(三台服务器执行)
vi /etc/profile在下面添加配置内容
export HADOOP_HOME=/usr/hadoop-2.10.2export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATHexport HADOOP_LOG_DIR=/usr/hadoop-2.10.2/logsexport YARN_LOG_DIR=$HADOOP_LOG_DIR
使配置文件生效
source /etc/profile3.启动hadoop(仅master操作)
1.格式化 namenode
cd /usr/hadoop-2.10.2/sbinhdfs namenode -format
2.启动
cd /usr/hadoop-2.10.2/sbinstart-all.sh
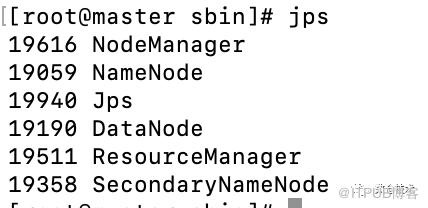
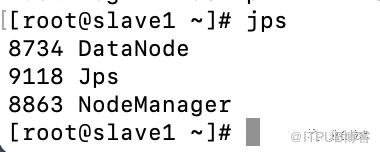
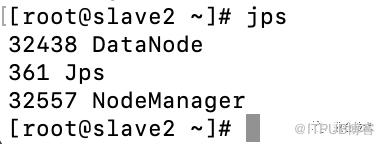
3.检查进程(三台机器各自执行查看)
master结果:
slave1:
slave2:
4.查看
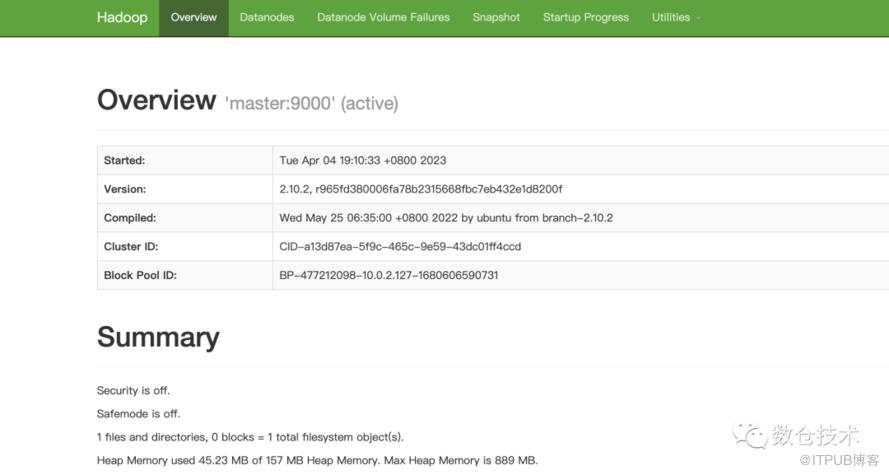
原文作者:数据仓库技术;如有侵权,请联系管理员删除。

