大模型占用显存的大头主要分为四部分:模型参数、前向计算过程中产生的中间激活、后向传递计算得到的梯度、优化器状态。训练大模型时通常会采用AdamW优化器,并用混合精度训练来加速训练,基于这个前提分析显存占用。
根据经验和粗略估计,一般参数量为1X的大模型,全参数训练/微调占用显存约为8X bytes,推理所需显存约为2X bytes。
大模型显存消耗主要环节
参考:大模型消耗的显存简介[1]
在详细说明大模型需要消耗的显存大小之前我们需要先明确几个概念。
一个就是大模型在不同阶段对显存的消耗是不同的。但是大致可以分为三个阶段或者说三个场景。即大模型预训练阶段、大模型微调阶段和大模型推理阶段。
1. 训练阶段:
• 选择大规模数据集是为了让模型学习到更丰富的知识表征,提高泛化能力。
• 使用大批量训练可以提高训练效率,但需要更多的GPU显存。
• 使用32位浮点数训练可以获得更高的数值精度,但也会消耗更多的显存。
2. 微调阶段:
• 冻结大部分参数可以大幅减少需要训练的参数量,从而降低计算和显存需求。
• 使用少量高质量数据集和各种优化技术可以提高微调效果。
• 16位精度训练可以进一步降低显存使用,因为模型已经在预训练阶段学习到了丰富的知识表征。
3. 推理阶段:
• 只需要前向计算,不需要反向传播和参数更新,因此显存需求最低。
• 可以使用量化等技术进一步压缩模型尺寸和计算开销。
总之,不同阶段的目标和需求是不同的,需要根据实际情况在性能、精度和计算资源之间进行权衡和优化。
我将大模型在不同阶段的详细显存消耗情况整理成一个更加详细的表格:
| 阶段 | 显存消耗环节 |
| 预训练 |
模型参数: - 大模型通常有数十亿到上百亿个参数 - 每个参数占用4字节(float32)存储空间 - 总参数显存消耗可达数十GB 中间激活: - 前向计算过程中产生大量中间激活值 - 激活数量与模型宽度和输入数据大小相关 - 中间激活显存消耗很大 梯度: - 反向传播时每个参数对应一个梯度 - 梯度总大小与参数量相同 - 梯度显存消耗与参数量相当 优化器状态: - 一些优化器如Adam会保存动量、梯度平方等状态 - 状态信息会增加显存需求 批次大小: - 预训练使用较大批次以加快训练 - 大批次会增加中间激活总量 总的显存消耗: - 预训练阶段总显存消耗可达数十GB到上百GB - 需要高性能GPU硬件支持 |
| 微调 |
数据集大小: - 微调使用的数据集通常较小,显存需求降低 批次大小: - 微调可使用较小批次,减少中间激活 模型结构: - 冻结大部分预训练参数,只训练少量新参数 - 显著减少需要更新的参数量,降低显存需求 优化器: - 可选择不需要保存额外状态的优化器 - 进一步降低显存占用 精度: - 可使用16位浮点数(float16)进行训练 - 相比32位浮点数,显存需求减半 总的显存消耗: - 微调阶段显存消耗通常只需预训练的1/10左右 |
| 推理 |
模型参数: - 需要加载完整模型参数,数量与训练相同 单次输入: - 只需处理单个输入样本,输入数据量小 激活复用: - 可重用激活数据,不需存储多步骤激活 - 大幅减少激活显存消耗 无需保存梯度: - 不需计算和存储梯度信息 无需优化器状态: - 不需保存优化器的状态信息 精度: - 可使用16位浮点数(float16)甚至更低精度量化 - 进一步降低显存需求 总的显存消耗: - 推理阶段通常只需预训练的1/10左右 - 使大模型可部署到资源受限环境 |
总的来说,大模型在预训练阶段需要大量显存资源,而在微调和推理阶段可以大幅降低显存消耗,可以在资源有限的环境中部署使用。
大模型显存消耗计算
推理阶段显存消耗
• 大多数模型参数采用 float32 类型,每个参数占用 4 个字节
• 一个粗略的计算方法是,每 10 亿个参数需要 4GB 显存
• 以 LLaMA 7B 模型为例:
• float32 精度下需要 26.08GB 显存
• 使用 float16/bfloat16 精度可降低至 13.04GB
• 使用 int8 精度可降低至 6.5GB
-
• 使用 int4 精度可降低至 3.26GB
• 推理阶段除了加载模型参数,还需要一些临时变量,如 beam search 等,需要预留一些显存 buffer
我们以 facebook OPT-6.7B 模型为例:
训练阶段显存消耗
• 训练阶段的显存消耗包括:
• AdamW 需要 2 倍模型参数显存
• bitsandbytes优化的AdamW需要 1 倍模型参数显存
• SGD 需要 1 倍模型参数显
• 可以采用一些优化技术如量化、模型切分、混合精度计算等来降低训练阶段的显存消耗
1. 模型参数,计算方法同推理阶段
2. 优化器状态:
3. 梯度,占用与模型参数相同的显存
4. 计算图内部变量,与 batch size 和 sequence length 相关
• 综合上述因素,训练阶段的显存消耗通常是推理阶段的 3-4 倍
• 以 7B 全精度模型为例,训练需要 78GB-104GB 显存目前模型的参数绝大多数都是float32类型, 占用4个字节。所以一个粗略的计算方法就是,每10亿个参数,占用4G显存(实际应该是10^9*4/1024/1024/1024=3.725G,为了方便可以记为4G)。比如LLaMA的参数量为7000559616,那么全精度加载这个模型参数需要的显存为:7000559616 * 4 /1024/1024/1024 = 26.08G。
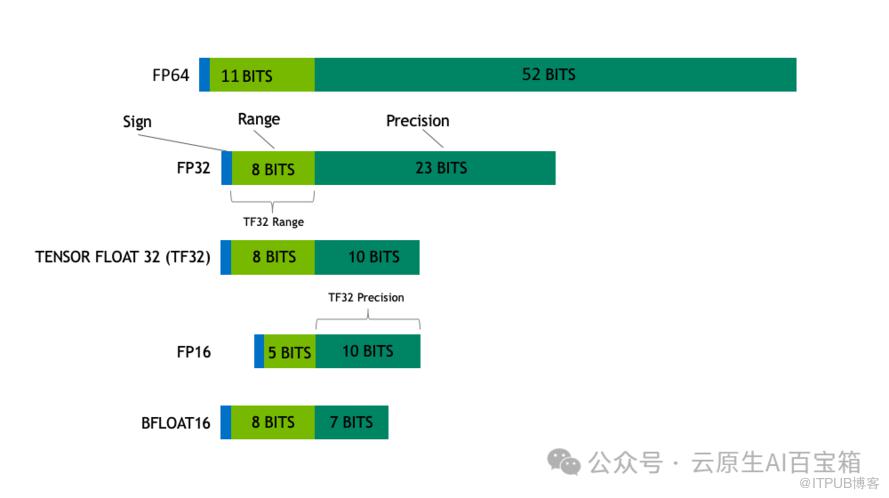
上图参考:A large research of the main training parameters[2]
关于大模型在推理和训练阶段的显存消耗情况整理成一个表格:
| 阶段 | 参数类型 | 显存计算 |
| 推理 | float32 | 参数量 * 4字节 |
| float16/bfloat16 | 参数量 * 2字节 | |
| int8 | 参数量 * 1字节 | |
| int4 | 参数量 * 0.5字节 | |
| 例如:7B-bfloat16 | 70亿 * 2字节 = 14GB | |
| 例如:13B-bfloat16 | 130亿 * 2字节 = 26GB | |
| 训练 | float32 | 参数量 * 4 * 4 (参数+梯度+优化器状态) |
| float16/bfloat16 | 参数量 * 2 * 4 | |
| 例如:7B-float32 | 7 * 4 * 4 = 112GB | |
| 例如:7B-bfloat16 | 7 * 2 * 4 = 56GB | |
| LoRA | - | 原始模型推理显存 + LoRA模型参数显存 |
| 例如:原1024x512,LoRA Rank=8 | 10248 + 5128 |
总的来说,推理阶段的显存消耗主要取决于模型参数的数量和数据类型,而训练阶段除了参数,还需要考虑梯度和优化器状态,显存需求会大大增加。LoRA等技术可以在一定程度上降低训练显存消耗。
Model Memory Calculator
HuggingFace的官方库Accelerate推出了一款创新工具——Model Memory Calculator[3],它是一个在线估算工具,能够直接为用户提供在HuggingFace平台上托管的模型的显存需求预估。
Memory Calculator是由HuggingFace的Accelerate团队开发的在线工具,用户只需输入HuggingFace平台上的模型链接,工具便能够迅速计算出该模型在运行过程中所需的显存大小,包括进行推理操作以及采用Adam算法进行训练时的显存需求。除了支持huggingface库的模型,也还支持timm中的视觉模型。

然而,这种估算方法并非简单地基于最大层级参数进行计算。根据官方说明,Model Memory Calculator提供的结果与实际显存需求之间的误差通常在50MB以内(例如,对于bert-base-cased模型,实际运行需要的显存为413.68MB,而工具估算的结果为413.18MB)。这表明,该工具在实际应用中能够提供相当精确的显存需求预估,为用户在部署和训练大型模型时提供了极大的便利。
引用链接
[1] 大模型消耗的显存简介: https://www.53ai.com/news/qianyanjishu/1604.html[2] A large research of the main training parameters: https://github.com/d8ahazard/sd_dreambooth_extension/discussions/547[3] Model Memory Calculator: https://huggingface.co/spaces/hf-accelerate/model-memory-usage
原文作者:云原生AI百宝箱;如有侵权,请联系管理员删除。

