GpuMall智算云:公网访问实例内服务
在
GpuMa
ll
平台使用该功能可以帮您把实例内的服务暴露到公网进行访问,该服务可以是
Web项目
、
API接口
、
Stable Diffusion web UI
、以及任何监听了
HTTP
、
TCP
端口类型的进程。
GpuMall智算云 | 省钱、好用、弹性。租GPU就上GpuMall,面向AI开发者的GPU云平台
严禁通过该功能提供违规图片、不正当文字等一切违反国家规定、安全等行为;GpuMall平台将实时对该功能图片、文字、网络流量等行为进行检测,一经发现,平台将立即封号且保留通过法律途径追究责任,赔偿平台经营损失。
使用该功能必须进行实名认证后方可使用。#autodl#恒源云#矩池云#算力云#恒源云 实例迁移#autodl 官网#autodi#GpuMall#GPU云#AutoDL#AotuDL 算力云#GpuMall智算云#AI#大数据#算力租赁#大模型#深度学习#人工智能#算力变现
下面将演示该功能的使用流程
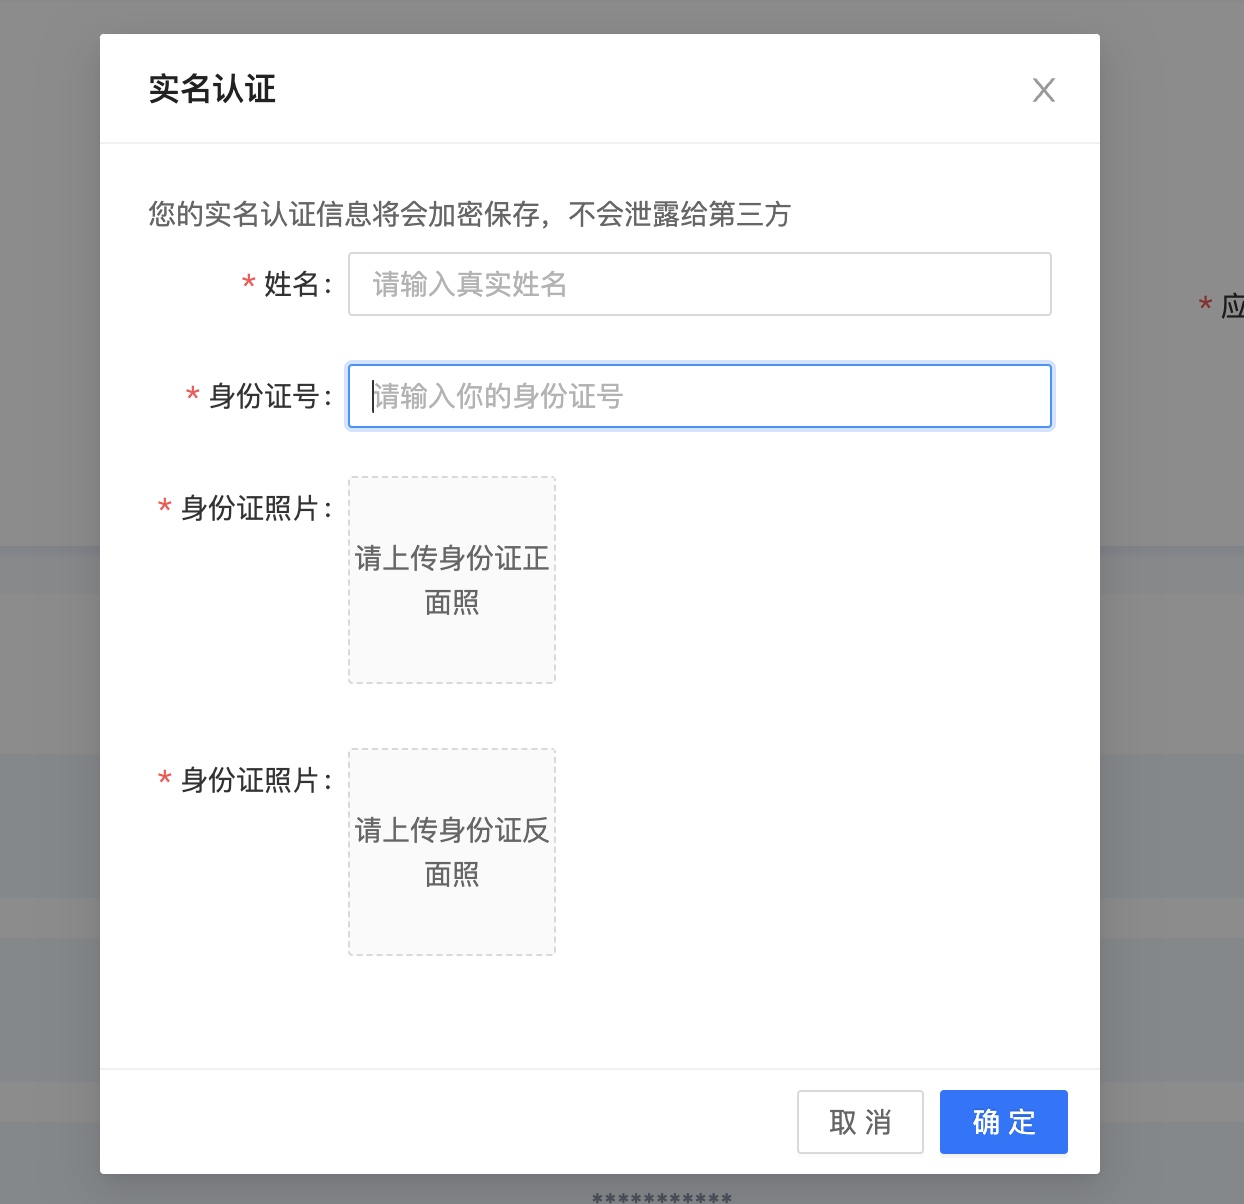
1. 进行实名认证
登录
GpuMall 控制台,点击
账户管理,进行实名认证,实名认证提交后会在
0-3 个工作日通过审核。
2. 创建实例
创建实例过程请参考 创建实例
3. 创建自定义端口
到实例控制台-》找到对应实例-》更多-》创建自定义端口(实例需要在运行状态)

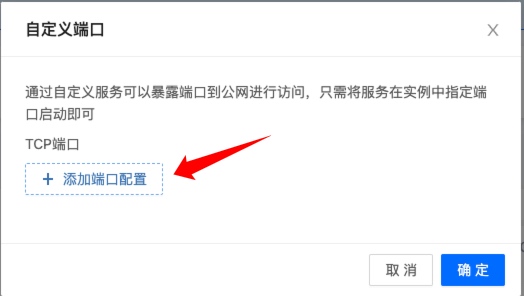
4. 添加自定义端口配置
点击添加端口配置
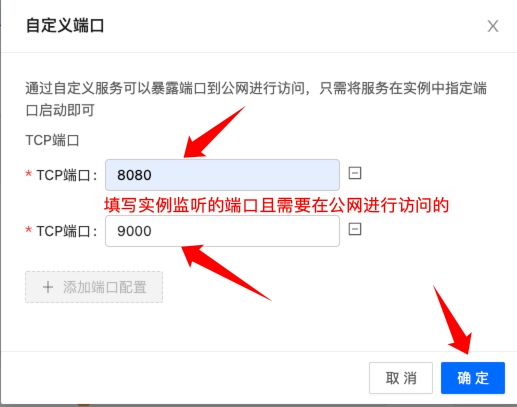
输入您项目在实例中监听的端口
比如,您在实例中的进程监听的端口为
8080,那就在下面图中填写为
8080,如果为
9000 就填写为
9000。
每台实例支持两个对外暴露的端口,然后点击确定
5.填写完成后等待重置端口完成

6.点击自定义端口进行访问
然后点击
自定义端口8080 或者
自定义端口9000 会跳转到对应公网可以访问的
URL,该地址为平台自动分配的公网端口以及地址。

我这里点击
自定义端口8080,浏览器自动跳转到了
http://xxxxxxxx.gpumall.com:60000/。
-
8080端口为实例内所监听的端口 -
http://xxxxxxxx.gpumall.com:60000/为 GpuMall 平台自动分配的公网地址和端口。 -
xxxxxxxx.gpumall.com域名的60000端口会与您实例内的8080端口自动绑定为映射关系。 - 您在浏览器或者公网可以通过
http://xxxxxxxx.gpumall.com:60000访问到您实例中8080端口所运行的服务。
7. 在实例中启动需要对外暴露的服务
如下定义了一个简短的
HTTP服务器,指定监听地址为
0.0.0.0,监听端口为
9000,您的项目如果需要对公网访问,监听地址就必须写为
0.0.0.0,否则网络转发不可达,则无法通过公网访问。
from
 http
.
server
import
 BaseHTTPRequestHandler
,
 HTTPServer


class

SimpleHTTPRequestHandler
(
BaseHTTPRequestHandler
)
:


def

do_GET
(
self
)
:


        self
.
send_response
(
200
)


        self
.
send_header
(
'Content-type'
,

'text/plain'
)


        self
.
end_headers
(
)


        self
.
wfile
.
write
(
b"Hello, This is a custom service provided by GpuMall !"
)


host
=

"0.0.0.0"


port
=

9000


with
 HTTPServer
(
(
host
,
 port
)
,
 SimpleHTTPRequestHandler
)

as
 server
:


print
(
f"Server started at http://
{
host
}
:
{
port
}
"
)


    server
.
serve_forever
(
)
启动该项目
python main.py
然后到控制台点击
自定义端口9000 进行访问即可。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70038680/viewspace-3016185/ ,如需转载,请注明出处,否则将追究法律责任。

