大家好!我是Uncle Ben,微信号:jiaszwx
这几天全国各省市路线公布了2021年高考分数线,我特别关注了一下我的老家—河南的分数线:
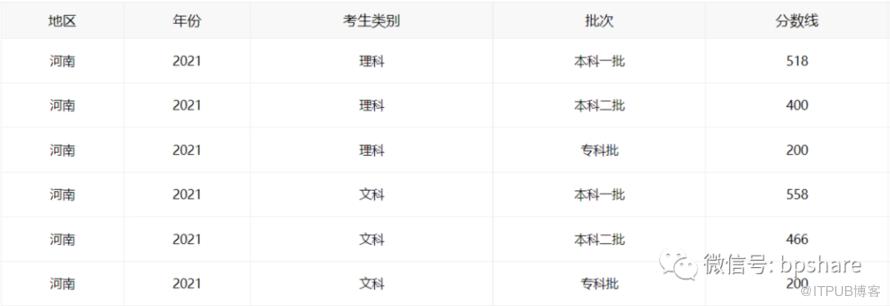
理科一本:518
理科二本:400
看来现在的二本已经不是当年的二本了,现在的二本和三本合并了。好汉不提当年勇,但是我还是想提一下,2005年河南高考理科一本分数线是568,理科二本分数线是523,我考了530多,刚过二本线,高考志愿没报好,被调剂到了省内一所师范学院,后来才知道,我们那个班级,25个人全是调剂过去的。。。
所以,填报志愿很重要,特别是在分数没有出来之前,你就必须要把自愿报了,当年河南就是这样。
前两天我姐给我打电话让我帮着外甥女选个学校,说闺女没发挥好,只考了480,理科。虽然超了河南省公布的理科二本线80分,我搜了一下,在外省也上不了什么好大学。她说看上了一个江苏的一个学院,让帮忙看看选哪个专业。我去这个学校官网看了一下2021年的招生计划,表格有点让人看着极不舒服,我就从网页上复制了一下,保存到了excel里,结果是这个鸟样子:
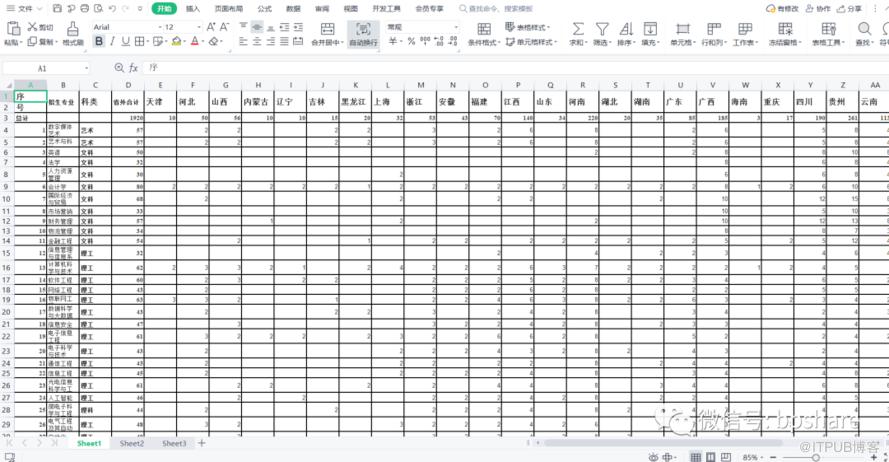
还是不好看,我只想看这个学校在河南的理科招生计划,如果在平时,我就会把这个表格做的漂亮些,删除没用的列,第一行和第二行要恢复合并,然后删除第二行。。。
不过最近在学pandas,那就用pandas来操作一把,和大家分享一下。
环境准备
打开Jupyter Notebook
安装pandas包
pip install pandas
或者参考官网:https://pandas.pydata.org/getting_started.html
导入pandas包
import pandas as pd
查看pandas版本
pd.__version__

#运行结果:
'1.2.5'
读取excel文件
df = pd.read_excel("enrollment_plan.xlsx")
df
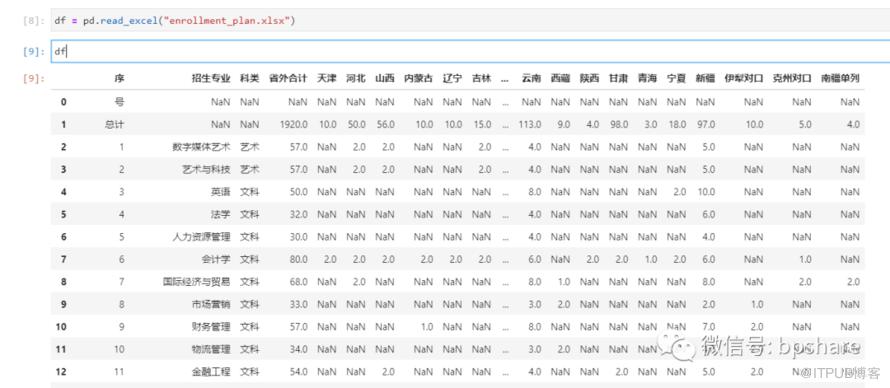
只想看前5行怎么办?简单
df.head(5)
只想看河南省这一列的数据怎么办?简单,直接放入列名即可
df["河南"]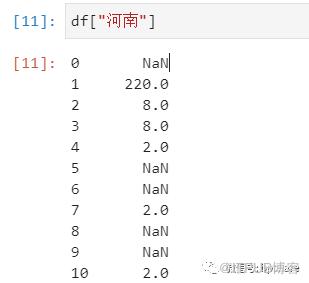
不是我想要的结果,我想看招生专业,科类和河南这3列数据
data = df[["招生专业","科类","河南"]]
嗯,现在感觉好多了,但是我只关心科类是理科的数据,继续筛选
data[data.科类=="理工"]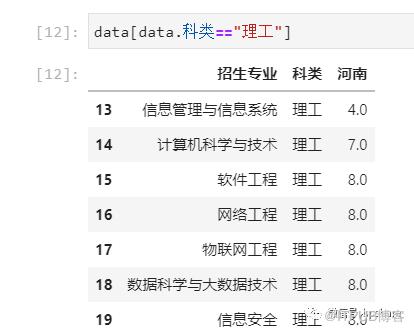
其实理科科类有两个值:理工和理科,所以应该再加上:df.科类=="理科"
data[(data.科类=="理工") | (data.科类=="理科")].sort_values(by="河南")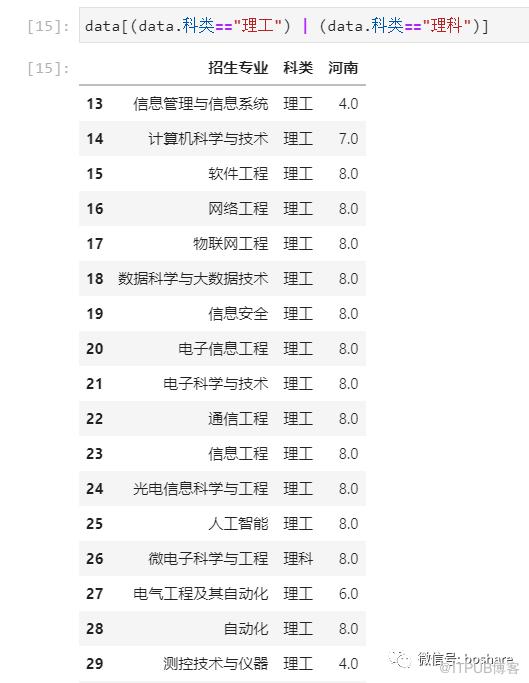
现在看起来好多了,但是最后一列其实是2021年在河南的计划招生人数,这个排序没有按照从多到少或者从少到多排序,那就手动再排一下序:
data[(data.科类=="理工") | (data.科类=="理科")].sort_values(by="河南")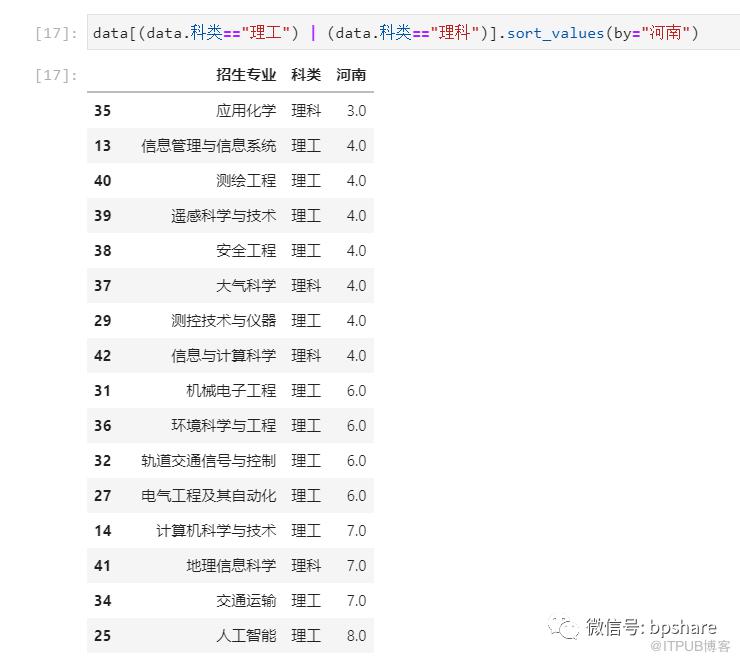
这个排序是升序排列,这也是默认的排序方式,我想按降序排列,如何做呢?简单,再加一个参数:ascending=False
data[(data.科类=="理工") | (data.科类=="理科")].sort_values(by="河南", ascending=False)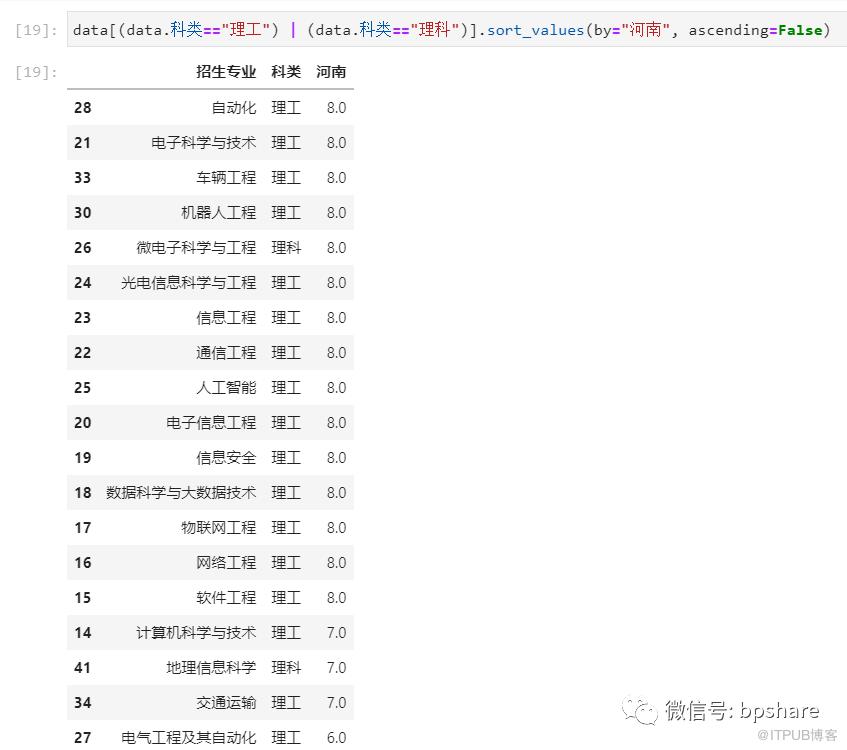
可以看到:自动化,电子科学与技术,车辆工程等专业,每个专业在河南今年都是招8个人,最后面的应用化学专业只招3个人。招生人数小于5人的,就不看了,继续改语句:
data = data[(data.科类=="理工") | (data.科类=="理科")].sort_values(by="河南", ascending=False)data[data["河南"]>=5.0]

和上面排序的结果差不多,但是我们现在只能看到招生5人以上的专业,包括5人。
那一共有多少个专业呢?
data[data["河南"]>=5.0].shape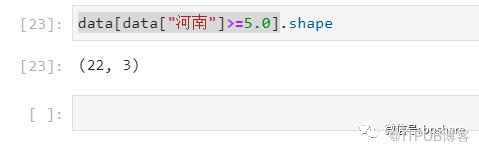
可以看到,该学院在河南招生人数大于等于5个人的专业一共有22个,还不少呢!
然后我就在招生人数比较多的这些专业里,挑选了5个专业,推荐给了我姐,帮助孩子填报志愿,希望孩子能被该院校顺利录取吧!
好了,本次分享就到这里。
觉得还不错?点个👍呗!
原文作者:BPShare;如有侵权,请联系管理员删除。

