最近班里刚学完ElasticSearch,好学的学员就在问和es相似的solr是怎么样的,那侯哥我就和大家说下solr是什么,有什么用,怎么去使用。
一. 什么是solr
1、solr简介
Solr是Apache下的一个顶级开源项目,采用Java开发,它是基于Lucene的全文搜索服务器。Solr提供了比Lucene更为丰富的查询语言,同时实现了可配置、可扩展,并对索引、搜索性能进行了优化。
Solr可以独立运行,运行在Jetty、Tomcat等这些Servlet容器中,Solr 索引的实现方法很简单,用 POST 方法向 Solr 服务器发送一个描述 Field 及其内容的 XML 文档,Solr根据xml文档添加、删除、更新索引 。
Solr 搜索只需要发送 HTTP GET 请求,然后对 Solr 返回Xml、json等格式的查询结果进行解析,组织页面布局。Solr不提供构建UI的功能,Solr提供了一个管理界面,通过管理界面可以查询Solr的配置和运行情况。
2、solr和lucene的区别
Solr和Lucene的本质区别有以下三点:搜索服务器,企业级和管理。Lucene本质上是搜索库,不是独立的应用程序,而Solr是。Lucene专注于搜索底层的建设,而Solr专注于企业应用。Lucene不负责支撑搜索服务所必须的管理,而Solr负责。Solr是Lucene面向企业搜索应用的扩展。
并且lucene更像是一个SDK。有完整的API族以及对应的实现。可以利用这些在自己的应用里实现高级查询(基于倒排索引技术的),Lucene对单机或者桌面应用很实用很方便。但是Lucene,需要开发者自己维护索引文件,在多机环境中备份同步索引文件很是麻烦。而Solr是一个有HTTP接口的基于Lucene的查询服务器,封装了很多Lucene细节,自己的应用可以直接利用诸如 .../solr?q=abc 这样的HTTP GET/POST请求去查询,维护修改索引。
Lucene是提供了搜索的工具包需要自己实现,而solr是基于lucene扩展出来的搜索服务。
二. solr安装配置
1、下载
从Solr官方网站(http://lucene.apache.org/solr/ )下载,根据Solr的运行环境,需要下载;
Solr使用指南可参考:https://wiki.apache.org/solr/FrontPage。/
2、安装
解压solr下载包,如:
在包里的server\solr-webapp\webapp文件夹,将之复制到Tomcat\webapps\目录下,并改成solr

在server\lib\ext中的 jar 全部复制到 Tomcat\ webapps\solr\WEB-INF\lib 目录中
将server\resources\log4j.properties复制到Tomcat\ webapps\ solr\WEB-INF\classes 目录中(如果没有classes则创建)
server\solr\solr.xml和zoo.cfg 目录复制到计算机某个目录下,如E:\solr_home (用于存放slor的所有服务器配置文件)
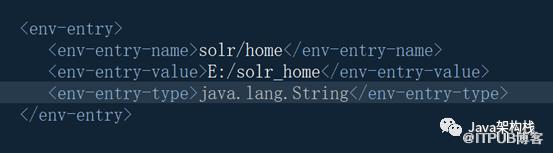
打开Tomcat/webapps/solr/WEB-INF下的web.xml,找到如下配置内容(初始状态下该内容是被注释掉的),修改为你的solr_home路径,这里是E:/solr_home
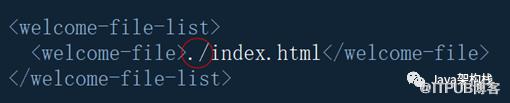
打开Tomcat/webapps/solr/WEB-INF下的web.xml修改项目欢迎页面
在下载包的server\lib 的metrics-开头的jar包,dist目录下solr-dataimporthandler-6.5.1.jar和solr-dataimporthandl er-extras-6.5.1.jar这些jar包复制到目录/webapps/solr/ WEB-INF/lib/下。
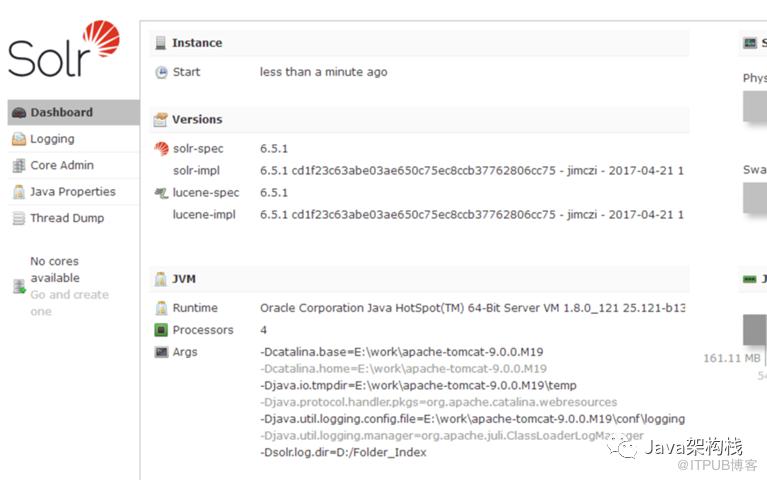
3、Solr界面功能
接下来我们启动startup.bat 启动服务
打开http://localhost:8082/solr/index.html

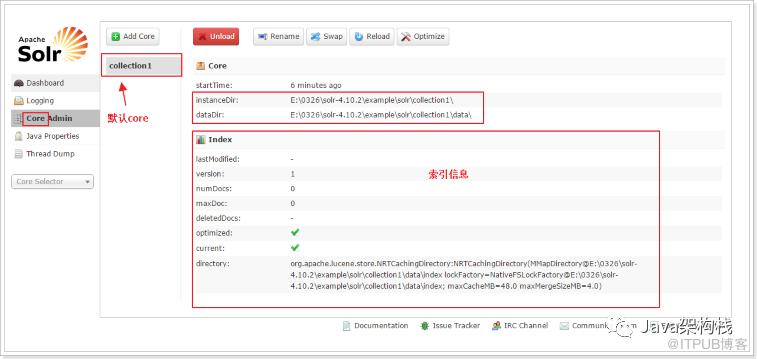
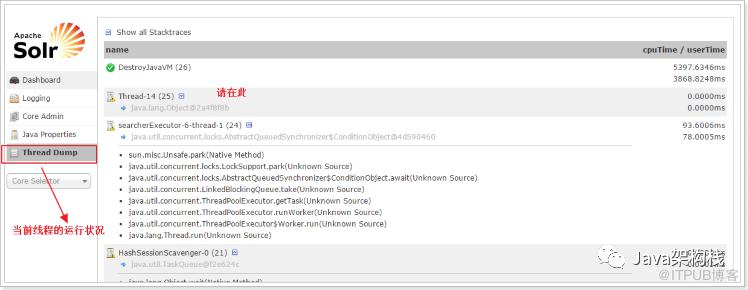

4、错误解决
如果在安装过程中出现如下错误,可以按以下方式进行解决:
出现solr.xml does not exist in e:/xxx cannot start Solr,检查solr_home下是否有slor.xml
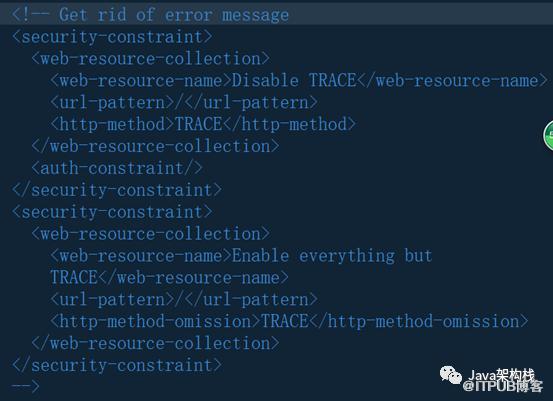
启动tomcat出现403,就注释如下代码,这个配置表示拒绝所有对这个资源的访问,位置在,部署tomcat的solr/WEB-INF/web.xml中
三、安装配置中文分词器
我们顺利启动solr后,接下来我们看看分词器,这个我们在ElasticSearch 里面也有使用过他,正好在一起复习下什么是分词器。
中文分词(Chinese Word Segmentation) 指的是将一个汉字序列切分成一个一个单独的词。分词就是将连续的字序列按照一定的规范重新组合成词序列的过程。
我们知道,在英文的行文中,单词之间是以空格作为自然分界符的,而中文只是字、句和段能通过明显的分界符来简单划界,唯独词没有一个形式上的分界符,虽然英文也同样存在短语的划分问题,不过在词这一层上,中文比之英文要复杂得多、困难得多。
分词器就是将用户输入的一段文本,分析成符合逻辑的一种工具,有不少java开源的分词器,有兴趣请自行百度。
1、配置solr自带分析器
在E:\solr_home下新建文件夹名称随意,这里创建default_code;
把slor中的server\solr\configsets\sample_techproducts_ configs\conf文件复制到,新创建 的default_code文件夹中;
添加索引库重启tomcat,打开solr管理控制台,选择Core Admin-->Add Core,注意:在name和instanceDir中填写,刚才放入conf文件的文件夹名即default_code;
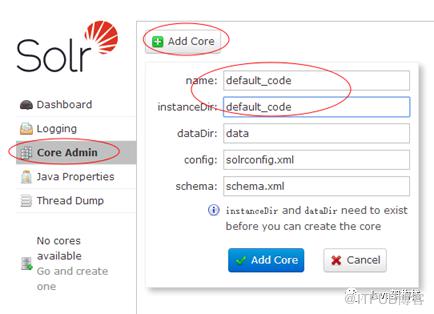
出现如下页面就成功加入solr默认的分词器;
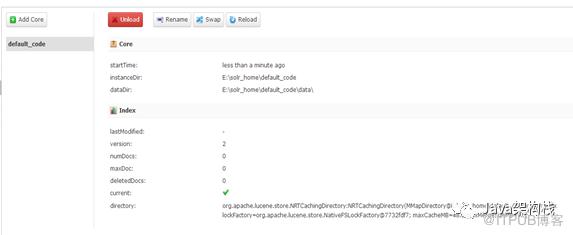
如果出现错误如下,即文件夹名填写错误;

在Code Selector中选择你新增的分词器,在选择Analysis;
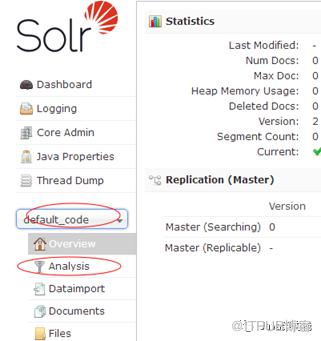
测试。
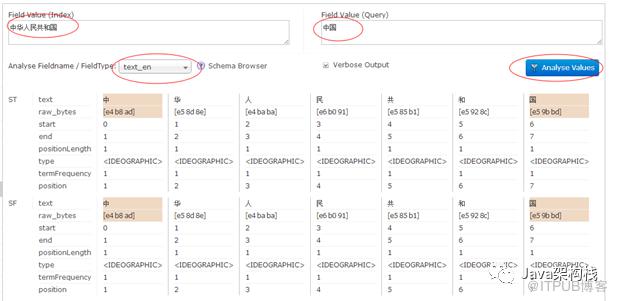
在FieldType,有多种分析器选择,可以在尝试text_en_splitting看看。
总结:
但总的来说默认的分析器并不好用,所以一般不使用他,solr7.0后的中文分词器有听说改进,但本人还没有使用过不做评价,可直接百度solr 分词器找合适的用,中国的如中科院研发的ICTCLAS或者盘古分词,也可以使用IK自己添加字典,可以添加搜狗字典等等足够使用。
2、配置IK(ik-analyzer)分词器
在默认的分析器上添加IK分词器。
IK项目在GItHub但不建议下载,因Ik在2012年就没有更新过,新的solr版本是不对应的,需要修改源码才行,所以建议直接百度 solr x.x ik-analyzer搜索已经修改好的使用,如solr7.x ik-analyzer。
解压下载好的IK,复制文件的 ik-analyzer-solr7x.jar,到tomcat\webapps\ solr\WEB-INF\lib目录下。
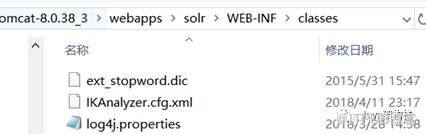
复制IK文件夹里的ext_stopword.dic、IKAnalyzer.cfg.xml 复制到tomcat\webapps\ solr\WEB-INF\classes中。

在IKAnalyzer.cfg.xml同级目录创建mydict.dic文件,存放扩展字典。
打开solr_home\default_code\conf\managed-schema 文件,添加IK分词器配置在最下方添加。
注意:ext_stopword.dic 和mydict.dic必须保存成无BOM的utf-8类型。
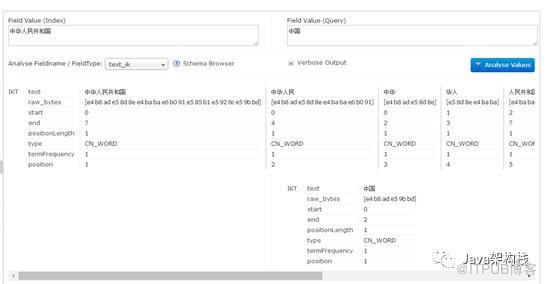
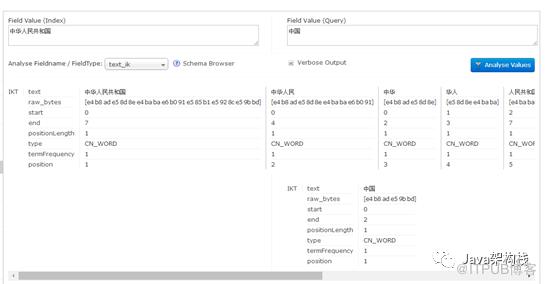
除solr.TextField外还有StringField,IntField等多种域,但只有TextField有分词,可以配置分词器。
重启tomcat 测试
四. 配置业务系统(搜索索引)
1、配置业务系统
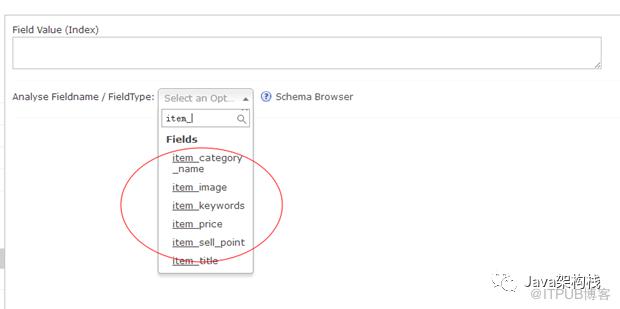
配置业务系统也就是要使用solr实现网站中商品搜索,需要 将mysql数据库中数据在solr中创建索引,和数据库字段对应,在数据库的表字段中找到所需的字段,如:商品id,商品名、商品简介、商品价格、图片等,判断方式可以从在搜索时是否能搜索到商品以及搜索到商品后是否需要字段进行业务处理,如点击搜索到的商品,进入商品详情就需要商品id/。
2、配置业务域
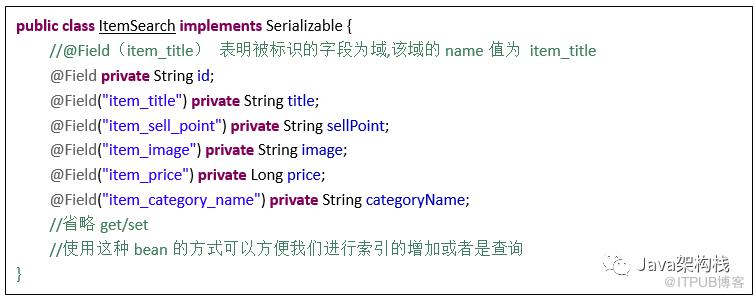
打开solr_home\default_code\conf\managed-schema 文件加入
3、属性说明
3.1 Field
Field相当于Java中的类属性,用户存放数据,因此用户根据业务需要去定义相关的Field(域),一般来说,每一种对应着一种数据,用户对同一种数据进行相同的操作。Field的定义主要是对属性进行赋值。
3.2 type属性
sting 如:long int string text_en,text_ik等,该属性指定域类型,指定该种类所对应的域类型,对应着相应的数据处理方式,可以指定字段解析器。
PS:这些类型可以在solr_home\default_code\conf\managed-schema中找到

3.3 name属性
sting 取名,域名城,域的标示名称,在进行索引、查询所使用名称。
3.4 stored属性
boolean,是否存储,将field域中的内容存储到文档域中。存储的目的,就是为了搜索页面显示取值用的。是否存储可以以是否要展示该域的内容给用户为判断
3.5 indexed属性
boolean,true将分好的词进行索引,索引的目的,就是为了搜索,false就不会对该域进行搜索
3.6 multiValued属性
boolean,是否使用多值,如果使用true,表明单个文档的该属性可能含有多个值
3.7 required 属性
boolean,是否必须填充,如果为true,要求用户必须对该域输入数据。默认为false
3.8 sortMissingFirst/sortMissingLast 属性
boolean,该以该域为基础进行排序时,如果没有数据,则排序到最前或者最后
3.9 default 属性
boolean,给该域设置一个默认值,如果用户没有对该属性进行赋值时,该域将填充一个默认值。

3.10 CopyField(复制域)
复制域的作用在于将某一个Field中的数据复制到另一个域中其用处:即把本来需要搜索的多个域的值集中在一个域中,加快搜索速度,如:当一篇标题如果在标题与正文中都有相关的关键词,当用户并不知道关键词在哪一个域中时,可以将标题域与正文域复制到复制域中,这样可以通过对一个复制域建立索引可以做到对标题域索引的搜索能力。
3.11 maxChars属性
int,复制域的最大长度。

4.重启tomcat
五. 使用solrj 客户端
终于我们完成了solr的配置,还差最后一步,让我们大JAVA和搜索引擎的Solr关联起来使用,那首先就要在项目内加入solr的依赖
1、使用Maven导入jar

2、操作solrj
2.1 添加索引
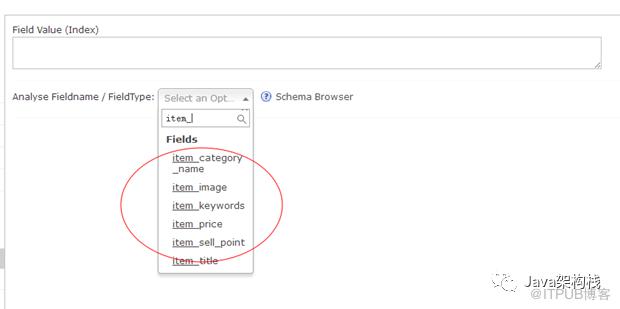
2.2 修改索引
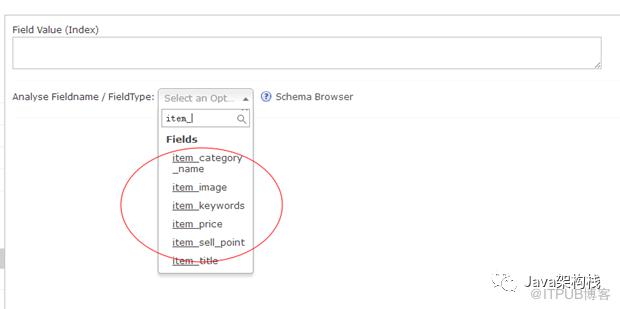
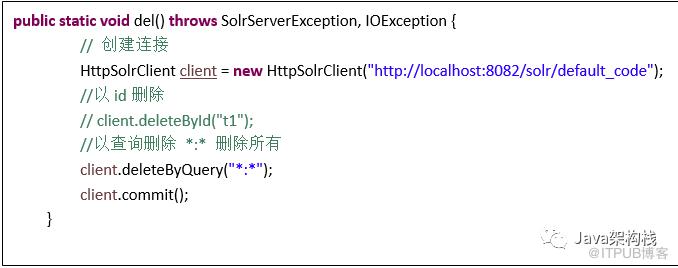
2.3 删除索引
2.4 查询索引

3、设置Field域的实体类
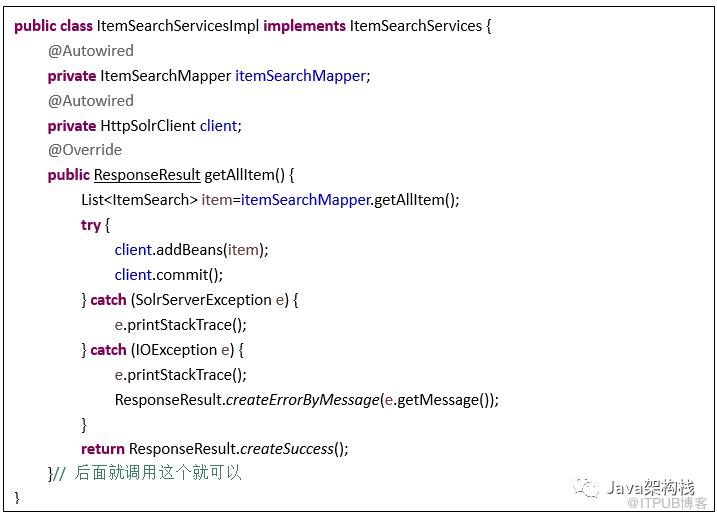
4、从数据库中把所需数据导入的索引库
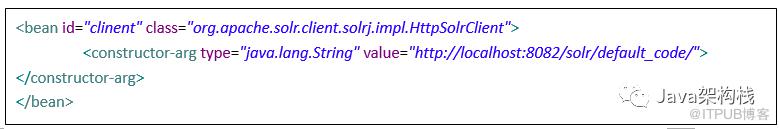
4.1 spring.xml中配置HttpSolrClient
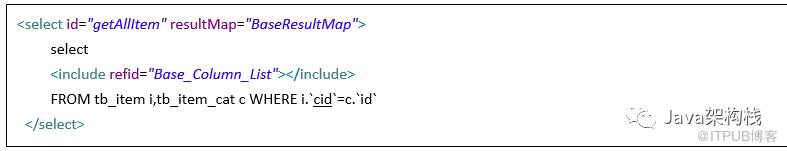
4.2 编写查询语句mapper.xml
4.3 编写services
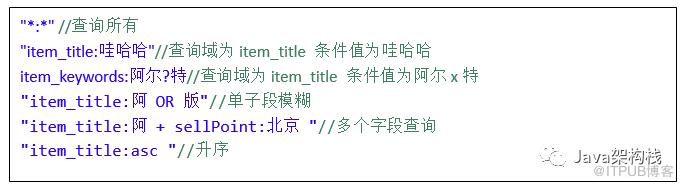
5、查询条件
5.1 常用查询参数
参数 |
描述 |
defType |
指定用于处理查询语句(参数q的内容)的查询解析器,eg:defType=lucene |
sort |
指定响应的排序方式:升序asc或降序desc.同时需要指定按哪个字段进行排序。eg: sort=price desc,score asc |
start |
指定显示查询结果的开始位置,默认是0 |
rows |
指定一次显示多少行查询结果,默认是10 |
fq |
指定用于对查询结果进行过滤的过滤器(也看作是一种query) eg: fq=price:[100 To *]&fq=setction:0 |
fl |
指定查询结果中返回的字段,该字段的stored=”true”或docValues=”true” ,eg:fl=id,title,product(price, popularity) |
debug |
指定查询结果中携带额外的调试信息:时间信息debug=timing,“explain”信息debug=results,所有调试信息debug=query |
explainOther |
Allows clients to specify a Lucene query to identify a set of documents. If non-blank,the explain info of each document which matches this query, relative to the main query (specified by the q parameter) will be returned along with the rest of the debugging information. |
timeAllowed |
指定查询处理的时间,单位毫秒。如果查询在指定的时间未完成,则只返回部分信息 |
segmentTerminateEarly |
Indicates that, if possible, Solr should stop collecting documents from each individual (sorted) segment once it can determine that any subsequent documents in that segment will not be candidates for the rows being returned. The default is false. |
omitHeader |
当设为true时,返回结果不包含头部信息(例如请求花费的时间等信息),默认是false |
wt |
执行响应的输出格式:xml或json等 |
logParamsList |
指定哪些参数需要写入log, eg:logParamsList=q,fq |
echoParams |
指定响应头部包含哪些参数,取值为none/all/explicit(默认值) |
5.2 标准查询参数
参数 |
描述 |
q |
使用标准查询语法定义的查询语句,必填 |
q.op |
查询表达式的默认操作符,取值AND或者OR |
df |
默认查找的字段 |
5.3 标准查询操作符
参数 |
描述 |
: |
指定要查找的字段,比如:title:“The Right Way” AND text:go |
? |
匹配单一字符,比如:te?t匹配test/text |
* |
匹配0或多个字符,比如:tes*匹配test/testing/tester |
~ |
基于编辑距离的模糊查询,比如:roam~匹配roams/foam/foams/roam. roam~1(指定距离必须是1)匹配roams/foam,但不会匹配foams |
~n |
邻近查询,查找相隔一定距离的单词,比如:”jakarta apache”~10(相隔10个单词) |
to |
范围查询,{}不包含边界,[]包含边界,比如:title:{Aida TO Carmen} |
^ |
加权因子,比如:jakarta^4 apache 查找结果中jakarta更相关 |
^= |
指定查询语句的score得分为常量,比如:(description:blue OR color:blue)^=1.0 text:shoes |
AND(&&) |
运算符两边的查询词同时出现 比如:”jakarta apache” AND “Apache Lucene” |
OR |
运算符两边的查询词至少一个出现, 默认运算符,比如 “jakarta apache” jakarta 等价于 “jakarta apache” OR jakarta |
NOT(!) |
运算符后面的查询词不出现,比如”jakarta apache” NOT “Apache Lucene” |
+ |
运算符后面的查询词出现(known as the “required” operator),比如+jakarta lucene查询必须包含jakarta,而lucene可以出现可不出现 |
- |
不能包含运算符后面的查询词 “jakarta apache” -“Apache Lucene” |
[] |
包含范围边界 |
{} |
不包含范围边界 |
solr应用比较深,这里只是solr的基本使用,其本身的Query Parer是短语查询,简单的说查询条件必须要比较准确才会精确找到,但这个是可以自定义的,除此以外还有很多配置可以处理如字典等等。
关于slor听明白的同学,评论区回复“666”!
精选第一名,可以领取办公鼠标垫一个哦!

点击【阅读原文】,全套入门Java资料免费学!
原文作者:Java架构栈;如有侵权,请联系管理员删除。

